Kurz zusammengefasst
- Microsoft gibt an, dass MAI Code 2 96 % der Programmierleistung von Claude Opus 5.5 zu 5 % der Kosten liefert, wobei der Vergleich Aktionspreise einschließt.
- Sein neues Cybersicherheitsmodell erzielte laut Microsofts Bewertungen 92,3 % gegenüber 91,5 % von GPT-6 Astra bei einem Test zur Erkennung von Schwachstellen.
- MAI Image 2.7 führte eine unabhängige Rangliste für Bildbearbeitung an, während unsere schnellen Vergleiche seinen Realismus, seine Kreativität und seine allgemeine Ausgabequalität bevorzugten.
Microsoft hat am Dienstag auf seiner Ignite-Konferenz eine neue Reihe spezialisierter KI-Modelle vorgestellt und damit einen direkten Angriff auf Anthropic und OpenAI in den Bereichen Programmierung, Cybersicherheit und Bildgenerierung gestartet.
Anstatt zu versuchen, einen einzigen Chatbot zu bauen, der alle in allem übertrifft, setzt es auf Modelle, die darauf trainiert sind, bestimmte Aufgaben zu deutlich geringeren Kosten zu erledigen.
Die größte Behauptung betrifft MAI Code 2, von dem Microsoft sagt, dass es 96 % der Leistung von Claude Opus 5.5 bei gängigen Unternehmensprogrammieraufgaben für nur 5 % der Kosten liefert. Es beansprucht außerdem 98 % der Leistung von GPT-6.1 Sol zu 40 % des Preises.
Diese Zahlen sind der Durchschnitt der Ergebnisse aus vier Bewertungen, die sich auf die praktische Softwareentwicklung konzentrieren, einschließlich der Fehlerbehebung im Code und der Durchführung von Änderungen über mehrere Dateien hinweg. Microsoft führte drei der Tests auf seiner eigenen Bewertungsplattform durch, verwendete für den vierten externe Ergebnisse und berechnete die Kosten von MAI Code 2 unter Verwendung eines Rabatts von 50 %.
Ein leichteres Code 2 Flash-Modell zielt auf Routinekorrekturen und schnelle Bearbeitungen ab, wobei Microsoft eine Leistung vergleichbar mit Claude Haiku 5.5 zu 20 % des Preises behauptet, also extrem günstig, ohne Qualitätseinbußen. Beide Codierungsmodelle sind bereits in GitHub Copilot enthalten, wodurch Microsofts eigene Technologie direkt in ein Produkt einfließt, das stark auf externe KI-Anbieter angewiesen war.
Sicherheit ist ein weiteres Ziel. Microsoft gibt an, dass MAI Cyber 2 Flash bei 92,3 % der von CyberGym-E2E bewerteten Aufgaben zur Entdeckung von Schwachstellen erfolgreich war, verglichen mit 91,5 % für GPT-6 Astra, bei weniger als 2 % der Kosten pro Aufgabe. CyberGym-E2E bewertet den Prozentsatz der Software-Sicherheitsuntersuchungen, die eine KI erfolgreich abschließt; Microsoft schloss 92 von 905 Aufgaben aus, nachdem es Überschneidungen zwischen ihrem Quellmaterial und seinen Trainingsdaten festgestellt hatte.
Das Unternehmen hat noch keinen direkten Vergleich mit OpenAIs eingeschränktem GPT-6 Cyber-Modell veröffentlicht. Sein Sicherheitssystem wird Mitte Dezember beginnen, ein älteres MAI-Modell für berechtigte MDASH-Kunden zu ersetzen, und baut dabei auf dem Ansatz zur Schwachstellensuche auf, über den Decrypt zuvor berichtet hat.
In der KI kann David auch Goliath besiegen
Kann ein kleines Modell ein großes besiegen? Auf jeden Fall – in bestimmten Fällen.
Ein Allzweckmodell muss lernen, Gedichte zu schreiben, Physik zu erklären, Software zu debuggen und Fragen zu fast allem zu beantworten. Ein für Codierung oder Cyberverteidigung optimiertes Modell kann mehr seines Trainings- und Rechenbudgets für die Muster aufwenden, die für diese Aufgabe relevant sind, anstatt dieselbe Wissensbreite in jede Anfrage mitzunehmen.
Das macht kleinere Modelle nicht universell intelligenter. Es kann sie schneller und wirtschaftlicher machen, wenn die Aufgabe klar definiert ist, insbesondere in einem Geschäft, in dem dieselbe Arbeit tausendmal am Tag ausgeführt wird.
Ein Sicherheitsscanner, der jede neue Codeänderung analysiert, braucht kein teures Frontier-Modell, um die Geschichte des Römischen Reiches zu erklären. Wenn ein Modell seine volle Leistung darauf konzentrieren kann, Python-Code zu generieren, ist es sinnvoller, für seine API-Aufrufe zu bezahlen, anstatt ein supermächtiges generalistisches Modell zu verwenden.
Spezialisierung kann auch das gesamte System rund um das Modell verbessern: die Werkzeuge, die es aufruft, die Prüfungen, die seine Antworten verifizieren, und die Daten, die zu seiner Verfeinerung verwendet werden. OpenAI hat einen verwandten Ansatz mit seinen Mini- und Nano-Modellen verfolgt, bei dem günstigere Arbeitskräfte Routineaufgaben erledigen, während größere Systeme die Ausnahmen bewältigen.
Es gibt jedoch Kompromisse. Microsofts eigene Dokumentation besagt, dass Code 2 noch nicht für grundlegende wissenschaftliche Forschung oder sehr lang laufende autonome Aufgaben optimiert ist. Und Anthropic konkurriert mit Haiku im günstigeren Marktsegment, nicht nur mit seinen Premium-Opus-Modellen, sodass Microsoft in ein Rennen eintritt, das seine Konkurrenten bereits verstehen.
MAI Image ist die überzeugendere Demonstration
Microsofts MAI Image 2.7 könnte der klarste Beweis dafür sein, dass seine Strategie funktioniert. In unseren schnellen Direktvergleichen übertrafen seine Bilder GPT Image und Googles Nano Banana in puncto Realismus, Kreativität und Gesamtqualität.
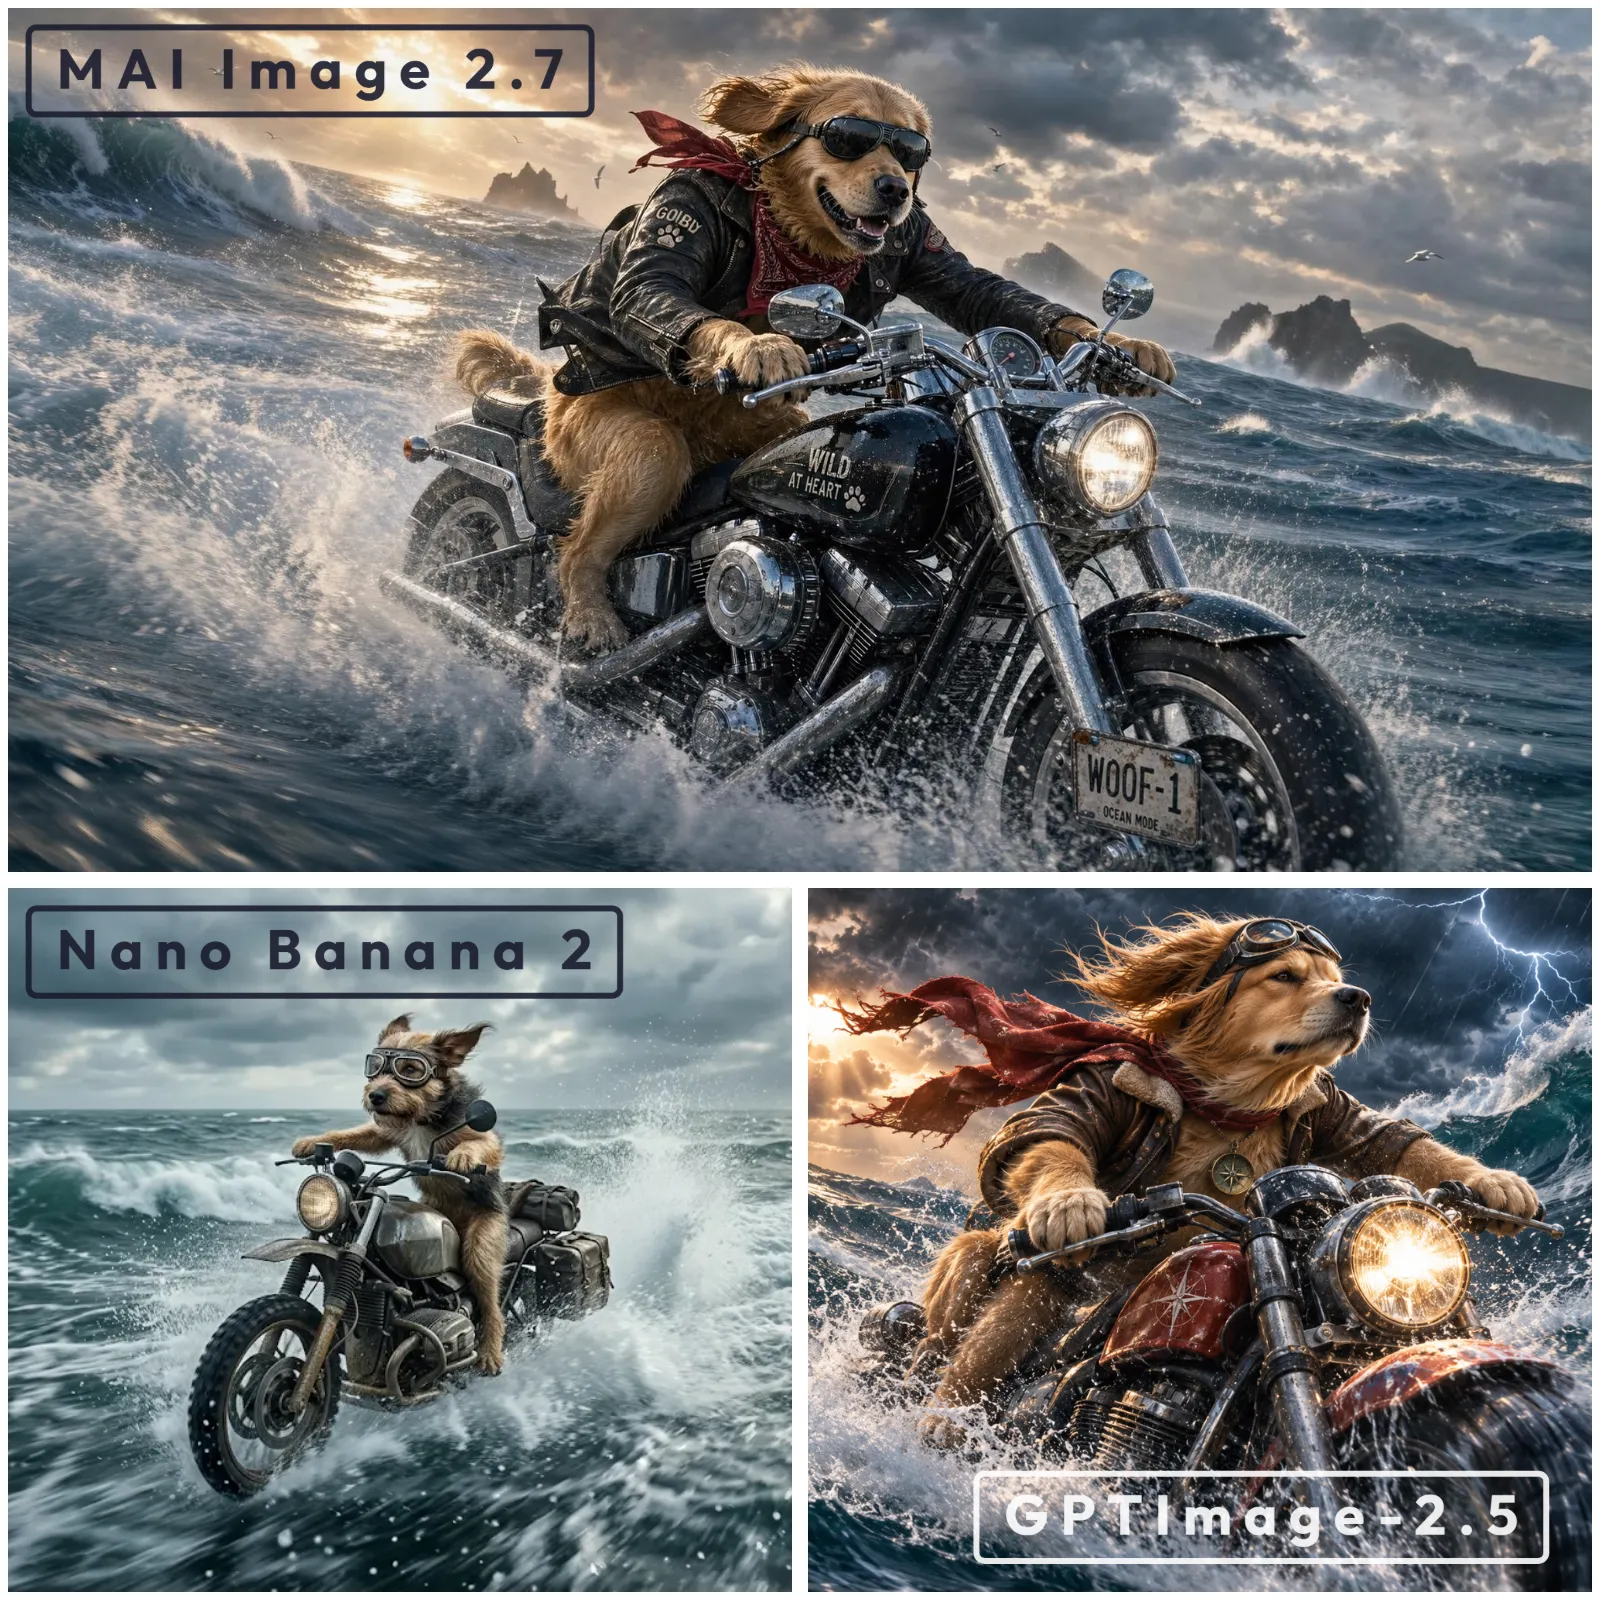
Dies waren nur erste Eindrücke, basierend auf einigen wenigen Generierungen, aber sie decken sich weitgehend mit seiner starken Platzierung in unabhängigen Ranglisten.
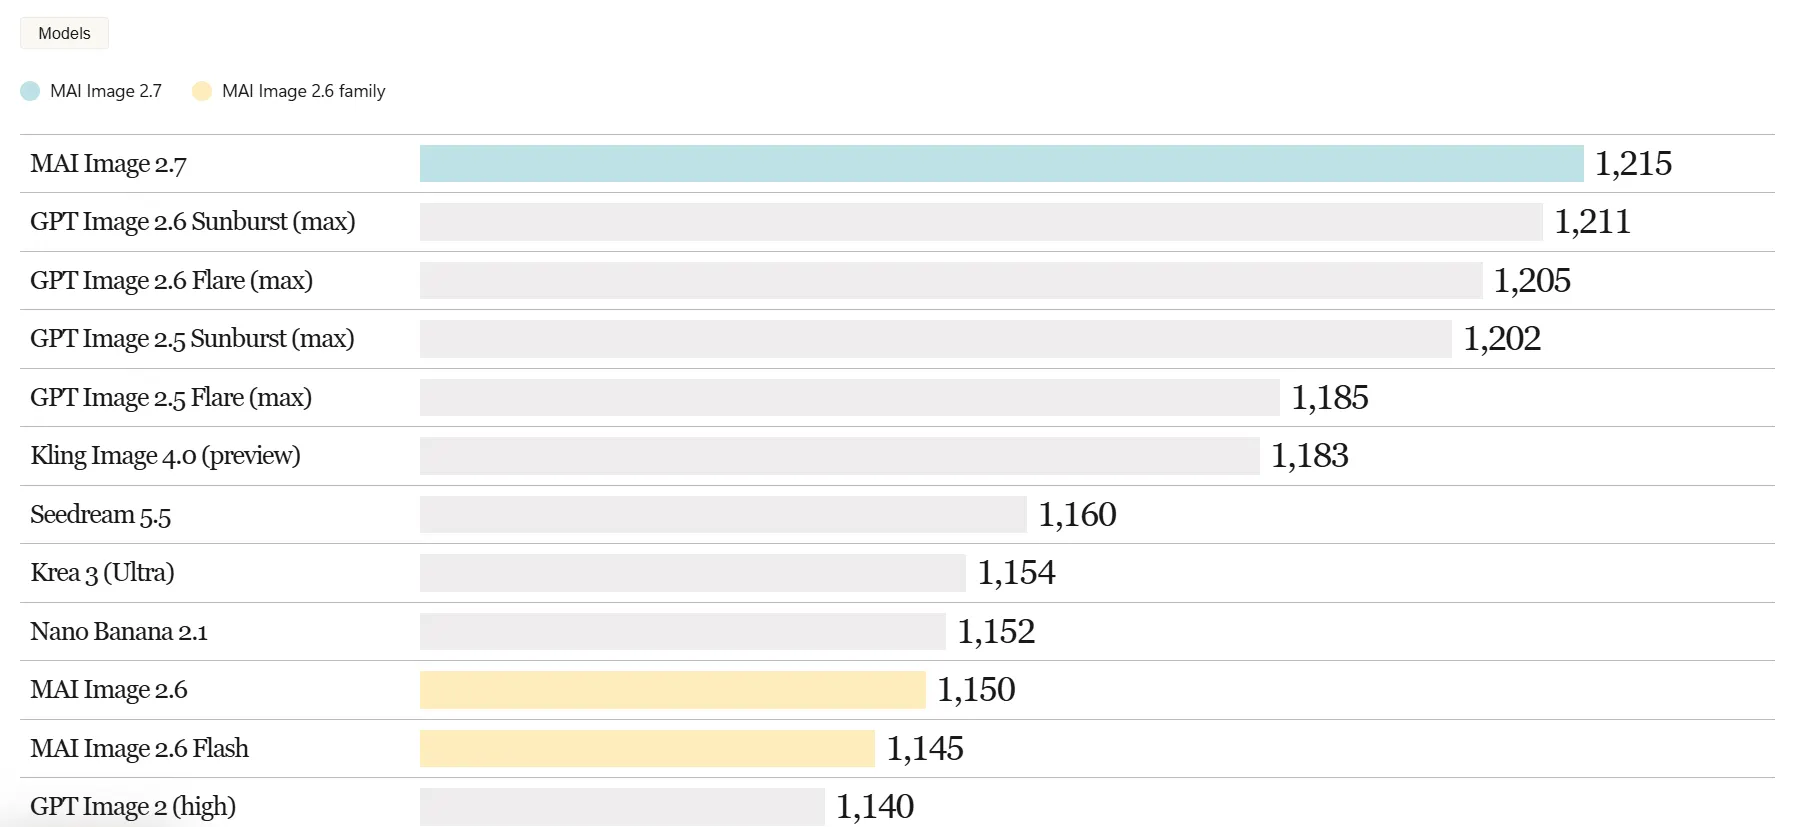
Beim Bildbearbeitungstest von Artificial Analysis, bei dem Menschen zwischen anonym generierten Bearbeitungen wählen und diese Präferenzen in eine Elo-Bewertung umgewandelt werden, führt MAI Image 2.7 derzeit mit 1.215 Punkten gegenüber GPT Image 2.6 Sunburst mit 1.211.
Der Abstand von vier Punkten ist klein genug, dass sich ihre angegebenen Unsicherheitsbereiche überschneiden; die separate Rangliste zur Text-zu-Bild-Generierung, die mit derselben präferenzbasierten Methode bewertet wird, platziert Microsoft auf dem vierten Platz.
Die Preisgestaltung ist schwerer zu ignorieren. Microsoft nennt etwa 35 US-Dollar pro 1.000 Bilder für MAI Image 2.7 und 10 US-Dollar für die Flash-Version, gegenüber rund 211 US-Dollar für GPT Image 2.6 Sunburst bei maximaler Qualität im Vergleich von Artificial Analysis. Googles Nano Banana 2.1 liegt dort bei etwa 34 US-Dollar pro 1.000, während Nano Banana Pro bei etwa 134 US-Dollar liegt; die tatsächlichen Rechnungen hängen vom Anbieter, der Auflösung und den Einstellungen ab.
Unser früherer Test von MAI Image 2 ergab einen hervorragenden Realismus, aber frustrierende Einschränkungen bei der Bearbeitung und den Ausgabeformaten. Die neuere Version fügt interaktive Bearbeitung über Microsofts Canvas-Arbeitsbereich, transparente Hintergründe und einen breiteren Zugang über Foundry hinzu, obwohl Bildqualität und ein nutzbares Produkt immer noch zwei verschiedene Dinge sind. Allerdings ist das Modell auch ziemlich zensiert.