Solo han pasado dos meses desde el lanzamiento de GPT-6 Astra, y GPT-6.2 Astra ya se vislumbra en el horizonte.
Sin embargo, la industria de la inteligencia corpórea aún no se ha recuperado del golpe anterior.
Todo sucedió tan repentinamente que tomó a la gente por sorpresa.
Todavía recuerdo que cuando GPT-6 Astra salió por primera vez, un grupo de profesionales de la IA corpórea quedó atónito. En particular, los ingenieros que trabajaban en el preentrenamiento en primera línea temían todos por sus empleos.
Recientemente, han circulado noticias en la industria de que algunas empresas de inteligencia corpórea han comenzado a recortar puestos de algoritmos.
Capacidades que antes requerían una gran cantidad de datos, cómputo e ingenieros de algoritmos para
Diandian
pulir, GPT-6 Astra puede demostrar en algunas pruebas sin post-entrenamiento adicional para tareas específicas.
¿Cómo se supone que la gente va a competir ya???
Un ingeniero que trabaja en el desarrollo de modelos en una empresa de robótica dijo a Quantum位:
En comparación con el hecho de que la inteligencia corpórea aún no ha visto un avance a nivel de nuevo paradigma, los grandes modelos generales representados por Astra están golpeando verticalmente la industria corpórea a través de la codificación. Ese es el verdadero impacto.
La presión que trae el impacto no proviene enteramente de Silicon Valley.
En comparación con el progreso tecnológico de las empresas extranjeras de grandes modelos como OpenAI, las empresas corpóreas nacionales son más sensibles a los próximos movimientos de los actores locales de grandes modelos.
Kimi
,
DeepSeek
, Zhipu... Estos nombres se están convirtiendo en variables a las que la industria corpórea tiene que prestar atención.
En la recientemente popular evaluación RoboDojo, cada vez más equipos también han comenzado a intentar introducir grandes modelos generales (como GPT-6 Astra) en sus propios sistemas robóticos, con una fuerte generalización y capacidades asombrosas.
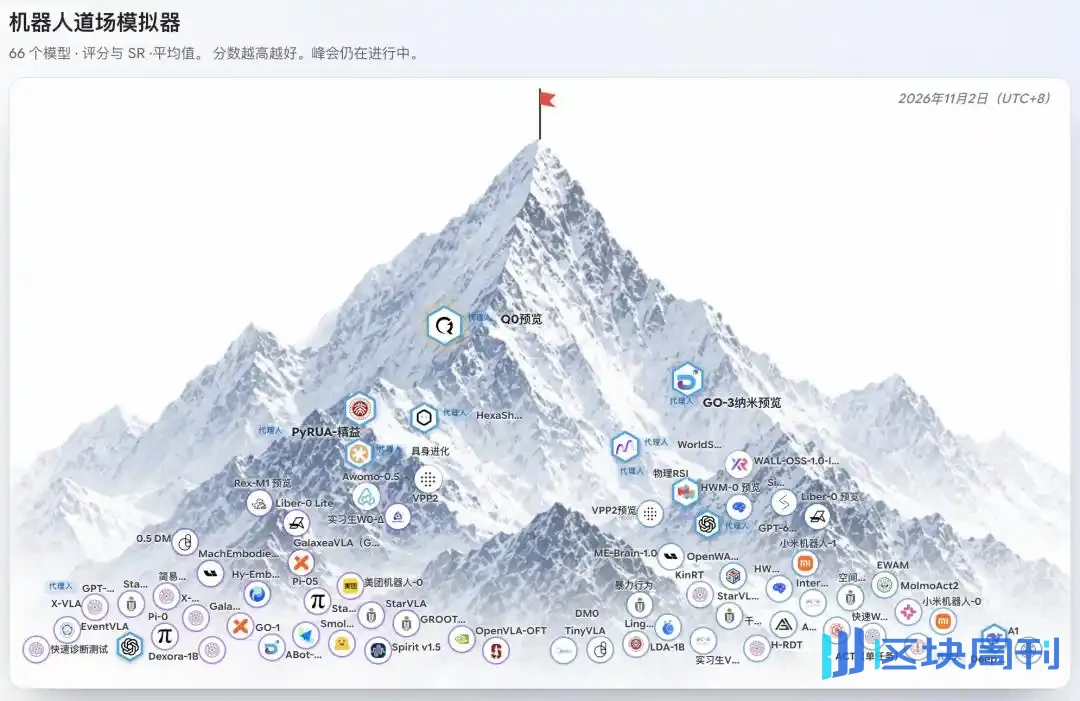
Según Chen Tianxing, primer autor del benchmark de evaluación RoboTwin/RoboDojo, algunos equipos que originalmente insistían en entrenar modelos fundacionales corpóreos nativos ahora también están comenzando a presentar soluciones que combinan tecnologías como Robot-Use-Agent (RUA), utilizando grandes modelos generales para completar tareas robóticas.
El efecto es bastante directo. Los modelos que originalmente solo obtenían 20 o 30 puntos pueden, tras combinar soluciones relacionadas con Astra, mejorar sus puntuaciones de evaluación a 50 o 60 puntos.
Las puntuaciones de la tabla de clasificación han subido, pero las empresas corpóreas solo tienen un pensamiento en mente:
¿Sigue siendo necesario desarrollar modelos internamente... (llanto)

Como estudiante de doctorado en la dirección de inteligencia encarnada en el MMLab de la Universidad de Hong Kong, Chen Tianxing participó en la redacción del informe de evaluación y valoración de RoboDojo sobre GPT-6 Astra (en adelante, el "informe").

△El informe de evaluación temprana del equipo de RoboDojo sobre GPT-6 Astra
Recordando un día de mediados de septiembre, Chen Tianxing le dijo a Quantum位 que cuando sus socios le trajeron los resultados de las pruebas uno tras otro, se quedó atónito durante varios segundos:
Se puede ver que su impacto en la reconstrucción 3D, las matemáticas y diversos otros campos no tiene precedentes.
Aterrador, realmente bastante aterrador.
Todos quedaron atónitos por GPT-6
"Los modelos internos de inteligencia encarnada todavía suman 0,1 y 0,2 puntos por encima de 80 puntos, mientras que GPT-6 Astra ya ha saltado de 80 puntos a 90 puntos de una sola vez".
Esta es una vívida analogía que Chen Tianxing dio al revisar esta evaluación.
Lo que es aún más llamativo es que en algunas pruebas, Astra ni siquiera se sometió a un post-entrenamiento adicional para tareas específicas, ni utilizó demostraciones de tareas; basándose únicamente en instrucciones de lenguaje, fue capaz de completar bastantes tareas de manipulación robótica.
Lo que más le sorprendió fue que Astra demostró repentinamente tres capacidades que los modelos encarnados anteriormente tenían que centrarse en superar.
La primera es ICL (In-Context Learning, aprendizaje en contexto).
En pocas palabras, permite que un robot aprenda rápidamente una nueva tarea mediante una pequeña cantidad de información contextual.
Por ejemplo, si una persona graba un video de sí misma realizando una operación y añade descripciones de texto, el robot puede entender cómo lo hizo la persona e intentar que el brazo robótico lo reproduzca.
En julio de este año, ICL seguía siendo una dirección de investigación bastante popular en la comunidad de IA encarnada. El paradigma común es demostrar operaciones humanas y hacer que el robot las imite para adquirir nuevas habilidades, el llamado aprendizaje en contexto de un solo intento (one-shot in-context learning).
Pero la comunidad descubrió que proporcionar a Astra demostraciones de imágenes o texto podía producir una tasa de éxito mayor que no proporcionar demostraciones.
Aún más sorprendente fue su capacidad de adaptación en línea. Los investigadores cambiaron deliberadamente la vista de la cámara y el sistema de coordenadas de acción, y Astra fue capaz de ajustar su estrategia tras varias rondas de intentos basándose en los resultados reales de ejecución, completando con éxito la tarea.
En otras palabras, no solo puede entender el contexto, sino también corregirse mientras actúa.
A juicio de Chen Tianxing, esto se debe a que los modelos generales poseen en sí mismos una fuerte capacidad de comprensión contextual. Durante una conversación normal, puede recordar el historial de conversación previo; dado un video, también puede entender la relación entre el contenido del video y el texto.
Transferir estas capacidades a la manipulación robótica significa que el problema de ICL, que originalmente requería investigación dedicada, de repente tiene una solución lista para usar.
La segunda es la generalización OOD (Out-of-Distribution, fuera de distribución) y la capacidad de corrección.
En entornos reales, los robots encuentran fácilmente situaciones fuera de sus datos de entrenamiento.
Por ejemplo, un brazo robótico está a punto de agarrar una taza, pero la taza es golpeada repentinamente y su posición cambia.
Un modelo que depende excesivamente de los datos de entrenamiento podría ejecutar todavía a lo largo de la trayectoria original y acabar agarrando el aire.
Sin embargo, Astra puede reajustar sus acciones en función de la información visual modificada e intentar agarrar el objeto.
Parece una acción mínima, pero detrás de ella se esconde la cuestión de si un robot puede adaptarse al mundo real.
Después de todo, en el mundo real nadie es responsable de colocar cada taza de vuelta en su posición de entrenamiento.
La tercera es la manipulación de vocabulario abierto.
Esta capacidad implica la alineación entre el lenguaje y las acciones.
Por ejemplo, si un usuario formula una solicitud de operación de diferentes maneras, el robot aún puede entenderla y ejecutarla.
En el pasado, a menudo había una desconexión entre la comprensión del lenguaje y la ejecución de acciones, y los modelos encarnados necesitaban un post-entrenamiento para tareas específicas para lograr mejor la alineación.
Pero Astra ha demostrado capacidades más sólidas en este sentido. En algunas pruebas, incluso sin post-entrenamiento adicional ni demostraciones para tareas específicas, pudo completar bastantes tareas de manipulación robótica basándose únicamente en instrucciones de lenguaje.
Desde la perspectiva de Chen Tianxing, las tres anteriores fueron en su momento propuestas técnicas de gran relevancia en el campo de la IA encarnada, y en el pasado cada una podría haberse presentado como una historia de startup independiente.
Ahora, Astra ha resuelto las tres a la vez, lo que supone un impacto casi explosivo para la ruta original de I+D de modelos encarnados.

△Los resultados de las pruebas zero-shot en el benchmark RoboDojo-Sim no significan que Astra ya pueda completar de forma estable estas tareas en robots reales.
En el informe, el equipo de RoboDojo señaló que las pruebas de Astra en máquinas reales se suspendieron en su momento debido a problemas de seguridad.
Las puntuaciones altas en una clasificación de simulación aún no pueden equipararse directamente con la productividad en el mundo real.
Pero ya es suficiente para que las empresas de IA encarnada reexaminen sus inversiones pasadas en I+D.
¿Por qué un modelo grande general que originalmente no fue creado para la manipulación robótica puede acercarse rápidamente a capacidades que las empresas de IA encarnada han acumulado durante años?
En cierto modo, es un éxito no intencionado.
Aunque los modelos grandes generales no comenzaron a aprender robótica desde cero, entraron en el campo de la robótica llevando consigo una serie de capacidades acumuladas durante el preentrenamiento a gran escala, como lenguaje, visión, razonamiento y programación.
Estas capacidades originalmente tenían cada una sus propios usos, pero inesperadamente, al aplicarse a los robots, también pueden utilizarse directamente.
En contraste, muchas empresas de IA encarnada entrenan los cerebros de los robots desde cero, y los datos que tienen provienen principalmente de la propia manipulación robótica.

Para que el modelo entienda el entorno, comprenda las instrucciones y aprenda acciones, muchas capacidades deben
Diandian
extraerse con esfuerzo a partir de datos limitados.
Uno entra en la robótica con un conjunto completo de capacidades generales, mientras que el otro sigue invirtiendo datos, cómputo y mano de obra por separado para cada capacidad.
En esta contienda, las líneas de salida mismas son diferentes.
¿Sigue siendo necesario desarrollar modelos propios?
GPT-6 Astra es ciertamente muy fuerte, pero aún no lo suficiente como para que las empresas de IA encarnada simplemente bajen las armas y se rindan.
Al menos en el mundo físico real, todavía hay muchas nueces duras esperando ser cascadas.
Xu Huazhe, fundador de Pokebot, descompone las capacidades de inteligencia encarnada en tres niveles: generalización semántica, espacial y física.
Él cree que Astra destaca en las dos primeras, pero aún enfrenta desafíos en el contacto físico complejo, los cambios de fuerza, la deformación de objetos y la manipulación de alta precisión.
Por ejemplo, hacer que un robot sepa dónde está una taza y que debe extender la mano para agarrarla es completamente diferente de hacer que agarre una taza de manera estable.
¿La taza es blanda o dura? ¿Cuánta fuerza se debe usar al agarrarla? ¿Qué cambios ocurren después de que el objeto es apretado o golpeado?
Estos problemas no se pueden resolver simplemente entendiendo las imágenes visuales y comprendiendo las instrucciones.

△Captura de pantalla del informe
El equipo de RoboDojo también descubrió en su evaluación que Astra no supera a los demás en todas las tareas.
La alineación geométrica y la comprensión de instrucciones lingüísticas son sus fortalezas, pero cuando se trata de contacto continuo y manipulación física de múltiples pasos, los VLA existentes todavía tienen mucho margen de mejora.
Wang Qian, fundador de X Square Robot, sostiene la opinión de que, para que los grandes modelos generales entren en la IA encarnada, todavía deben enfrentar problemas de infraestructura como los datos de robots, la evaluación en el mundo real, el hardware, la simulación y el despliegue.
Estas dificultades no desaparecerán automáticamente solo porque uno tenga un modelo de lenguaje más potente.
La pregunta es, ¿las cosas que Astra no puede hacer bien hoy se volverán de repente alcanzables mañana?
Actualmente, otra crítica común hacia Astra en la industria es que su velocidad de inferencia es demasiado lenta.

Chen Tianxing también notó que la API en la nube de GPT-6 Astra tiene una latencia de inferencia relativamente alta, lo cual es un obstáculo real para el control de robots en bucle cerrado en tiempo real.
Piénsalo: si un robot tiene que esperar a que el gran modelo piense durante mucho tiempo antes de cada acción, probablemente sería difícil cumplir con los requisitos de los escenarios del mundo real.
Pero Chen Tianxing cree que este problema no es una barrera fundamental; ya existen muchas soluciones de despliegue de LLM en el dispositivo, incluidas tecnologías como la cuantización de modelos, la destilación y los motores de inferencia en el dispositivo. Siempre que las empresas de grandes modelos consideren la robótica como un escenario comercial importante, pueden utilizar la pila tecnológica existente para completar la optimización de la latencia.
Detrás de este problema hay un concepto que es muy fácil de confundir: "frecuencia de inferencia del modelo" y "frecuencia de control del robot" no son lo mismo.
Un ingeniero de modelos encarnados que declinó ser nombrado dijo a QbitAI:
Una inferencia lenta aún puede permitir un control rápido; lo único que se sacrifica es la velocidad de reacción. Para las tareas de línea de ensamblaje que dependen más del ritmo, esto es en realidad irrelevante.
Por ejemplo, en la clasificación de paquetes exprés, los robots necesitan agarrar y colocar de manera continua y estable. El modelo de alto nivel se encarga de comprender la tarea y planificar las acciones, mientras que el sistema de control de bajo nivel ejecuta los comandos de control a una frecuencia mayor.
Siempre que la tarea permita una planificación anticipada, o tenga cierta tolerancia a la latencia de reacción, el gran modelo no necesariamente tiene que participar en cada ciclo de control de bajo nivel.
Por supuesto, para las tareas que implican cambios dinámicos de alta velocidad y contacto complejo, la velocidad de reacción sigue siendo importante.
Pero al menos, una inferencia lenta no significa necesariamente que el control del robot no sea rápido.

Las diversas deficiencias que exponen hoy los grandes modelos generales no pueden tratarse directamente como el foso que las empresas de embodied AI utilizarán para sobrevivir en el futuro.
Para las empresas de embodied AI, esta verdad resulta algo dolorosa de escuchar.
Pero los hechos están ahí. Este año, OpenAI ya ha comenzado a reclutar un gran número de puestos relacionados con la robótica.
Si en el futuro los modelos generales absorben más datos de manipulación robótica, los límites de capacidad que originalmente pertenecían a los modelos de embodied AI especializados podrían seguir comprimiéndose.
¿Siguen teniendo oportunidades las empresas de embodied AI? ¿Sigue siendo necesario el modelado de desarrollo propio?
El juicio de Chen Tianxing es que la oportunidad para las empresas de embodied AI no reside en quién tiene el modelo más inteligente, sino en quién puede crear mejores «beneficios económicos».
Esta cuenta es fácil de calcular.
En una línea de ensamblaje industrial altamente estandarizada, donde los robots repiten las mismas acciones todos los días, lo que más les importa a los clientes es la tasa de éxito, el tiempo de ciclo, la estabilidad y el costo.
Si gastar unos centavos en llamar a un modelo puede completar la tarea de forma estable, ¿por qué insistir en gastar varios dólares en llamar a GPT-6 Astra?
Incluso si se requiere cierto nivel de inteligencia y capacidad de generalización, un modelo pequeño que haya sido optimizado específicamente puede ser más económico que llamar directamente a Astra.

Por supuesto, si se trata de un robot de servicio doméstico, la situación es diferente.
Hoy ordena la mesa, mañana busca objetos, y pasado mañana llega una nueva tarea que nunca antes había visto.
En un entorno tan abierto, cuanto más varían las tareas, mayores son los requisitos de comprensión, planificación y capacidad de generalización. Un modelo general más potente puede, en cambio, tener más ventajas.
El 6 de noviembre, Chen Tianxing explicó la diferencia en su blog personal utilizando dos ejes.
El lado izquierdo son los «requisitos del escenario», y el lado derecho son las «capacidades del modelo». Cuanto más arriba, más énfasis en la generalidad; cuanto más abajo, más énfasis en la eficiencia.

△Blog de Chen Tianxing
«Las tareas abiertas pueden depender más de modelos generales, las tareas estables pueden adoptar reglas o estrategias ligeras, y los escenarios intermedios dejan espacio para modelos optimizados para el escenario», dijo Chen Tianxing.
En mi opinión, juntar los dos ejes se resume en una sola frase:
Si algo se puede resolver con reglas/estrategias ligeras, no hay necesidad de traer un modelo grande; si una tarea se puede completar con un modelo pequeño, no hay necesidad de llamar a Astra cada vez.
Por el contrario, si las tareas varían demasiado, los modelos especializados necesitan recopilar datos y reentrenarse continuamente, por lo que llamar directamente a un modelo general puede ser más rentable.
Decidir qué enfoque adoptar requiere, en última instancia, calcular una cuenta económica completa.
¿Cuál es la tasa de éxito de una sola tarea? ¿Cuánto tiempo lleva? ¿Cuánta intervención manual se necesita después de un fallo? ¿Cuánto cuesta la recopilación de datos, el entrenamiento del modelo y el despliegue a largo plazo?
Estos números concretos determinan si un sistema robótico tiene valor comercial.
Por lo tanto, no es que el desarrollo interno no sea importante, sino que las "direcciones de desarrollo interno" de las empresas de embodied necesitan reordenarse.
Las capacidades en las que los modelos generales ya son buenos, como la comprensión del lenguaje y la planificación de tareas, pueden considerarse para uso directo; los problemas que involucran interacción física, control corporal específico, adaptación a escenarios reales y eficiencia de despliegue todavía requieren una investigación y desarrollo especializados sustanciales.
En cuanto a si es necesario continuar entrenando desde cero un modelo fundacional de embodied más grande, depende de si puede proporcionar ventajas suficientemente obvias y suficientemente duraderas en tareas reales.
Algunos amigos de la industria se quejaron a Quantum位 de que muchos equipos de embodied todavía llevan una mentalidad académica bastante fuerte, siempre pensando en construir un modelo de inteligencia general y deseando poder meter todas las tareas en su propio modelo.
Pero la situación ha cambiado ahora. GPT-6.2 Astra está a punto de llegar.
Si la dirección de investigación de una empresa está desconectada de su industria objetivo, por muy bellamente que se entrene el modelo, el ciclo comercial puede que no necesariamente se sostenga.
Una cosa más
Durante los últimos 60 días, muchos profesionales de la industria de embodied, al charlar en privado, siguen confundidos.
Solo que en entornos públicos, cuando se trata de defender sus propios intereses y posiciones, todavía tienen que mantener su terreno hasta el final.
Lo que es seguro es que GPT-6 Astra ciertamente ha perturbado el ritmo original de la industria de embodied...
El efecto Mateo, la revaluación de la industria tras la IPO de Unitree, RSI convirtiéndose en un nuevo punto caliente... todo apilado junto, finalmente formando el sentimiento reciente de la industria—
"Los inversores están empezando a dejar de invertir en IA embodied."
Puede haber algo de exageración, pero es completamente cierto que las startups de robots inteligentes embodied están despidiéndose de la etapa de Demo y de quemar inversión.
La ronda de eliminación de la batalla de las cien máquinas ya ha comenzado.
Este artículo proviene de la cuenta pública de WeChat "Quantum位" (ID: QbitAI), autor: Focus on Frontier Technology