Camarades, Anthropic réduit à nouveau les prix. Cette fois, il s'agit du modèle le moins cher de la famille Claude, Haiku.
Le 7 octobre, Anthropic a officiellement publié Claude Haiku 5.5, affirmant qu'il s'agit de son petit modèle le plus rapide, le plus performant et le moins cher à ce jour.
Le plus scandaleux, c'est le prix, aussi bas que 0,1 $ par million de jetons d'entrée, une réduction directe de 90 % par rapport à la génération précédente.
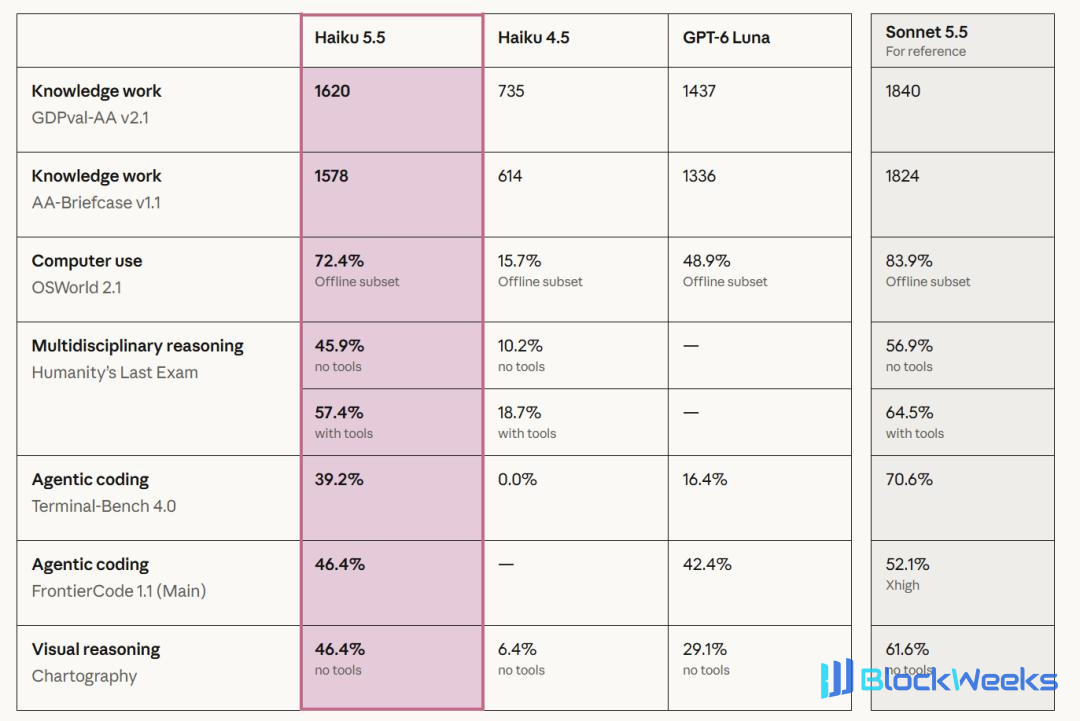
Les performances ne sont pas en reste non plus. Selon les résultats de tests publiés par Anthropic, Haiku 5.5 surpasse GPT-6 Luna d'OpenAI sur plusieurs benchmarks, notamment l'utilisation d'ordinateur, le travail de connaissance et la programmation d'Agent, avec certains scores montrant même un écart considérable.
De plus, Haiku 5.5 introduit également une intensité de raisonnement ajustable, prenant en charge une fenêtre de contexte de 1 million de jetons et une sortie allant jusqu'à 128 000 jetons.
À ce stade, Anthropic a achevé la mise à jour de toute la famille Claude 5.5 en seulement 15 jours : Opus 5.5 est arrivé le 22 septembre, Sonnet 5.5 a été publié le 28 septembre, et maintenant Haiku 5.5 a officiellement rejoint le groupe.
Cette fois, Anthropic s'est concentré sur ces tâches d'IA avec des volumes d'appels massifs et une sensibilité extrême au prix.
Plusieurs scores surpassent GPT-6 Luna, taux de réussite des opérations informatiques de 72,4 %
Selon les scores Benchmark publiés par Anthropic, Haiku 5.5 a réalisé des améliorations significatives par rapport à la génération précédente, et dans certains tests a même obtenu de meilleurs résultats que GPT-6 Luna.
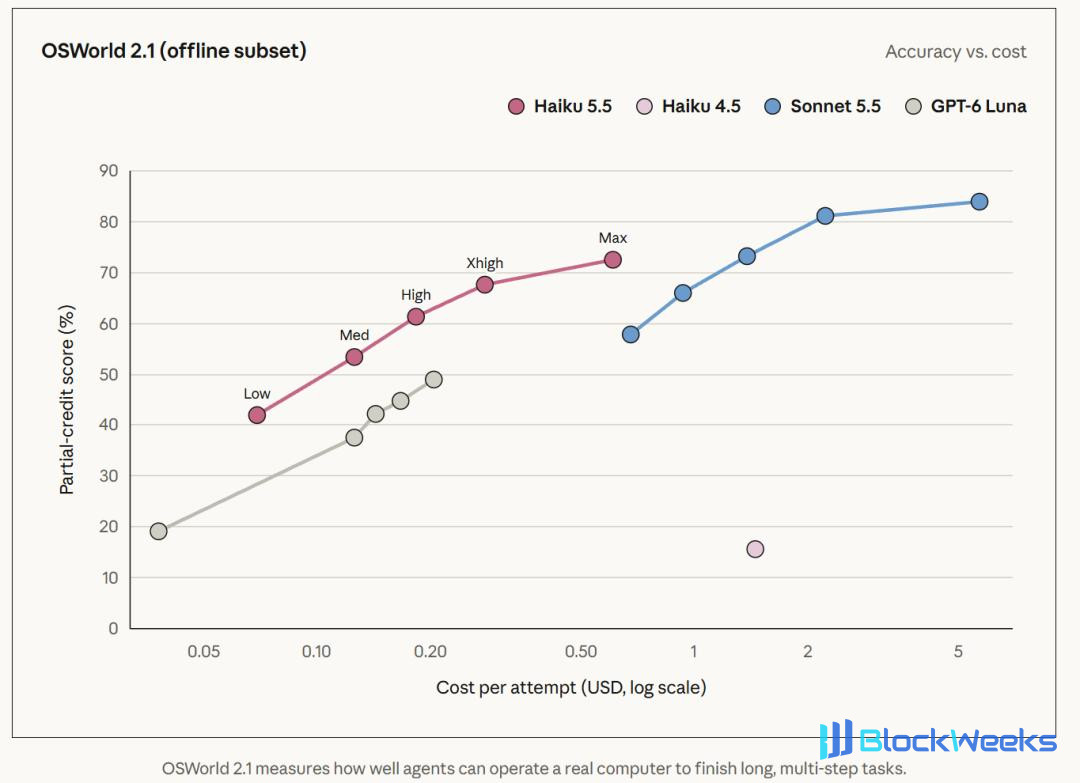
Le résultat le plus notable provient d'OSWorld. Il s'agit d'un test mesurant la capacité d'un Agent IA à utiliser un ordinateur réel, exigeant du modèle qu'il accomplisse des tâches multi-étapes et inter-applications.
Sur le sous-ensemble de tâches hors ligne OSWorld 2.1, Haiku 5.5 a atteint un taux de réussite de 72,4 %, tandis que la génération précédente Haiku 4.5 n'avait que 15,7 %, et GPT-6 Luna avait 48,9 %.
En termes de travail de connaissance, Haiku 5.5 a obtenu un score de 1620 dans GDPval-AA v2.1, surpassant les 1437 de GPT-6 Luna. Dans le test de programmation d'Agent Terminal-Bench 4.0, les deux ont obtenu respectivement 39,2 % et 16,4 %.
Cependant, il y a un détail important dans ces données. Les scores Benchmark les plus élevés de Haiku 5.5 nécessitent souvent plus de calcul de raisonnement.
Haiku 5.5 introduit pour la première fois dans la série Haiku une intensité de raisonnement ajustable, permettant aux développeurs de contrôler la quantité de ressources de calcul que le modèle investit via le paramètre effort.
Le média VentureBeat a remarqué que dans le test Terminal-Bench publié par Anthropic, le score de 39,2 % correspond à une intensité de raisonnement maximale. Après avoir basculé vers une intensité de raisonnement moyenne, le score tombe à environ 20 %, et l'intensité moyenne est exactement le paramètre par défaut de Haiku 5.5.
L'agence d'évaluation tierce Artificial Analysis a également observé un phénomène similaire. Dans son évaluation Intelligence Index, Haiku 5.5 a obtenu 43 points à intensité de raisonnement maximale et 34 points à intensité de raisonnement moyenne. Sous la même évaluation, le coût moyen par tâche était d'environ 0,21 $ et 0,05 $ respectivement.
En d'autres termes, le modèle peut échanger un budget de raisonnement accru contre de meilleures performances sur la tâche, mais le coût réel peut également augmenter considérablement.
Dans son propre test Terminal-Bench 4.0, Artificial Analysis a mesuré des scores de 33 % à intensité de raisonnement maximale et de 15 % à intensité moyenne. En raison de paramètres d'évaluation différents, ces chiffres diffèrent des résultats officiels d'Anthropic.
C'est aussi pourquoi, lorsqu'on examine les performances des petits modèles, il faut considérer simultanément l'intensité du raisonnement, le taux d'achèvement des tâches et le coût réel.
Sur des tâches de programmation d'Agent plus complexes, Sonnet 5.5 conserve un avantage clair : son score Terminal-Bench 4.0 atteint 70,6 %.
Anthropic a également clairement déclaré que Sonnet et Opus sont encore plus adaptés aux tâches complexes de programmation d'Agent, tandis que les avantages de Haiku se concentrent sur les travaux à haute fréquence et au périmètre bien défini.
Prix directement réduit à un dixième, concurrence frontale avec GPT-6 Luna
Si les améliorations de performances rendent Haiku 5.5 compétitif, alors le prix pourrait être le point culminant le plus important de cette sortie. Anthropic a conçu deux niveaux de tarification API pour le nouveau modèle.

Pour les requêtes dont la longueur d'invite ne dépasse pas 100 000 jetons, les prix unitaires d'entrée et de sortie de Haiku 5.5 sont tous deux inférieurs de 90 % à ceux de la génération précédente. Au-delà de ce seuil, le prix reste inférieur de 50 % à celui de Haiku 4.5.
Anthropic a déclaré qu'environ 90 % des requêtes adressées à la génération précédente de Haiku étaient inférieures à 100 000 jetons. En combinant différentes longueurs de requêtes et les changements de consommation de jetons, l'entreprise estime que Haiku 5.5 permet de réduire d'environ 75 % le coût moyen des tâches similaires.
Il y a aussi un détail facile à négliger ici — Haiku 5.5 est passé à un nouveau Tokenizer. Selon la documentation officielle destinée aux développeurs, un même texte peut générer environ 30 % de jetons en plus dans le nouveau modèle que dans Haiku 4.5, l'augmentation spécifique dépendant du contenu. Par conséquent, une baisse de 90 % du prix unitaire de l'API ne signifie pas que la facture de chaque tâche peut être réduite de 90 %.
Un autre rival à surveiller est GPT-6 Luna. Le prix de base d'OpenAI pour Luna est également de 0,1 $ par million de jetons d'entrée et de 0,5 $ pour la sortie, et le prix de lecture du cache est également conforme au niveau de prix bas de Haiku 5.5.
Cependant, il existe une différence claire entre les seuils de facturation en contexte long des deux entreprises.
Haiku 5.5 entre dans un niveau de prix plus élevé après que les invites dépassent 100 000 jetons ; GPT-6 Luna ne déclenche des suppléments pour contexte long qu'après que l'entrée dépasse 272 000 jetons. Cela signifie que pour les requêtes comprises entre 100 000 et 272 000 jetons, Luna a un avantage sur le prix unitaire par jeton.
Quant à savoir quel modèle est finalement le plus rentable pour accomplir une tâche, il faut encore en juger en fonction de l'utilisation réelle des jetons, du budget d'inférence et du taux de réussite des tâches.
Si l'on considère l'ensemble du marché, Anthropic met également la pression sur les autres modèles à bas prix.
Les prix API de la même période listés par VentureBeat montrent que Google Gemini 3.5 Flash-Lite coûte 0,3 $ par million de jetons d'entrée et 2,5 $ pour la sortie ; Gemini 3.8 Flash coûte respectivement 0,75 $ et 3,75 $.
Bien sûr, différents modèles ont des positionnements de capacités, des stratégies de mise en cache et des performances de tâches différents. Ces chiffres reflètent d'abord la concurrence sur les prix des API.
La guerre des prix entre petits modèles s'intensifie encore.
8 millions d'appels par semaine, les entreprises commencent à faire travailler les petits modèles pour les grands modèles
À quoi exactement Haiku 5.5 est-il adapté ?
Les scénarios donnés par Anthropic incluent le résumé de documents, la classification d'informations, les requêtes de bases de données, la compression de contexte et le rôle de sous-agent dans des workflows d'Agent complexes.
Derrière cela se cache un problème très concret : les Agents d'aujourd'hui deviennent de plus en plus complexes, et une tâche nécessite souvent plusieurs appels de modèles. Si chaque étape est confiée à un grand modèle, les coûts s'accumuleront rapidement.
La société d'IA financière Rogo en fournit un exemple. Dans son flux de travail, un grand modèle plus performant est chargé de créer des présentations financières. Lors du traitement d'une diapositive donnée, le sous-agent Haiku 5.5 entre dans le rapport annuel 10-K de l'entreprise, trouve les données de chiffre d'affaires nécessaires, puis transmet le résultat au modèle principal.
Pour ce type de tâche, le modèle doit effectuer la recherche et l'extraction d'informations rapidement et avec précision. Rogo estime que Haiku 5.5 atteint un équilibre adapté aux appels répétés à grande échelle entre la précision, la vitesse et le prix.
La plateforme de gestion de contenu d'entreprise Box a également fourni des résultats de tests préliminaires. Comparé à Haiku 4.5, le score d'évaluation interne de Haiku 5.5 a augmenté de 11 points, et la latence a chuté d'environ 50 %.
Box a déclaré que cela rend le nouveau modèle adapté aux travaux d'analyse qui doivent être exécutés à grande échelle, tels que les rapports de coûts, les synthèses financières et les examens périodiques. Cependant, Box n'a pas divulgué les critères d'évaluation complets.
Les tests d'Asana ont couvert des tâches d'Agent telles que la classification de bugs, la création de projets et la recherche dans de grands portefeuilles de projets. Selon les résultats qu'elle a divulgués, comparé au modèle actuellement utilisé, Haiku 5.5 a réduit la latence d'achèvement des tâches de plus de 30 % et augmenté la vitesse d'inférence de l'Agent en un seul tour jusqu'à 2,5 fois.
Un autre exemple qui démontre mieux la valeur des coûts provient d'AlphaSense. La fonctionnalité Ask in Document de cette entreprise doit traiter environ 8 millions d'appels par semaine, principalement pour répondre à des questions spécifiques sur un ou plusieurs documents.
Parmi 400 requêtes de test, le score d'évaluation interne de Haiku 5.5 a atteint 0,84, tandis que celui de Haiku 4.5 était de 0,76.
Si un modèle est appelé des millions de fois par semaine, même s'il permet d'économiser seulement une petite somme d'argent à chaque fois, la variation des coûts accumulée à long terme peut être considérable.
Ces données proviennent des retours précoces de clients divulgués par Anthropic. Les charges de travail spécifiques, les modèles de comparaison et les normes d'évaluation ne sont pas complètement cohérents, et des tests indépendants supplémentaires sont encore nécessaires.
Sonnet baisse aussi ses prix, et la famille Claude 5.5 commence à rivaliser sur les coûts
En plus de Haiku 5.5, Anthropic a également ajusté le tarif de Sonnet 5.5 en même temps. À partir du 7 octobre, les frais de lecture du cache de Sonnet 5.5 seront réduits de 50 %, passant de 0,2 $ par million de tokens à 0,1 $.
Anthropic estime que cet ajustement peut réduire davantage le coût de la plupart des charges de travail d'Agent d'environ 20 %, la réduction réelle dépendant de la mesure dans laquelle les applications réutilisent le contexte mis en cache.
Pour les Agents qui doivent relire de manière répétée de longs historiques de conversation, des descriptions d'outils et le contexte des tâches, les coûts de cache affectent directement les dépenses d'exploitation à long terme du système.
Anthropic a également lancé des crédits API mensuels pour les abonnés Claude Max et Team : 100 $ pour les utilisateurs Max 5x, 200 $ pour les utilisateurs Max 20x, et jusqu'à 500 $ partagés par les utilisateurs Team.
Ces crédits peuvent être utilisés pour les appels de modèles sur la plateforme Claude, encourageant davantage d'abonnés à essayer de construire leurs propres Agents et applications.
Du côté des développeurs, Haiku 5.5 est déjà disponible via des plateformes telles que l'API Anthropic, Amazon Bedrock, Google Cloud et Microsoft Azure, avec l'ID de modèle API claude-haiku-5-5.
Anthropic a également mis à jour les SDK Python et TypeScript, ajoutant un support en phase Bêta pour l'opération de navigateur et l'opération d'ordinateur.
À ce stade, la répartition des produits de la série Claude 5.5 est déjà assez claire.
Opus 5.5 gère les tâches de raisonnement complexe et de haute difficulté, Sonnet 5.5 couvre le travail complexe quotidien et la programmation, et Haiku 5.5 se concentre sur les tâches à volume d'appels élevé, sensibles aux coûts et exigeant une réponse rapide.
Du 22 septembre au 7 octobre, Anthropic a mis 15 jours pour achever cette série de mises à jour de produits, les trois modèles mettant tous l'accent sur la performance et l'efficacité des coûts.
La sortie de Haiku 5.5 rend également une tendance plus évidente. À mesure que les Agents passent progressivement des démonstrations aux applications pratiques, les développeurs doivent prendre en compte les coûts d'appel de l'ensemble du système. Quelles étapes d'une tâche nécessitent un modèle plus puissant, lesquelles peuvent être confiées à un petit modèle, et comment le travail est réparti entre différents modèles, tout cela affectera la viabilité commerciale finale.
Pour Anthropic, l'aspect peut-être le plus attrayant de Haiku 5.5 réside ici : il permet à davantage de tâches qui étaient à l'origine difficiles à mettre à l'échelle en raison de coûts d'appel excessivement élevés de commencer à devenir économiquement viables.
La concurrence entre petits modèles a déjà commencé à pénétrer chaque maillon d'exécution du système d'Agent.
Documents de référence
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Cet article provient du compte public WeChat « Machine Heart » (ID : almosthuman2014), éditeur : Spoon-billed Sandpiper