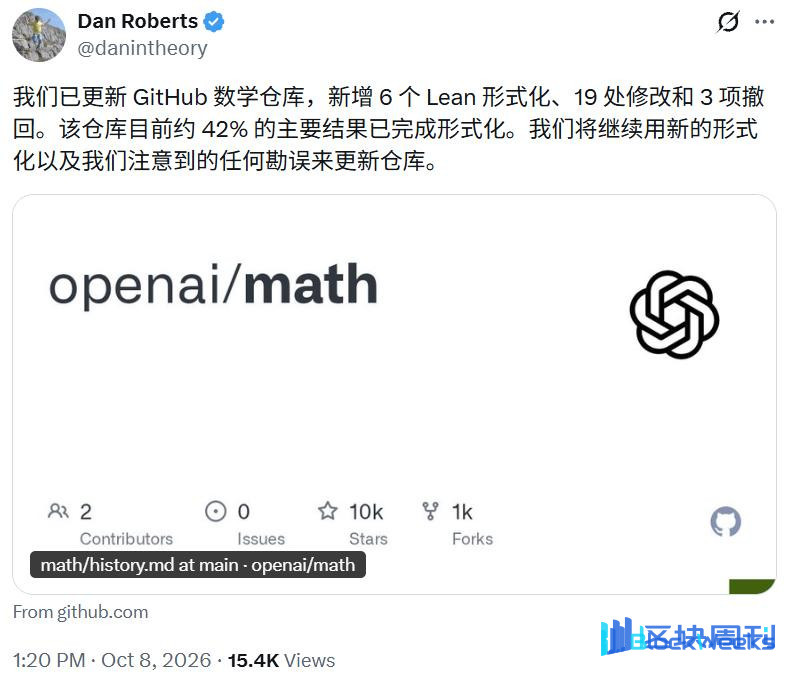
Wczoraj OpenAI opublikowało jednocześnie 722 rękopisy dotyczące matematyki AI, a teraz wycofało 3 z nich.
Powód jest prosty: został błędnie zapisany znak plus-minus.

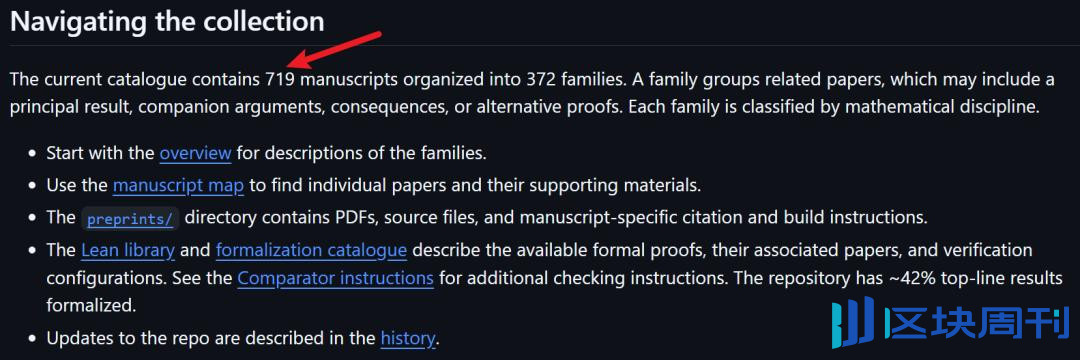
Właśnie teraz OpenAI opublikowało pierwszy dziennik zmian w repozytorium openai/math. Dziennik pokazuje, że OpenAI wycofało 3 rękopisy, poprawiło 14 i zaktualizowało cytowania dla kolejnych 13. Całkowita liczba rękopisów w repozytorium spadła z 722 do 719.
Jeden znak plus-minus obala trzy prace
Trzy wycofane prace są wszystkie związane z hipotezą Hodge'a, jednym z problemów milenijnych:
Algebraiczność klas Weila na rozszczepialnych ośmiowymiarowych rozmaitościach abelowych
Algebraiczność odpowiedniości Kuga–Satake dla powierzchni K3
Racjonalna hipoteza Hodge'a dla produktów powierzchni K3
Problem leży w pierwszej pracy. W nocie wycofującej OpenAI napisało, że w kluczowym argumencie praca zapisała znak pewnej operacji geometrycznej jako +1, podczas gdy zgodnie z konwencją samej pracy powinien to być -1.
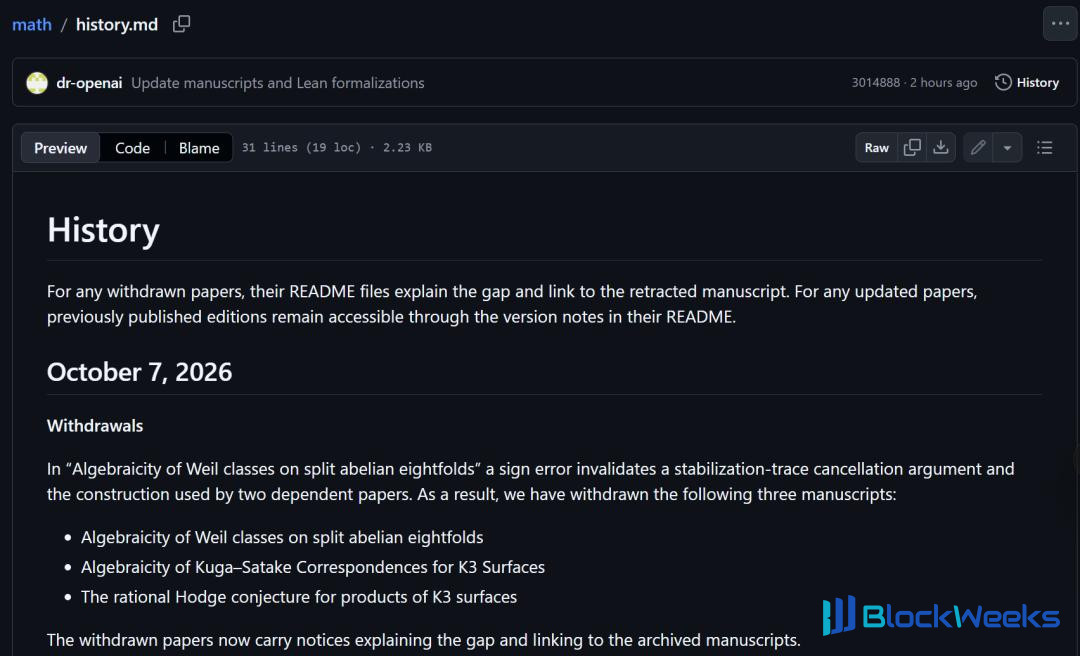
https://github.com/openai/math/blob/main/history.md
Plus kontra minus czyni ogromną różnicę. Liczba, która powinna się skasować i ostatecznie wynosić zero, stała się liczbą niezerową. Klasyczne twierdzenie, na którym opiera się praca, ma jako warunek wstępny właśnie to, że ta liczba musi wynosić zero. Gdy warunek wstępny zawodzi, cała dalsza konstrukcja traci oparcie.
Pozostałe dwie prace również zapożyczyły tę konstrukcję, więc zostały wycofane.
Jednak we wszystkich trzech notach wycofujących OpenAI podkreśliło to samo zdanie: wycofywany jest dowód, co nie oznacza, że same te twierdzenia matematyczne są błędne. Oryginalne rękopisy również nie zostały usunięte i nadal można je przeglądać poprzez zarchiwizowane linki.
Te trzy prace należą wszystkie do rodziny wyników repozytorium nr 032, to znaczy do wcześniej najściślej obserwowanych wyników związanych z hipotezą Hodge'a.
Po wycofaniu nazwa tej rodziny również się zmieniła: z "Wyniki Hodge'a i Kuga–Satake dla wszystkich rzutowych powierzchni K3" na "racjonalna hipoteza Hodge'a dla rozmaitości abelowych CM".
Innymi słowy, część wniosków dotyczących powierzchni K3 została usunięta z listy. Główny wniosek tej rodziny, a mianowicie udowodnienie racjonalnej hipotezy Hodge'a dla wszystkich zespolonych rozmaitości abelowych CM, jest nadal zachowany, a nowa wersja tej pracy jedynie zaktualizowała cytowania.
Warto wspomnieć, że praca z błędem jest datowana na 18 września, co czyni ją jedną z najwcześniejszych partii rękopisów w repozytorium. Od jej daty do publicznego udostępnienia minęły prawie trzy tygodnie, a została wycofana w ciągu jednego lub dwóch dni po publikacji. Jeśli chodzi o to, kto odkrył błąd, OpenAI nie powiedziało.
Zmieniono kolejne 14 artykułów
Oprócz wycofań, OpenAI zmieniło również 14 manuskryptów, w tym poprawianie dowodów, korygowanie sformułowań wniosków oraz doprecyzowanie warunków wstępnych i zależności.

Te 14 dotyczą wysokości Lipschitza i modelu Ashkina–Tellera w fizyce statystycznej (4 artykuły), programu minimalnych modeli Kählera i obfitości w geometrii zespolonej (6 artykułów), geometrii symplektycznej (2 artykuły), ogólnych obliczeń dla płynów Naviera-Stokesa (1 artykuł) oraz jednego artykułu o wzorze BSD, z którego usunięto nieaktualne cytowania.
Jedna poprawka jest dość reprezentatywna. Rodzina wyników nr 342 twierdziła, że dowodzi hipotezy „tame pushforward compatibility” zaproponowanej przez Simona Donaldsona. Główny wniosek nie zmienił się i istnieje formalizacja w Lean. Jednak stwierdzono, że silniejszy dodatkowy wniosek w artykule został wyolbrzymiony: poprawiona wersja zawęża go do konkretnego przypadku i dodaje również przykład pokazujący, że nie zachodzi on ogólnie.
Wskaźnik formalizacji: 42%
Aktualizacja dodała również 6 formalizacji w Lean i 5 uzupełniających wyników pomocniczych. Według rozliczeń OpenAI, główne wyniki 300 manuskryptów zostały już sformalizowane, co stanowi około 42% wszystkich 719.

Wśród nowo dodanych formalizacji kilka ma duże znaczenie, na przykład 103. rodzina osiągnięć w informatyce teoretycznej twierdząca, że dowodzi, iż obliczenia w pamięci logarytmicznej można w pełni derandomizować (L = RL = BPL).
Należy zauważyć, że „około sześćdziesięciu procent”, o których wcześniej informowaliśmy, liczono według rodzin osiągnięć, co oznacza, że jeśli jeden artykuł w rodzinie ma formalizację, jest liczony; 42% ogłoszone przez OpenAI jest liczone według poszczególnych głównych wyników, co lepiej odzwierciedla rzeczywisty odsetek sprawdzony linia po linii przez komputer.
Tam, gdzie pojawiają się błędy, nie ma nadzoru Lean
Porównanie z katalogiem repozytorium ujawnia wzorzec: treść, która została wycofana i znacząco zmieniona tym razem, prawie w całości przypada na części bez formalizacji w Lean.
Potwierdza to również wcześniejsze ostrzeżenie środowiska matematycznego: wyniki, które nie przeszły formalizacji i recenzji, można obecnie traktować jedynie jako „twierdzenia”.
Na szczęście ta errata została obsłużona dość prawidłowo: błędy zostały jasno przedstawione, łańcuch zależności wyjaśniony, a stara wersja zachowana do wglądu, zgodnie z zasadą „modyfikacji z śladem” zalecaną przez Grupę Doradczą ds. Matematyki i Sztucznej Inteligencji Instytutu Studiów Zaawansowanych.
Jednak zaledwie dwa dni po upublicznieniu ponad 700 manuskryptów nadeszła pierwsza errata. Najprawdopodobniej nie będzie ostatnia.
Ten artykuł pochodzi z publicznego konta WeChat „Machine Heart” (ID: almosthuman2014), redaktor: Panda