
Nie do wiary, czy benchmarki naprawdę rozwinęły się już do tego poziomu???
Tym razem nie chodzi już o rozwiązywanie zadań ćwiczeniowych — po prostu daje się AI zestaw warunków eksperymentalnych i pozwala jej prowadzić własne badania i z góry przewidywać wyniki rzeczywistych eksperymentów mokrych...
Na przykład, jeśli ta sama reakcja jest przeprowadzana w kilku różnych warunkach, w których z nich uzyska się więcej docelowego produktu? Spośród partii wariantów przeciwciał, który z nich będzie miał wyższy poziom ekspresji?
Odpowiedzi są najpierw ukrywane, a gdy AI oddaje swoją pracę, rzeczywiste zmierzone wyniki są z nią porównywane.
I wiecie co, to jest naprawdę coś, co warto teraz testować.
W ciągu ostatnich dwóch lat podejście AI for Science stawało się coraz głębsze — AI potrafi już samodzielnie przeszukiwać literaturę, korzystać z oprogramowania i pracować nieprzerwanie przez wiele godzin, aby ukończyć zadanie analityczne.
Naturalnie wszyscy zaczęli przechodzić do kolejnego etapu: Jakie zdolności badawcze tak naprawdę chcemy, aby miała AI?
Przewidywanie wyników eksperymentów mokrych jest jedną z pozycji o sporej wartości praktycznej.
Wymaga to od AI zrozumienia celu eksperymentu i wydobycia odpowiednich mechanizmów z istniejącej wiedzy, aby mogła lepiej pomóc badaczom w selekcji kierunków badawczych wartych dalszej eksploracji.
Nowy benchmark Science Prediction Universe (w skrócie SPU), zainicjowany i uruchomiony przez UniPat AI, trafnie to zauważył.
116 zadań, 4 207 eksperymentów mokrych, obejmujących chemię, naukę o materiałach, biologię i medycynę. Doradcy benchmarku i współpracownicy ds. eksperymentów mokrych pochodzą również z uniwersytetów takich jak Stanford, Cornell i Harvard, a także z wiodących instytucji badawczych i firm biotechnologicznych w tej dziedzinie.
Model za każdym razem działa w systemie 8-godzinnego dnia pracy, jest wyposażony w H20, a następnie samodzielnie decyduje, jak wykorzystać zasoby wyszukiwania i obliczeniowe do sformułowania przewidywań eksperymentalnych.
Wyniki zaskoczyły wszystkich.
Nawet tak silne modele jak Opus 5.5 i GPT-6 Astra są, według danych, wciąż bardzo daleko od rzeczywistej zdolności do przewidywania...
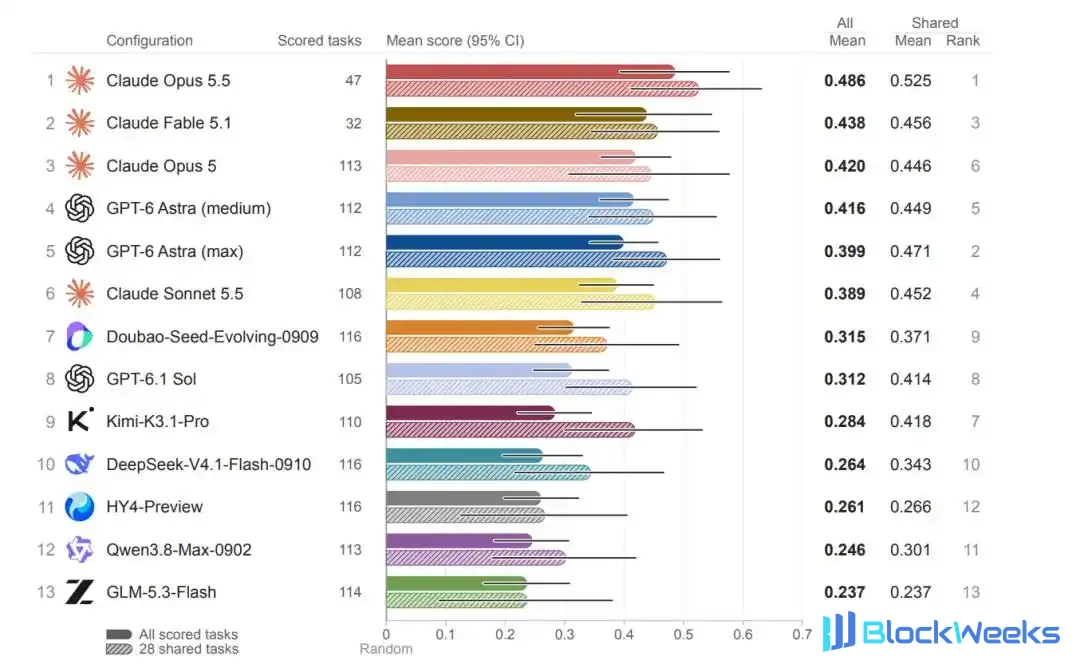
△Średnie wyniki każdej konfiguracji we wszystkich ocenianych zadaniach
Muszę przyznać, że SPU podało wszystkim modelom badawczym trudne danie.
Te zdolności badawcze, które kiedyś były niewidoczne i nieuchwytne, stały się teraz wartościami liczbowymi, które można jednolicie oceniać i stale badać.
A co do tego, jak naukowy osąd AI rozwija się krok po kroku, istnieje teraz bardziej konkretna podstawa do dyskusji.
Przewidywanie eksperymentów mokrych: warte osobnego egzaminu dla modeli
Wracając do przewidywania eksperymentów mokrych — po pierwsze, to rzeczywiście nie jest nowe pytanie.
W historii nauki było wiele takich momentów: dokonuje się osądu przed eksperymentem, a potem pozostawia się procesowi decyzję — jeśli jest trafny, zostaje; jeśli błędny, zostaje obalony.
Konkretna logika osądu stanowi wyrafinowanie naukowca.
Dzięki wystarczająco dobremu wyrafinowaniu i wystarczająco trafnej intuicji naukowcy mogą szybciej uzyskiwać duże wyniki, oszczędzając przy tym cenne zasoby eksperymentalne.
W końcu jeden eksperyment wet-lab — w chemii trzeba przygotować odczynniki, ustawić warunki reakcji, a następnie rozdzielić produkty; w biologii również trzeba przejść przez długotrwałą ekspresję białek... Koszty czasu i koszty narzędzi same w sobie są dość wysokie, a jeśli wyniki nie są idealne, trzeba to powtarzać wielokrotnie przez kilka rund.
Dlatego przewidywanie przed rozpoczęciem jest najbardziej wartościowym krokiem w procesie badawczym.

Jedyna różnica polega na tym, że w przeszłości robili to wyłącznie sami naukowcy, a teraz w erze AI modele również muszą mieć tę zdolność i potrzebują także arkusza testowego, który może je ocenić.
Istniejące benchmarki wciąż nie mogą tego w pełni pokryć. Na przykład BrainBench pozwala modelom bezpośrednio oceniać wyniki eksperymentów; ScienceAgentBench koncentruje się na przeprowadzaniu analizy na istniejących danych; a benchmarki zadań długoterminowych, takie jak Terminal-Bench 4.0 i Long-Horizon-TB, głównie wykorzystują wstępnie ustawione testy do sprawdzania wyników zadań.
SPU różni się od nich wszystkich.
Kładzie większy nacisk na testowanie autonomicznego procesu badawczego AI wraz z przewidywaniem wyników wet-lab, obejmując zarówno wydajność przewidywania, jak i zdolność do korzystania z narzędzi naukowych i wykonywania zadań długoterminowych.

△Wykres został wygenerowany przez AI
Tego rodzaju ocena została również przez SPU uporządkowana w jasne zadania.
100 publicznych zadań zostało odpowiednio zaczerpniętych z 85 niedawno opublikowanych artykułów. Eksperci dziedzinowi uporządkowali opcje kandydujące, materiały, warunki i metody pomiaru z badań, zachowując kompletne wyniki ilościowe jako podstawę oceny.
Ponadto 16 prywatnych zadań pochodzi z czterech grup nieopublikowanych wspólnych eksperymentów wet-lab, obejmujących nanociała VHH, warunki reakcji, elektrolity i warianty Magrolimabu.
Łącznie 32 poddziedziny i 4207 eksperymentów, przy czym badania publiczne zapewniają interdyscyplinarne źródła zadań, zmierzone wyniki są ukryte przed modelami, a nieopublikowane eksperymenty dodają testy niezależne od odpowiedzi w publicznych artykułach.
Do pewnego stopnia może to zapobiec temu, by modele widziały pytania wcześniej.

△Zakres i źródła zadań SPU
Proces wyboru pytań jest również dość staranny.
Eksperci priorytetowo traktują badania z kompletnymi pomiarami i jasnymi warunkami; proste pytania, które można uszeregować według jednego trendu, są bezpośrednio eliminowane, a pytania z wartościami zbyt bliskimi sobie również są uznawane za mające niewielką wartość referencyjną.
Pytania, które ostatecznie pozostają, są wszystkie trudniejsze i bardziej różnicujące.
Podczas konkretnego procesu przewidywania model jest zobowiązany do działania przez osiem godzin za każdym razem, wyposażony w 8-rdzeniowy procesor CPU, 16 GiB pamięci i jeden H20, przy jednoczesnym pozwoleniu na przeszukiwanie internetu i instalowanie oprogramowania naukowego.
W tym czasie model samodzielnie zbiera dowody, wybiera metody obliczeniowe i ostatecznie przesyła przewidywany ranking od najniższego do najwyższego dla każdej grupy porównawczej.
Aby zapobiec zanieczyszczeniu pamięci, proces oceniania jest również przeprowadzany w całości w niezależnym, offline'owym kontenerze; sztuczna inteligencja ma zakaz pobierania oryginalnych wyników badań, a dane wyjściowe narzędzi są automatycznie skanowane w celu zidentyfikowania identyfikatorów, takich jak DOI i tytuł artykułu źródłowego.
Na koniec system wykorzystuje współczynnik korelacji Spearmana do porównania przewidywanej rangi z zmierzoną rangą.
Im bliżej współczynnik jest 1, tym bliższa jest ranga wynikom eksperymentalnym.

△Proces oceny SPU
Co ciekawe, SPU zwraca również uwagę na wiele szczegółów, których testy porównawcze nie uwzględniły.
Na przykład, jeśli chodzi o ostateczny wynik, SPU rozważa, czy może to być spowodowane szczęściem, na wypadek gdyby to był ślepy kot, który natrafił na martwą mysz.
Dlatego dodatkowo generuje 4000 losowych rankingów dla każdego pytania, używa 95. percentyla jako progu poziomu losowego i sprawdza, czy zgłoszenie modelu znacząco przekracza ten punkt odniesienia. Różne zadania mają również odpowiednie podstawy odniesienia.
Można powiedzieć, że projekt całego SPU jest naukowo rygorystyczny.
Model musi krok po kroku w jego ramach samodzielnie ocenić, co warto obliczyć, i przesłać swoją ostateczną prognozę.
Ten projekt nie tylko pomaga zmierzyć obecne zdolności przewidywania eksperymentów mokrych przez sztuczną inteligencję, ale także wskazuje kierunek dla kolejnych zespołów badawczych do ciągłego ulepszania eksperymentów za pomocą ujednoliconych metryk.
To powiedziawszy, przyjrzyjmy się teraz razem świadectwom pierwszej partii modeli frontier. Szczegóły są całkiem warte osobnej dyskusji.
Nowy test sprawia, że modele frontier zbiorowo zawodzą
Pierwsza runda systematycznej oceny SPU obejmuje 12 modeli frontier i 13 konfiguracji. Konfiguracje tutaj odnoszą się do modelu, intensywności rozumowania i użytego frameworku modelu.
Najpierw omówmy ogólne wyniki.
W jednym zdaniu: żaden z nich nie jest dobry.
We wszystkich ocenianych zadaniach najwyższy średni wynik uzyskał Claude Opus 5.5, z 0,486 punktu. Ale nawet dla niego tylko połowa zadań przekroczyła poziom losowy.
Wśród 13 konfiguracji jest to prawie zawsze tak; odsetek zadań przekraczających próg poziomu losowego wynosi tylko 34% do 52%.
Innymi słowy, wszystkie obecne modele mają jeszcze długą drogę do przebycia, zanim będą mogły dokonywać naprawdę wiarygodnych przewidywań eksperymentów mokrych.

△Analiza porównawcza zachowań grupy prowadzącej i grupy końcowej
Jednak między modelami również występują różnice, a średnie wyniki można podzielić na dwa poziomy:
grupę prowadzącą (6 modeli) i grupę końcową (7 modeli).
W porównaniach tych samych pytań grupa prowadząca średnio jest nadal o około 0,15 punktu wyższa niż pozostałe siedem.
Jest jeszcze jeden szczegół wart uwagi. Około 9% zadań w grupie prowadzącej uzyskało wynik poniżej 0, podczas gdy dla pozostałych siedmiu konfiguracji ten odsetek może wynosić nawet 22%.
Tutaj 0 odnosi się do średniego wyniku losowej prawidłowej rangi; wynik ujemny oznacza, że prognoza jest ujemnie skorelowana z rzeczywistą rangą.
Skąd dokładnie wynika ta różnica? Zespół badawczy poszedł o krok głębiej.
Najpierw połączyli predykcje innych modeli dotyczące tego samego pytania w ranking referencyjny, następnie zestawili eksperymenty parami, porównali je z zmierzonymi wynikami i sprawdzili, czy każdy model indywidualnie uszeregował je poprawnie.
W przypadku par eksperymentów, w których ranking referencyjny był poprawny, wiodąca grupa uszeregowała je poprawnie w 86% przypadków, podczas gdy pozostałe siedem konfiguracji osiągnęło 78%; dla par eksperymentów, w których ranking referencyjny był błędny, obie grupy niezależnie uszeregowały je poprawnie w około 30% przypadków.
Zatem w rzeczywistości część przewagi wiodącej grupy odzwierciedla się właśnie w miejscach, gdzie predykcje są wspólnie poprawne; w tej części wiodąca grupa jest zawsze bardziej stabilna.

Co do tego, dlaczego model odbiega od poprawnego osądu, zapisy przebiegu zawierają bardziej konkretne wskazówki.
Weźmy jako przykład zadanie rozwiązania. Dla tej samej reakcji polimeryzacji kolejno zmieniono 12 rozpuszczalników, a zadanie wymagało uszeregowania według masy ostatecznie wyodrębnionego polimeru.
Opus 5.5 uzyskał wynik 0,874, podczas gdy Qwen3.8 uzyskał -0,126. Dwanaście warunków kandydackich rozpuszczalników zestawiono parami, co dało w sumie 66 par; pierwszy uszeregował poprawnie 56 par, a drugi uszeregował poprawnie 30 par.

△Dwa przebiegi Opus i Qwen w tym samym zadaniu
Analiza wykazała, że wynika to z faktu, iż oba modele od samego początku różniły się pod względem czynników, na których się skupiały:
Qwen3.8 szeregował głównie na podstawie tego, ile etylenu rozpuszczalnik może rozpuścić, podczas gdy Opus 5.5 zwracał większą uwagę na mieszalność surowców i kompatybilność katalizatora w rozpuszczalniku.
Chociaż Qwen3.8 również odkrył ten problem w trakcie procesu obliczeń, ostatecznie nie zdołał bezpośrednio zmienić podstawy szeregowania ostatecznie przyjętej przez model.
Dlatego etapem, na którym najprawdopodobniej wystąpią błędy predykcji, jest krok wyboru podstawy osądu. Model musi również nauczyć się dostosowywać metodę szeregowania w czasie rzeczywistym zgodnie ze wskazówkami, aby te odkrycia mogły rzeczywiście wpłynąć na odpowiedź.
Rozkładając to, te różnice również zmieniają się w zależności od konkretnej dyscypliny i zadania.
Wśród ocenionych wyników dla każdej dyscypliny w zadaniach publicznych najwyższy średni wynik w chemii uzyskał Opus 5.5, w nauce o materiałach Fable 5.1, w biologii GPT-6 Astra Medium, a w medycynie Opus 5.
P.S. Fable 5.1 i Opus 5.5 wykazywały zachowanie polegające na odmowie odpowiedzi.

△Wyniki każdego modelu w czterech dyscyplinach
Jeśli więc przygotowujesz się do zaangażowania AI w określony rodzaj badań, możesz najpierw znaleźć powiązane zadanie i przetestować je za pomocą SPU, a formalne eksperymenty rozpocząć dopiero po potwierdzeniu, że model jest rzeczywiście odpowiedni.
Wyniki zadań prywatnych czynią ten punkt jeszcze bardziej konkretnym.
Spośród 13 konfiguracji 12 miało średnie wyniki znacznie wyższe niż losowe szeregowanie, a między konfiguracjami nie wykryto oczywistych różnic. Natomiast zmienność wprowadzana przez różne zadania była szczególnie uderzająca.
Dla tej samej partii elektrolitów, przy przewidywaniu przewodności jonowej współczynniki korelacji rangowej 13 konfiguracji koncentrowały się w przedziale od 0,89 do 0,95; po przełączeniu na okno elektrochemiczne wyniki 12 konfiguracji, które otrzymały oceny, wahały się od -0,55 do 0,07, żaden nie przekroczył progu poziomu losowego.
Model się nie zmienił, ale gdy tylko zmienił się cel pomiaru, rozkład ocen również wyraźnie się zmienił.
Więc następnym razem, gdy będziesz oceniać model, samo stwierdzenie, że jest dobry w chemii, nie jest wystarczająco konkretne; musisz także zobaczyć, z jakim konkretnym celem pomiaru i jakimi warunkami eksperymentalnymi ma do czynienia.

△Wydajność predykcyjna każdego modelu na 16 prywatnych zadaniach
Oto kolejna dość kontrintuicyjna rzecz:
Ogólnie rzecz biorąc, danienie modelowi więcej czasu i wyższej intensywności rozumowania powinno sprawić, że wynik będzie dalej rósł, prawda?
Wszyscy generalnie tak myślą i wszyscy tak robią.
Ale zgadnijcie co? Gdy tylko pojawiły się wyniki SPU, bezpośrednio uderzyły nas w twarz—
Przy tych samych 8 godzinach obliczeń zespół badawczy zmienił GPT-6 Astra ze średniej intensywności rozumowania na najwyższą. Mediana czasu wykonania przy najwyższej intensywności wzrosła do 4,8 razy, a mediana kosztu API również wzrosła do 5,3 razy.
Ale wynik predykcji... ledwo się poruszył.
Hę? Zespół badawczy nawet wrócił specjalnie, aby przejrzeć zapisy uruchomień modelu.
I proszę, na 79 ukończonych zadaniach GPT-6 Astra przy najwyższej intensywności rozumowania zwykle udzielał już odpowiedzi w medianie 26% czasu wykonania.
Model nie próżnował później; kontynuował obliczenia i korekty, ale były to jedynie drobne dostosowania i nie przejawiały się jako różnice w wynikach.
Innymi słowy, wyższa intensywność rozumowania niekoniecznie daje lepsze wyniki.

△Nakłady i wydajność GPT-6 Astra przy dwóch intensywnościach rozumowania
To zjawisko służy również jako przypomnienie dla alokacji zasobów modelu: jeśli chcesz dodać obliczenia, nie rzucaj się na oślep—to czasochłonne, pracochłonne i może nawet się nie opłacić.
Zamiast tego możesz dokładniej przeanalizować zapisy uruchomień, najpierw w pełni zrozumieć, której ocenie faktycznie odpowiadają nowo dodane dowody, a następnie celowo wzmocnić moc obliczeniową lokalnie.
W rzeczywistości podobne zjawisko pojawia się również w użyciu narzędzi.
W każdym uruchomieniu mediana liczby kategorii metod używanych przez GPT-6 Astra Max wynosi 4, podczas gdy dla Medium wynosi 1, jednak między tymi dwiema konfiguracjami nie wykryto istotnej różnicy w wynikach.
Powód jest bardzo podobny: dobre narzędzia nie zostały użyte tam, gdzie miały największe znaczenie.
Na przykład w przypadku próbkowania Monte Carlo, chociaż model wywołuje to narzędzie przez większość czasu, dodaje ono jedynie margines błędu do końcowego rankingu i nie wpływa bezpośrednio na sam wynik.

△Wywoływanie narzędzi obliczeń naukowych
Więc w rzeczywistości częstsze używanie narzędzi nie jest tak dobre, jak używanie ich precyzyjnie.
Wykorzystanie GPU również zapewnia interesującą perspektywę.
Nawet przy zapewnionej wystarczającej mocy obliczeniowej GPU, tylko 255 uruchomień faktycznie zakończyło się sukcesem w obliczeniach GPU, mniej niż jedna piąta.
Różne modele i różne dyscypliny różnią się pod względem uruchomień GPU, więc samo patrzenie na liczbę wywołań GPU trudno wskazuje na zdolność badawczą modelu.
Aby ocenić, czy moc obliczeniowa pomogła, nadal trzeba zobaczyć, do czego została użyta do obliczeń, czy wyniki obliczeń pomogły w przewidywaniu i jak te wyniki wpłynęły na ostateczny ranking.
Kluczowe jest nadal kierowanie mocy obliczeniowej na wielkości fizyczne istotne dla rankingu, aby model mógł dokładniej zakończyć przewidywania.

△Statystyki wykorzystania GPU
Patrząc łącznie na koszty, średni koszt API na uruchomienie w różnych konfiguracjach wynosi od 0,22 do 65,91 USD, co stanowi różnicę aż 300 razy.
Oznacza to, że SPU zapewnia zarówno wydajność predykcyjną, jak i koszt wywołania, co jest dobrą referencją dla zespołów przygotowujących się do wdrożenia modeli badawczych.
Od wyników ogólnych do trajektorii poszczególnych pytań, SPU rozwija różnice między modelami w każdy szczegół oceny naukowej, takie jak moc obliczeniowa i koszt.
Jak bardzo wartości obliczone przez AI faktycznie pomagają w przewidywaniu; gdy przewidywanie się nie powiedzie, które oceny należy ponownie przeanalizować... wszystko to można dalej analizować, łącząc wyniki eksperymentów z zapisami uruchomień.
Następna runda ulepszeń ma zatem jasny kierunek do wypróbowania:
Według SPU, model może szybciej wykrywać błędne hipotezy i zachowywać lub modyfikować rankingi z większym uzasadnieniem. Po zmianach należy ponownie umieścić go w tym samym zadaniu, aby sprawdzić, czy przewidywania stają się dokładniejsze.
Wprowadzenie „testowania zrozumienia” do sali egzaminacyjnej modelu
Można powiedzieć, że SPU jest wysoce spójne z wzorcami rozwoju AI4S.
Ocena AI4S stopniowo pogłębia się w kierunku rzeczywistych etapów eksperymentalnych, a benchmarki ukierunkowane na wykonywanie eksperymentów również pojawiają się w tym roku.
Jednak poza wykonywaniem, przewidywanie, jako nieunikniony krok w procesie badawczym i najtrudniejszy do skwantyfikowania, w końcu ma mierzalny sposób.
Korzyści przejawiają się w dwóch aspektach:
Badacze mogą dzięki temu analizować, które cele pomiarowe są łatwiejsze do przewidzenia, które zadania różnią się najbardziej i jak powstaje błędna ocena. Może to oszczędzić kosztowne i cenne zasoby eksperymentalne oraz skrócić czas podejmowania decyzji.
Dla rozwoju modeli zapewnia to również bardziej konkretną referencję do ulepszeń.
Wraz ze wzrostem liczby typów eksperymentów ocena może również odpowiadać na bardziej konkretne pytania: dla jakich materiałów, warunków eksperymentalnych i metod pomiarowych rankingi podawane przez AI są bardziej wiarygodne i bardziej warte odniesienia.
Naukowcy mogą w ten sposób stale gromadzić postęp wokół tego samego typu pytań.

W rzeczywistości SPU to tylko wierzchołek góry lodowej w serii ocen rzeczywistej pracy UniPat AI:
- ScienceVision: koncentruje się na tym, jak modele pozyskują dowody z trójwymiarowych obiektów naukowych i odpowiadają na pytania;
- PaperBenchX: zamienia opublikowane badania w wykonalne, weryfikowalne zadania reprodukcji artykułów;
- SaaS-Bench i EvoCode-Bench: odpowiednio badają rzeczywiste procesy oprogramowania oraz pracę rozwojową, gdy wymagania stale się zmieniają. ...
Te prace obejmują badania naukowe, pracę biurową i rozwój oprogramowania, a wszystkie łączy troska o to, jak AI wykonuje zadania po wejściu w określoną pracę oraz jak wyniki są weryfikowane.
Pośrednio odzwierciedla to również, że UniPat AI ma unikalny wgląd w branżę i dalekowzroczny osąd dotyczący ruchu AI w stronę praktyki badań naukowych, a nawet w stronę rzeczywistego świata.
UniPat AI demonstruje również nowy typ modelu współpracy AI:
Eksperci dziedzinowi uczestniczą w selekcji i przeglądzie zadań, laboratoria partnerskie dostarczają niepublikowane zadania, a zespół projektowy organizuje eksperymenty z różnych dyscyplin w jednolite zadania ewaluacyjne.
Biorąc za przykład SPU, jest on prowadzony przez UniPat AI, a instytucje członków doradczych obejmują Stanford, Cornell, Harvard, UIC, Uniwersytet Pekiński, HKUST i FutureHouse. Współpracownicy wet-lab z Yourui Saishi, Aibotaike, Deep Principle i Enhe Biology uczestniczyli w powiązanych pracach eksperymentalnych.
Wiedza interdyscyplinarna i zasoby eksperymentalne wchodzą tym samym w ten sam proces ewaluacji. SPU niesie nie tylko selekcję problemów, ale także przedstawia współpracę niezbędną do zorganizowania problemów badawczych w wykonalne zadania.
Obecnie 100 publicznych zadań związanych z SPU planuje się udostępnić jako kompletne pakiety zadań Harbor; 16 zadań prywatnych pozostanie prywatnych do kontrolowanej ewaluacji. Zarówno zbiór danych, jak i kod zostały udostępnione jako open source.
Trzeba przyznać, że dzisiejsza AI w obliczu tego mechanizmu SPU jest wciąż tylko nowicjuszem.
Potrafi używać narzędzi z prędkością błyskawicy i w ciągu 8 godzin zainstalować trzy zestawy oprogramowania, dokończyć uruchamianie DFT, a następnie uruchomić Monte Carlo, ale w najkrytyczniejszym osądzie nie nauczyła się jeszcze zadać sobie jednego pytania: czy wielkość, którą obliczam, jest właśnie tą wielkością, którą eksperyment naprawdę musi zmierzyć.
Ale wraz z dalszym gromadzeniem się takich zadań stanie się również jasne, jakiego rodzaju pracę badawczą AI może podjąć.
SPU zmierzył ten dystans, a każdy kolejny egzamin jest zapisem tego, jak AI zbliża się do prawdziwego stołu eksperymentalnego.
Ten artykuł pochodzi z publicznego konta WeChat „Quantum位” (ID: QbitAI), autor: Focus on Frontier Technology





