Dzisiejsi Agenci potrafią już sprawnie wywoływać narzędzia, modyfikować pliki i uruchamiać testy, ale czy w obliczu dużego systemu oprogramowania, który ewoluował przez długi czas, potrafią wyjść od nowego wymagania i dostarczyć kompletną funkcję?
Gdy kierownik produktu zgłasza nowe wymaganie, deweloperzy często nie otrzymują listy plików ani sygnatur funkcji. Najpierw muszą zrozumieć ograniczenia, prześledzić zależności między modułami, a następnie ustalić, gdzie wprowadzić zmiany, jak je wprowadzić i jak udowodnić, że zmiany są poprawne. Te analizy wpływają na późniejsze dostarczenie.
Uniwersytet Fudan, City University of Hong Kong, The Chinese University of Hong Kong i inne instytucje proponują LoLBench, który umieszcza Agentów w systemach oprogramowania o średniej około 2,4 miliona linii kodu źródłowego, ocenia pełny proces od propozycji funkcji do dostarczenia modułu oraz testuje zdolność percepcji do ugruntowania wymagań w systemie, a także zdolność implementacji do wykonania modyfikacji międzymodułowych.
Link do artykułu: https://arxiv.org/abs/2609.37143
Zbiór danych: https://huggingface.co/datasets/lolbench26/LoLBench
Eksperymenty ujawniają kluczowy punkt przełamania: Agent może dokonać poprawnej lokalnej zmiany, ale pominąć zmiany w innych modułach, które muszą zostać zsynchronizowane. Nawet przy dodatkowych wskazówkach implementacyjnych większość zadań pozostaje nierozwiązana, a od zrozumienia wymagań do ukończenia dostarczenia wciąż jest daleka droga.
Przedefiniowanie długohoryzontowych zadań kodowych
Jakiego rodzaju długohoryzontowe zadanie kodowe ma rzeczywistą wartość inżynierską?
„Długohoryzontowości” nie można oceniać wyłącznie na podstawie zużytego czasu, liczby rund ani zużycia Tokenów. Na przykład polecenie Agentowi wypisywania jednej liczby na minutę, licząc od 1 do 1000, zajmuje dużo czasu, ale wymaga jedynie prostej pętli. Zadania lokalnego naprawiania błędów w stylu SWE-bench również nie obejmują wyzwania od analizy wymagań do dostarczenia modułu.
Długohoryzontowe zadania kodowe, na których koncentruje się LoLBench, to rozwój modułów dla złożonych systemów. Po otrzymaniu nowego wymagania deweloperzy wielokrotnie analizują: jakie zachowania muszą zostać zaimplementowane? Czy istniejąca architektura może je obsłużyć? Które zależności zostaną dotknięte? Jak zweryfikować? LoLBench włącza również tę analizę ukrytą w umysłach deweloperów do oceny, pozwalając Agentowi samodzielnie wyprowadzić plan implementacji z intencji użytkownika.
Takie zadania jednocześnie mają złożoność percepcji i złożoność implementacji: pierwsza to trudność zrozumienia propozycji, zidentyfikowania ukrytych ograniczeń i zależności międzymodułowych oraz wyprowadzenia zakresu modyfikacji i specyfikacji implementacji; druga to trudność przekształcenia specyfikacji w poprawne modyfikacje obejmujące wiele plików oraz, poprzez testowanie i naprawę, zapobieżenia zepsuciu istniejącej funkcjonalności.
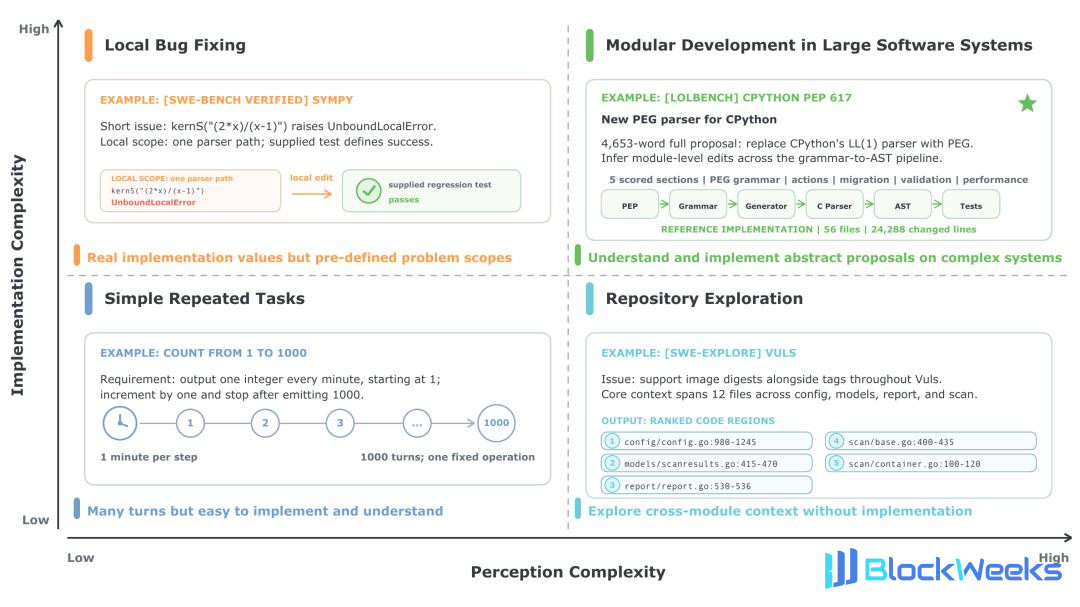
Rysunek 1 Porównanie złożoności percepcji i złożoności implementacji.
Jak LoLBench ocenia oba rodzaje złożoności jednocześnie
Wyprowadzanie specyfikacji implementacji z propozycji funkcji
LoLBench wybiera 100 zadań z propozycji ulepszeń społeczności i odpowiadających im scalonych PR-ów, obejmujących 29 systemów, 8 języków i 5 dziedzin.
Agent otrzymuje jedynie propozycję i repozytorium kodu sprzed implementacji; propozycja ma średnio około 5000 angielskich słów. Ocena jest przeprowadzana w offline'owym środowisku Docker, aby zapobiec pobieraniu przez Agenta implementacji upstream.
Na przykład PEP 617 [1] proponuje zastąpienie parsera LL(1) CPythona przez PEG, a implementacja wymaga połączenia definicji gramatyki, generowania parsera, drzew składniowych i raportowania błędów. Agent musi zidentyfikować cały łańcuch implementacji.
Pod względem złożoności percepcji średni wskaźnik wzmianek w propozycji nazw klas docelowych w implementacji referencyjnej LoLBench wynosi tylko 7,3%, mniej niż połowa SWE-bench Verified (15,9%) i mniej niż jedna piąta FeatureBench (38,7%). Agent musi samodzielnie wywnioskować związek między wymaganiami a kodem.
Przekształcanie specyfikacji w dostawę inżynierską
Pod względem złożoności implementacji repozytoria LoLBench mają średnio około 2,4 miliona linii kodu źródłowego, około 9,4 razy więcej niż SWE-bench Verified i 4,9 razy więcej niż FeatureBench; implementacje zmieniają średnio 5 499 linii, w porównaniu z 38 liniami i 2 050 liniami w przypadku tych dwóch. Każde zadanie zmienia średnio 64,9 plików, 40,1 klas i 195,9 funkcji; liczba plików jest odpowiednio 25 razy i 4,2 razy większa niż w tych dwóch. Koordynacja i weryfikacja między modułami są trudniejsze.

Tabela 1 Porównanie LoLBench z istniejącymi zestawami ewaluacyjnymi zadań kodowych.
LoLBench weryfikuje poprawność dostawy za pomocą dwóch typów testów: testy nowych funkcji (F2P) wymagają niepowodzenia przed implementacją i przejścia po implementacji; F2P weryfikuje zachowanie poprzez publiczne interfejsy i pozwala na różne implementacje wewnętrzne. Testy regresji (P2P) wymagają przejścia zarówno przed, jak i po.
Oprócz oryginalnych testów projektu zespół badawczy konstruuje błędne implementacje, takie jak brakujące funkcje i zmanipulowane wymagania, jako mutanty, uzupełnia przypadki testowe w celu wykrycia przeoczonych błędów i poprawia pokrycie testowe referencyjnych poprawek.
Po wzmocnieniu wskaźnik wykrywalności 1 688 mutantów wzrasta z około 61% do 96%, a średnie pokrycie linii na zadanie dla F2P wzrasta z około 60% do 79%.
Wydajność i wąskie gardła 28 kombinacji Agentów
Zmieniając modele lub szkielety, najwyższy wskaźnik rozwiązania Agenta wynosi tylko 14%
Zespół badawczy ocenia 28 dostępnych kombinacji 6 wiodących modeli i 5 szkieletów, z limitem czasu 6 godzin na zadanie. Opus 5 w połączeniu z Claude Code lub mini-SWE-agent osiągają ex aequo najwyższy wskaźnik rozwiązania na poziomie 14%, a mediana wszystkich kombinacji wynosi tylko 2%.

Tabela 2 Główne wyniki eksperymentalne w artykule
Przy użyciu również Opus 5, mini-SWE-agent i Claude Code osiągnęły ten sam wskaźnik rozwiązania, ale pierwszy zajął 3,2 razy więcej czasu niż drugi i wygenerował 5 razy więcej tokenów; większe zużycie nie przyniosło wyższego wskaźnika rozwiązania.
Duża ilość interakcji i tokenów jest zużywana na lokalizację kodu
Pod względem zużycia tokenów, uśredniając po agentach, etap lokalizacji odpowiadał za 52,4% niebuforowanych tokenów wejściowych i 45,4% wygenerowanych tokenów. Pod względem liczby rund interakcji agenta etap lokalizacji również miał znacznie więcej rund interakcji niż inne etapy.

Rysunek 2 Średnia liczba rund interakcji na każdym etapie.
W przypadku istniejących plików i funkcji zmodyfikowanych względem implementacji referencyjnej, we wszystkich 28 grupach agentów precyzja modyfikacji plików wynosiła od 38,0% do 80,4%, a pełność (recall) od 30,3% do 65,0%; precyzja modyfikacji funkcji wynosiła od 54,2% do 65,6%, a pełność (recall) od 20,8% do 53,4%. Dokładność lokalizacji kodu jest niska, a pokrycie pozostaje niekompletne.
Nawet po uzupełnieniu wskazówek dotyczących modyfikacji agenci wciąż mają trudności z dostarczeniem kompletnych rozwiązań
Zespół badawczy zachował pierwotną propozycję funkcji i dodatkowo udostępnił drzewo plików modyfikacji wyeksportowane z implementacji referencyjnej oraz specyfikacje implementacji API, aby pomóc agentom określić zakres modyfikacji. Wskaźnik rozwiązania Opus 5+Claude Code wzrósł z 14% do 34%, GPT-5.6 Sol+Codex wzrósł z 3% do 25%,
DeepSeek
V4 Flash+OpenCode wzrósł z 1% do 17%.

Tabela 3 Wyniki eksperymentów po uzupełnieniu drzewa plików modyfikacji i specyfikacji implementacji API
Uzupełnienie wskazówek dotyczących modyfikacji może złagodzić obciążenie percepcyjne, ale najlepsza kombinacja wciąż miała 66% zadań nierozwiązanych. Agenci nadal muszą koordynować moduły, implementować interfejsy i przechodzić walidację, co sugeruje, że złożoność implementacji dużych systemów jest również bardzo wysoka.
Od generowania kodu w kierunku ewolucji dużych systemów oprogramowania
Te wyniki dostarczają weryfikowalnych kierunków dla badań i rozwoju agentów: czy wyszukiwanie w repozytorium może objąć kluczowe zależności, czy specyfikacje implementacji przed kodowaniem są kompletne oraz czy walidacja może na czas wykryć pominięcia między modułami.
Wartość inżynierii oprogramowania polega na tym, czy wymagania użytkownika mogą zostać niezawodnie spełnione. Agenci muszą rozumieć, dlaczego zmiany zachodzą, jak wpływają na system i w pełni implementować zmiany. LoLBench ma nadzieję promować ocenę zdolności agentów od generowania kodu w kierunku wspierania ciągłej ewolucji oprogramowania, czyniąc wyniki dostarczenia miarą testowania zdolności agentów.
Źródło: PEP 617: https://peps.python.org/pep-0617/
Ten artykuł pochodzi z publicznego konta WeChat „Xinzhiyuan”, autor: Xinzhiyuan; redaktor: LRST