
Około 90% własnego kodu Claude Code zostało już przekazane Claude'owi do napisania.
Gdy AI pisze kod, liczba zmian odpowiednio wzrosła: od czerwca do września liczba PR-ów scalonych z bazą kodu wzrosła ponad dwukrotnie.
W całym Anthropic liczba zmian scalanych codziennie z główną bazą kodu wzrosła z około 2500 w maju do ponad 30 000 we wrześniu.
Przy takiej ilości kodu, czy ludzie są jeszcze w stanie nadążyć za jego czytaniem? A jeśli nawet przegląd zostanie przekazany AI, kto oceni, czy popełniła błąd?
15 października zespół Claude Code publicznie ujawnił swój wewnętrzny proces przeglądu kodu, ujawniając, że choć liczba PR-ów podwoiła się, odsetek PR-ów wymagających wycofania faktycznie spadł o ponad 40% w stosunku do tego.
Osiągnęli to dzięki sześciu warstwom kontroli oraz mechanizmowi awaryjnemu umożliwiającemu szybkie wykrywanie i szybkie wycofywanie.
Ocena zespołu Claude Code jest następująca:
W tej skali ręczny przegląd linia po linii nie jest już realistyczny.
Ale nie znieśli przeglądu; zamiast tego przekazali większość pracy związanej z czytaniem kodu maszynom.
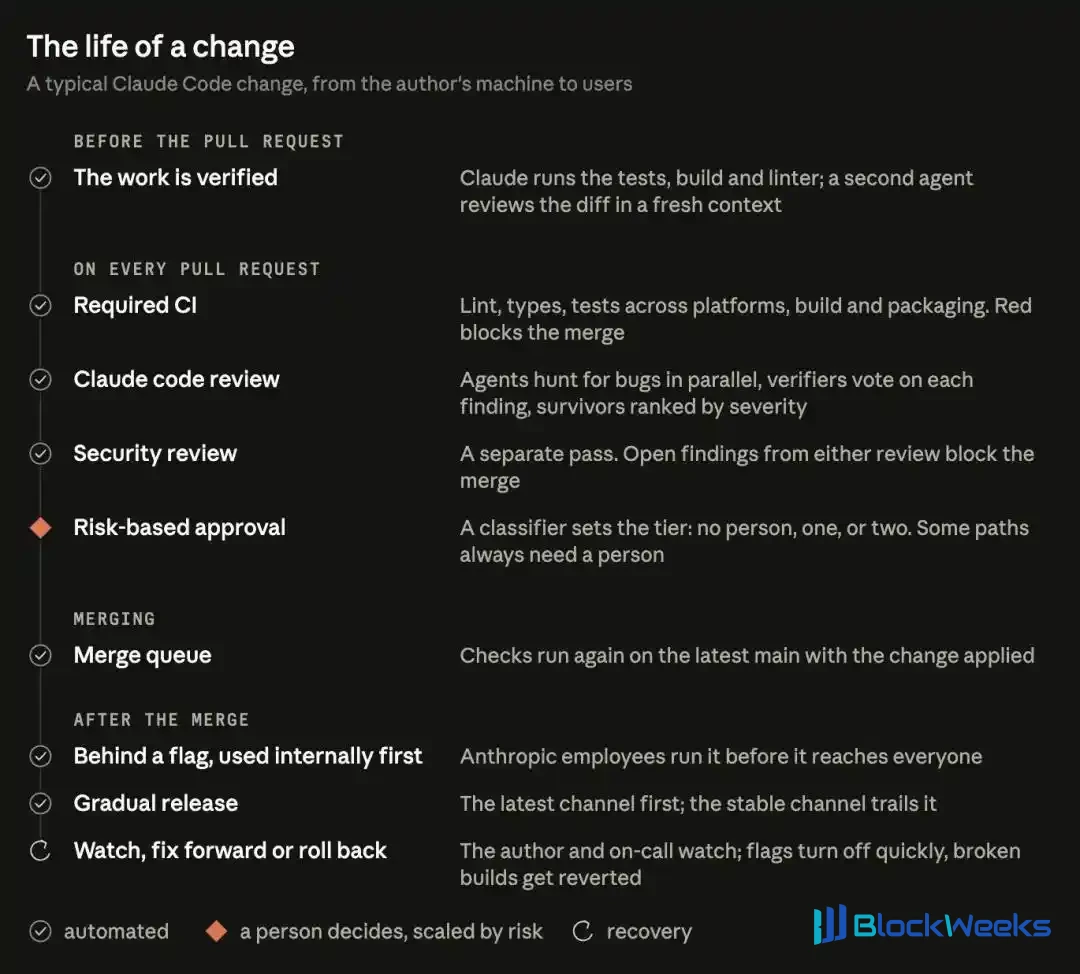
Zanim fragment kodu napisanego przez AI zostanie wdrożony, musi najpierw przejść testy, przejść przegląd AI i bezpieczeństwa, a następnie, w zależności od ryzyka, podejmowana jest decyzja, czy potrzebna jest ludzka aprobata.
W opinii zespołu Claude Code pytanie „czy ktoś przeczytał ten kod” nie jest wystarczająco precyzyjne.
Prawdziwe pytanie powinno brzmieć:
Co może pójść nie tak z tą zmianą, a jeśli pójdzie nie tak, która kontrola powinna to zatrzymać?
Przed ludzkim przeglądem , AI najpierw przedstawia wyniki weryfikacji
Pojedyncza zmiana musi przejść sześć kontroli, z siatką bezpieczeństwa na końcu.
Pierwsza brama pojawia się przed utworzeniem żądania scalenia (PR).
Claude musi uruchomić testy i ukończyć kompilację; w przypadku zmian dotyczących interfejsu musi również wykonać zrzuty ekranu do porównania z makietami projektowymi.
Następnie wysyłany jest podagent korzystający ze świeżego kontekstu, aby przejrzał różnicę kodu; nie uczestniczył on w pisaniu kodu i ma za zadanie wyłącznie znajdować błędy.
Oficjalne wymaganie jest bardzo jasne:
Claude musi przedstawić wykonane polecenia i ich dane wyjściowe; samo odpowiedzenie „wszystkie testy przeszły” nie liczy się.
Zwykli programiści mogą postępować podobnie: gdy dają AI zadanie, powinni również jasno określić, jak zostanie zweryfikowana akceptacja.
Druga brama to przegląd AI na PR.
Kilku agentów równolegle szuka błędów, a inna grupa głosuje w celu weryfikacji. Dopiero gdy osiągnięta zostanie wystarczająca liczba głosów, problem zostanie opublikowany w PR.
Komentarze dotyczące wyłącznie stylu kodu, wskazówek diagnostycznych lub porządkowania kodu nie będą publikowane w PR i są bezpośrednio filtrowane.
Gdy ten system przeglądu został po raz pierwszy uruchomiony w marcu, odsetek wewnętrznych PR otrzymujących merytoryczne komentarze z przeglądu wzrósł z 16% do 54%.
Trzecią bramką jest przegląd bezpieczeństwa.
W zespole, dopóki ustalenia pozostawione przez przegląd kodu lub przegląd bezpieczeństwa pozostają nierozwiązane, PR nie może zostać scalony: albo je naprawić, albo zamknąć z pisemnym uzasadnieniem.
Czwartą bramką są kontrole ciągłej integracji (CI), obejmujące standardy kodu, sprawdzanie typów, testy platformowe i pakowanie kompilacji.
Pojedyncza zwykła zmiana narzędzia wiersza poleceń (CLI) może wymagać uruchomienia dziesiątek kontroli, zanim zostanie przekazana do przeglądu przez człowieka.
Powtarzające się problemy muszą również stać się podstawą następnej rundy kontroli.
CLAUDE.md rejestruje konwencje projektu, a REVIEW.md mówi recenzentowi, na czym się skupić, a co można pominąć, aby problemy znalezione tym razem stały się doświadczeniem dla następnego przeglądu.
Gdy ten sam komentarz zostanie wspomniany po raz trzeci, należy go zapisać w regułach.
Piątą bramką jest zatwierdzenie przez człowieka, które jest najbardziej krytyczne; omówimy je szczegółowo w następnej sekcji.
Szóstą bramką jest scalenie i wydanie.
Po przejściu poprzednich bramek zmiana nadal musi wejść do kolejki scalania i poczekać na swoją kolej.
Gdy nadejdzie jej kolej, system umieszcza ją na najnowszej wersji gałęzi głównej i wszystkie kontrole uruchamiają się ponownie.
Ten krok chroni przed sytuacją, w której „każda część osobno jest w porządku, ale po połączeniu pojawiają się problemy”.
Po scaleniu nowe funkcje również nie są natychmiast wypychane do wszystkich użytkowników.
Najpierw są ukryte za flagami funkcji i udostępniane wyłącznie wewnętrznym pracownikom Anthropic. Pracownicy intensywnie korzystają z nich codziennie i często napotykają problemy wcześniej niż użytkownicy zewnętrzni.
A flaga funkcji jest jak główny wyłącznik: bez zmiany kodu lub ponownego wydania wersji może zdecydować, czy funkcja jest włączona, czy wyłączona.
Na koniec pozostaje mechanizm awaryjny.
Jeśli pojawi się problem, najpierw pociągnij główny wyłącznik.
Zespół rotacyjnie pełni dyżur co tydzień, a każde analiza powypadkowa incydentu musi zadać pytanie: na której bramce powinno to zostać zatrzymane?
Zatem przegląd nie zniknął — stał się warstwą za warstwą kontroli przebiegających przez rozwój, scalanie i wydanie.
Gdzie są granice zatwierdzania bez udziału człowieka
Po tym, jak pierwsze cztery bramki są wszystkie zielone, piąta bramka decyduje, na podstawie podziału na poziomy ryzyka, ile osób musi zatwierdzić tę zmianę.
Dokumentacja, teksty, funkcje widoczne tylko wewnętrznie oraz nowe zmiany ukryte za flagami są niskiego ryzyka; po przejściu zautomatyzowanego przeglądu i kontroli bezpieczeństwa mogą pominąć zatwierdzenie przez człowieka.
Zwykłe zmiany produktu, a także wrażliwe obszary, takie jak buforowanie, automatyczny aktualizator i prompty systemowe, wymagają jednej osoby.
Kod o najwyższym ryzyku, a także garść wyznaczonych ścieżek, wymaga dwóch osób.
Na pierwszy rzut oka zmiany niskiego ryzyka są już „bez kierowcy”?
To nie jest takie proste.
Poziom ryzyka jest określany przez samą zmianę: pierwszy klasyfikator czyta kod i ustala ryzyko, a drugi następnie decyduje, czy potrzebne jest dodatkowe zatwierdzenie przez człowieka.
Wrażliwe ścieżki oznaczone przez właścicieli kodu, a także wszystkie pliki przepływów pracy CI, muszą zostać przejrzane przez człowieka.
Uproszczony kanał zatwierdzania również ma próg: jest otwarty tylko dla osób z listy „zaufanych autorów” repozytorium; każdy spoza listy musi znaleźć inną osobę do zatwierdzenia.
Osoba kierująca AI do pisania kodu sama liczy się jako recenzent i musi wziąć odpowiedzialność za zmianę tak, jakby napisała kod ręcznie.
Zatwierdzanie bez udziału człowieka nie oznacza braku odpowiedzialności.
Ludzie muszą zdecydować, czy funkcja powinna zostać zbudowana, czy architektura jest rozsądna i czy istniejące kontrole mogą pokryć ryzyko tej zmiany.
Zespół Claude Code ma więc zasadę: kod, który scalasz — jeśli coś pójdzie nie tak, zwykle to ty go naprawiasz.
Przed kliknięciem zatwierdzenia recenzent musi umieć jasno wyjaśnić: co sprawdziły te kontrole i jakie ryzyka pozostają niepokryte.
Jeśli nie potrafisz tego wyjaśnić, nie spiesz się z kliknięciem zatwierdzenia — najpierw dodaj niezbędną recenzję.
Recenzja AI też może zawieść
Zautomatyzowana recenzja również może się zaciąć.
PR projektu CLI przeszedł przez ponad pięćdziesiąt rund recenzji i poprawek w ciągu nocy, aż autor w końcu ręcznie to zatrzymał.
Człowiek może zignorować drobny problem w sekundę, ale AI tego nie zrobi — sumiennie pójdzie go naprawić, a po naprawie pojawia się kolejny commit i kolejna runda recenzji.
Zespół użył git blame, aby prześledzić historię, i odkrył, że spośród problemów wielokrotnie oznaczanych przez recenzenta około 59% stanowił stary kod, który istniał przed pierwszą rundą recenzji. Rzadko znajdował nowe błędy; w każdej rundzie wykopywał tylko kilka kolejnych starych.
Później zmienili cztery zasady:
Jeśli po trzech rundach nadal nie przeszło, przypomnij autorowi, aby się cofnął i przemyślał podejście;
Po pierwszych kilku rundach recenzuj tylko nowo dodane zmiany;
Wskazuj problemy tego samego rodzaju wszystkie naraz;
Nie powtarzaj problemów, które zostały już zgłoszone.
Efekt był natychmiastowy.
Udział wewnętrznych PR-ów, które przeszły po jednej rundzie recenzji i poprawek, wzrósł z 65% do 78%; te wymagające pięciu lub więcej rund spadły z 8,9% do 1,5%; średnia liczba recenzji spadła z 2,08 do 1,32.

Po dostosowaniu zasad ponownej recenzji odsetek przejść po jednej rundzie recenzji i poprawek wzrósł z 65% do 78%, a średnia liczba recenzji spadła z 2,08 do 1,32.
Sztuka recenzji to w połowie znajdowanie problemów, a w połowie wiedza, kiedy przestać.
Czy wielowarstwowa recenzja oznacza, że jest niezawodna?
Samo Anthropic podało kontrprzykład.
26 marca Claude Code wydało optymalizację: gdy sesja pozostaje bezczynna przez ponad godzinę, raz wyczyść stare zapisy rozumowania.
Ale błąd sprawił, że uruchamiało czyszczenie przy każdej turze po wznowieniu rozmowy. W rezultacie Claude stał się zapominalski, zaczął się powtarzać i nieprawidłowo używał narzędzi. Błąd naprawiono dopiero 10 kwietnia.

Po bezczynności stare rozumowanie powinno zostać wyczyszczone tylko raz, ale w rzeczywistości czyściło przy każdej turze; czerwona ramka oznacza błędnie usuniętą treść.
Oficjalny postmortem z 23 kwietnia przyznał:
Ta zmiana przeszła przez wiele rund recenzji ludzkiej i automatycznej; testy jednostkowe, testy end-to-end i wewnętrzne dogfooding nie zdołały tego wychwycić, a samo potwierdzenie przyczyny źródłowej zajęło ponad tydzień.
Punkt zwrotny nastąpił w postmortem.
Zespół ponownie przejrzał PR, który spowodował incydent, za pomocą Code Review; przy wystarczającym kontekście z odpowiednich repozytoriów Opus 4.7 znalazł błąd, podczas gdy Opus 4.6 nie.
Ten backtest pokazał, że zarówno zdolności modelu, jak i kompletność kontekstu wpływają na wyniki wykrywania. Więc włączyli do recenzji więcej repozytoriów.
Dziś każdy incydent staje się pytaniem egzaminacyjnym.
Zespół zbiera PR-y, inżynierowie znający kod potwierdzają jeden po drugim błędy w nich zawarte i kompilują je w zestaw testowy.
Recenzent codziennie uruchamia się na tym zestawie testowym. Za każdym razem, gdy dostosowywane są prompty, narzędzia lub modele, jest on również używany do sprawdzenia efektu: jeśli wynik się nie poprawia, dostosowanie nie jest przyjmowane.
Zespół również nie wyolbrzymiał.
Po wdrożeniu zmian programiści i personel dyżurny nadal muszą dostrzegać anomalie za pomocą pulpitów danych.
Mechanizm „wyłącznika awaryjnego”, który automatycznie zaostrza zatwierdzanie na podstawie metryk, takich jak wskaźnik wycofań, nie został jeszcze zbudowany. Inżynierowie chcą najpierw dodać tę zabezpieczenie, zanim pozwolą na przejście większej liczby zmian przez zatwierdzanie bez udziału człowieka.
Przegląd nieuchronnie coś przeoczy; wykrywanie i naprawianie muszą nadążać.
Jeden z członków zespołu Claude Code wyjaśnił to tak: spowolnienie rzeczywiście zmniejsza błędy, ale głównie dlatego, że robisz mniej wszystkiego. Dlatego wolą poświęcać wysiłek na szybsze znajdowanie problemów i szybsze ich naprawianie.
Kiedy jedna osoba pisze kod z AI, co trzeba zaakceptować
Przegląd AI daje tylko opinie; nadal ty podejmujesz decyzję.
Więc nie spiesz się, by dążyć do „nie trzeba patrzeć” — zamiast tego najpierw spraw, by AI odpowiadało na trzy pytania przy każdej dostawie.
Po pierwsze, jak to zostało zweryfikowane?
Jakie kontrole zostały uruchomione, jakie były wyniki i które przypadki nie są jeszcze pokryte.
Boris Cherny, twórca Claude Code, powiedział, że danie Claude'owi sposobu na zweryfikowanie samego siebie może być najważniejszą rzeczą. Szacuje, że może to sprawić, iż jakość końcowego wyniku osiągnie 2 do 3 razy pierwotnej.

Boris Cherny zaleca pozwolenie Claude'owi na weryfikację własnej pracy, aby utworzyć pętlę informacji zwrotnej; szacuje, że jakość końcowego wyniku można poprawić do 2–3 razy.
Po drugie, na co to wpłynie?
Którzy użytkownicy, dane i uprawnienia są zaangażowane w zmianę.
Jeśli zlecisz AI dodanie funkcji udostępniania do narzędzia raportowego, musisz jasno zapytać: kto może otworzyć link i co można zobaczyć po jego otwarciu.
Po trzecie, jak wycofać zmiany, jeśli coś pójdzie nie tak? Czy można jednym kliknięciem wyłączyć nową funkcję i przywrócić poprzednią wersję.
Zatwierdź archiwum przed rozpoczęciem i utrzymuj każdą zmianę tak małą, jak to możliwe. Najpierw miej możliwość wycofania, potem mów o rzadszym przeglądzie.
Oprócz tych trzech pytań wykształć jeszcze trzy nawyki.
Po pierwsze, przeglądaj innym „mózgiem”.
W sesji, w której pisze się kod, najłatwiej przymknąć oko na własne błędy.
Otwórz nową sesję lub zleć podagentowi przegląd z całkowicie świeżym kontekstem; lokalne polecenia /code-review i /security-review można również uruchomić bezpośrednio.
Po drugie, klasyfikuj zmiany według poziomów.
W przypadku zmian tekstu i korekt stylu scalaj po przejściu kontroli i potwierdzeniu rzeczywistego efektu; w przypadku wszystkiego, co dotyczy logowania, płatności lub usuwania danych, człowiek musi dokładnie sprawdzić kluczową logikę i dodać ukierunkowane testy.
Na początku bądź surowszy, a gdy procesy weryfikacji i wycofywania będą działać płynnie, stopniowo ograniczaj ręczny przegląd zmian niskiego ryzyka.
Po trzecie, jeśli trzy rundy nie przyniosą rezultatu, zmień podejście.
Jeśli AI poprawiało przez trzy rundy i nadal kręci się w kółko, nie zmuszaj go do czwartej — najpierw zapytaj, czy samo podejście nie jest błędne.
Najważniejsza kwestia: to, że AI mówi „zaliczone”, nie oznacza, że zakończyłeś odbiór.
Zleciłeś mu napisanie kodu, a ty również musisz być odpowiedzialny za wyniki po jego wdrożeniu.
Celem zespołu Claude Code jest to, aby większość PR-ów angażowała co najwyżej jedną osobę, przy jednoczesnym utrzymaniu wskaźnika wycofań i wskaźnika incydentów pod kontrolą.
Uwaga ludzi powinna być w większym stopniu skierowana na ocenę ryzyka, potwierdzanie, czy kontrole są wystarczające, oraz na to, jak naprawić sytuację po wystąpieniu błędów.
Ludzie nie muszą czytać każdej linii kodu, ale każde wydanie musi mieć osobę odpowiedzialną za nie.
Źródła:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Redaktor: Yuanyu
Ten artykuł pochodzi z oficjalnego konta WeChat „Xinzhiyuan” (ID: AI_era), autor: ASI Revelation