Camaradas, a Anthropic está cortando preços novamente. Desta vez, é o modelo mais barato da família Claude, o Haiku.
Em 7 de outubro, a Anthropic lançou oficialmente o Claude Haiku 5.5, alegando ser seu modelo pequeno mais rápido, mais capaz e de menor preço até hoje.
A parte mais ultrajante é o preço, tão baixo quanto $0,1 por milhão de tokens de entrada, um corte direto de 90% em comparação com a geração anterior.
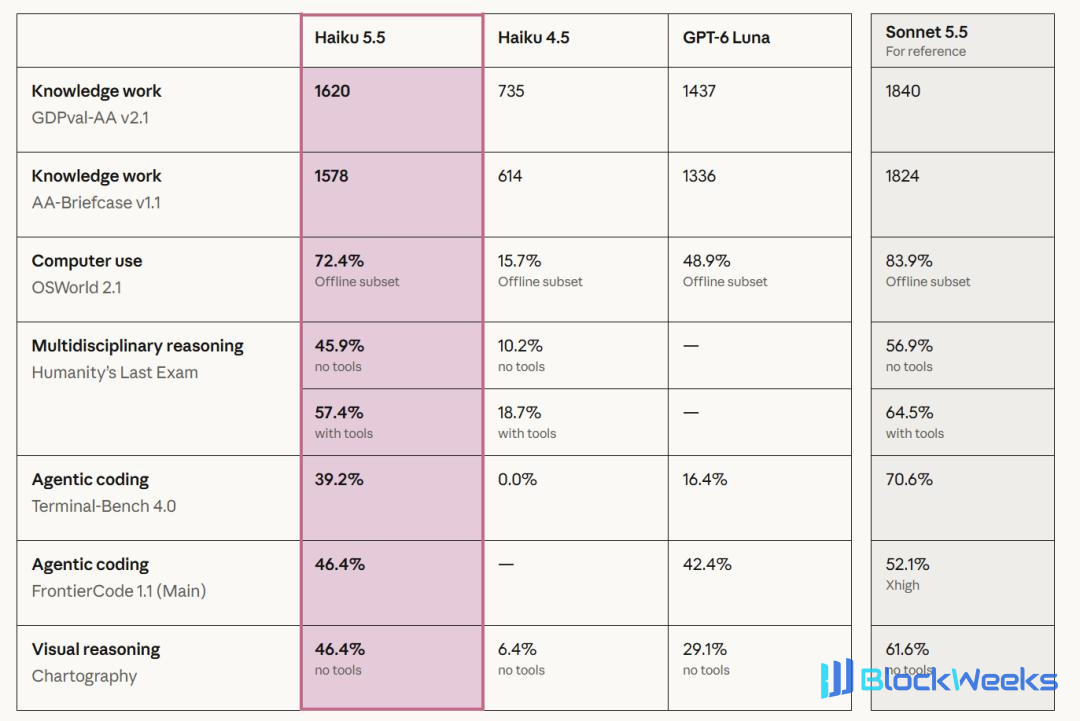
O desempenho também não ficou para trás. De acordo com os resultados de testes publicados pela Anthropic, o Haiku 5.5 supera o GPT-6 Luna da OpenAI em vários benchmarks, incluindo operação de computador, trabalho de conhecimento e programação de Agentes, com algumas pontuações até mostrando uma diferença considerável.
Além disso, o Haiku 5.5 também introduz intensidade de raciocínio ajustável, suportando uma janela de contexto de 1 milhão de tokens e saída de até 128.000 tokens.
Neste ponto, a Anthropic completou a atualização de toda a família Claude 5.5 em apenas 15 dias: Opus 5.5 chegou em 22 de setembro, Sonnet 5.5 foi lançado em 28 de setembro, e agora Haiku 5.5 se juntou oficialmente.
Desta vez, a Anthropic focou naqueles tarefas de IA com volumes massivos de chamadas e extrema sensibilidade a preço.
Múltiplas pontuações superam o GPT-6 Luna, taxa de sucesso em operação de computador de 72,4%
De acordo com as pontuações de Benchmark publicadas pela Anthropic, o Haiku 5.5 alcançou melhorias significativas em relação à geração anterior, e em alguns testes até obteve resultados melhores que o GPT-6 Luna.
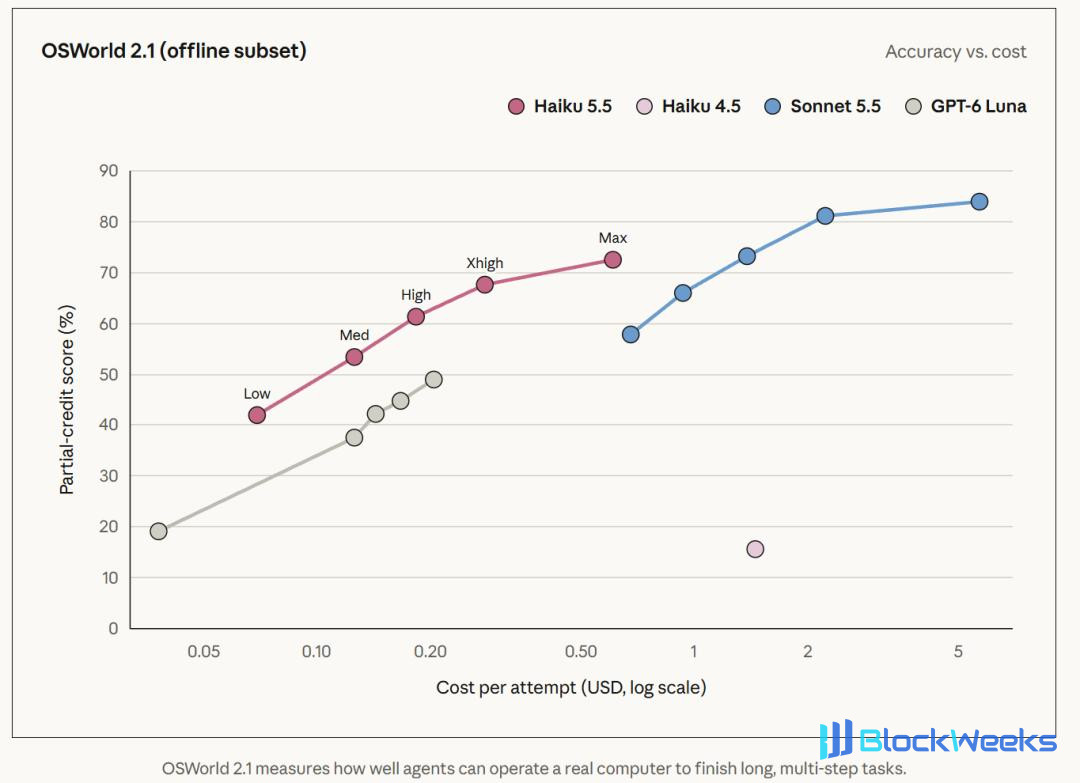
O resultado mais notável vem do OSWorld. Este é um teste que mede a capacidade de um Agente de IA de operar um computador real, exigindo que o modelo complete tarefas de operação multi-etapas e entre aplicativos.
No subconjunto de tarefas offline do OSWorld 2.1, o Haiku 5.5 alcançou uma taxa de sucesso de 72,4%, enquanto a geração anterior Haiku 4.5 tinha apenas 15,7%, e o GPT-6 Luna tinha 48,9%.
Em termos de trabalho de conhecimento, o Haiku 5.5 marcou 1620 no GDPval-AA v2.1, superando os 1437 do GPT-6 Luna. No teste de programação de Agentes Terminal-Bench 4.0, os dois marcaram 39,2% e 16,4%, respectivamente.
No entanto, há um detalhe importante nesses dados. As pontuações mais altas de Benchmark do Haiku 5.5 frequentemente exigem mais computação de raciocínio.
O Haiku 5.5 introduz pela primeira vez intensidade de raciocínio ajustável na série Haiku, permitindo que os desenvolvedores controlem quantos recursos computacionais o modelo investe através do parâmetro effort.
O veículo de mídia VentureBeat notou que no teste Terminal-Bench publicado pela Anthropic, a pontuação de 39,2% corresponde à intensidade máxima de raciocínio. Após mudar para intensidade média de raciocínio, a pontuação cai para cerca de 20%, e a intensidade média é exatamente a configuração padrão do Haiku 5.5.
A agência de avaliação de terceiros Artificial Analysis também observou um fenômeno semelhante. Em sua avaliação do Intelligence Index, o Haiku 5.5 marcou 43 pontos na intensidade máxima de raciocínio e 34 pontos na intensidade média de raciocínio. Sob a mesma avaliação, o custo médio por tarefa foi de cerca de $0,21 e $0,05, respectivamente.
Em outras palavras, o modelo pode trocar um maior orçamento de raciocínio por melhor desempenho na tarefa, mas o custo real também pode aumentar significativamente.
Em seu próprio teste Terminal-Bench 4.0, a Artificial Analysis mediu pontuações de 33% na intensidade máxima de raciocínio e 15% na intensidade média. Devido a diferentes configurações de avaliação, esses números diferem dos resultados oficiais da Anthropic.
É também por isso que, ao analisar o desempenho de modelos pequenos, é preciso considerar ao mesmo tempo a intensidade de raciocínio, a taxa de conclusão de tarefas e o custo real.
Em tarefas de programação de Agentes mais complexas, o Sonnet 5.5 ainda tem uma vantagem clara: sua pontuação no Terminal-Bench 4.0 chega a 70,6%.
A Anthropic também declarou claramente que Sonnet e Opus ainda são mais adequados para tarefas complexas de programação de Agentes, enquanto as vantagens do Haiku estão concentradas em trabalhos de alta frequência e escopo bem definido.
Preço cortado diretamente para um décimo, competindo de igual para igual com o GPT-6 Luna
Se as melhorias de desempenho tornam o Haiku 5.5 competitivo, então o preço pode ser o destaque mais importante deste lançamento. A Anthropic projetou dois níveis de preços de API para o novo modelo.

Para solicitações com comprimento de prompt não superior a 100.000 tokens, os preços unitários de entrada e saída do Haiku 5.5 são ambos 90% menores que os da geração anterior. Acima desse limite, o preço ainda é 50% menor que o do Haiku 4.5.
A Anthropic afirmou que cerca de 90% das solicitações à geração anterior do Haiku estavam dentro de 100.000 tokens. Combinando diferentes comprimentos de solicitação e mudanças no consumo de tokens, a empresa estima que o Haiku 5.5 conclui o custo médio de tarefas semelhantes cai cerca de 75%.
Há também um detalhe facilmente ignorado aqui — o Haiku 5.5 mudou para um novo Tokenizer. De acordo com a documentação oficial para desenvolvedores, o mesmo trecho de texto pode gerar cerca de 30% mais tokens no novo modelo do que no Haiku 4.5, com o aumento específico dependendo do conteúdo. Portanto, uma queda de 90% no preço unitário da API não significa que a conta de cada tarefa possa ser reduzida em 90%.
Outro rival que vale a pena observar é o GPT-6 Luna. O preço base da OpenAI para o Luna também é de US$ 0,1 por milhão de tokens de entrada e US$ 0,5 para saída, e o preço de leitura de cache também é consistente com o nível de preço baixo do Haiku 5.5.
No entanto, há uma diferença clara entre os limites de cobrança de contexto longo das duas empresas.
O Haiku 5.5 entra em um nível de preço mais alto após prompts excederem 100.000 tokens; o GPT-6 Luna só aciona sobretaxas de contexto longo após a entrada exceder 272.000 tokens. Isso significa que, para solicitações entre 100.000 e 272.000 tokens, o Luna tem vantagem no preço unitário por token.
Quanto a qual modelo é, em última análise, mais econômico para concluir uma tarefa, ainda é preciso julgar com base no uso real de tokens, no orçamento de inferência e na taxa de sucesso da tarefa.
Olhando para todo o mercado, a Anthropic também está pressionando outros modelos de baixo preço.
Os preços de API do mesmo período listados pela VentureBeat mostram que o Google Gemini 3.5 Flash-Lite custa US$ 0,3 por milhão de tokens de entrada e US$ 2,5 para saída; o Gemini 3.8 Flash custa US$ 0,75 e US$ 3,75, respectivamente.
É claro que modelos diferentes têm posicionamentos de capacidade, estratégias de cache e desempenho em tarefas diferentes. Esses números refletem primeiro a competição nos preços de API.
A guerra de preços entre modelos pequenos está se intensificando ainda mais.
8 milhões de chamadas por semana, empresas começam a fazer modelos pequenos trabalharem para modelos grandes
Para que exatamente o Haiku 5.5 é adequado?
Os cenários fornecidos pela Anthropic incluem resumo de documentos, classificação de informações, consultas a bancos de dados, compressão de contexto e atuação como Subagente em fluxos de trabalho complexos de Agentes.
Por trás disso há um problema muito realista: os Agentes de hoje estão se tornando cada vez mais complexos, e uma tarefa frequentemente exige múltiplas chamadas de modelo. Se cada etapa for entregue a um modelo grande, os custos se acumularão rapidamente.
A empresa de IA financeira Rogo fornece um exemplo. Em seu fluxo de trabalho, um modelo grande mais capaz é responsável por criar apresentações financeiras. Ao processar um determinado slide, o Subagente Haiku 5.5 acessa o relatório anual 10-K da empresa, encontra os dados de receita operacional necessários e então entrega o resultado ao modelo principal.
Para esse tipo de tarefa, o modelo precisa concluir a busca e a extração de informações de forma rápida e precisa. A Rogo acredita que o Haiku 5.5 alcança um equilíbrio adequado para chamadas repetidas em larga escala entre precisão, velocidade e preço.
A plataforma de gerenciamento de conteúdo empresarial Box também forneceu resultados de testes iniciais. Em comparação com o Haiku 4.5, a pontuação da avaliação interna do Haiku 5.5 aumentou 11 pontos, e a latência caiu cerca de 50%.
A Box afirmou que isso torna o novo modelo adequado para trabalhos de análise que precisam ser executados em escala, como relatórios de custos, resumos financeiros e revisões periódicas. No entanto, a Box não divulgou os critérios completos de avaliação.
Os testes da Asana cobriram tarefas de Agente, como classificação de bugs, criação de projetos e busca em grandes portfólios de projetos. De acordo com os resultados divulgados, em comparação com o modelo atualmente em uso, o Haiku 5.5 reduziu a latência de conclusão de tarefas em mais de 30% e aumentou a velocidade de inferência do Agente em uma única rodada em até 2,5 vezes.
Outro exemplo que demonstra melhor o valor de custo vem da AlphaSense. O recurso Ask in Document dessa empresa precisa lidar com cerca de 8 milhões de chamadas por semana, principalmente respondendo a perguntas específicas sobre um ou vários documentos.
Entre 400 consultas de teste, a pontuação da avaliação interna do Haiku 5.5 alcançou 0,84, enquanto o Haiku 4.5 ficou em 0,76.
Se um modelo é chamado milhões de vezes por semana, mesmo que economize apenas uma pequena quantia de dinheiro a cada vez, a mudança de custo acumulada a longo prazo pode ser considerável.
Esses dados vêm do feedback inicial de clientes divulgado pela Anthropic. As cargas de trabalho específicas, os modelos de comparação e os padrões de avaliação não são completamente consistentes, e mais testes independentes ainda são necessários.
O Sonnet também reduz preços, e a família Claude 5.5 começa a competir em custo
Além do Haiku 5.5, a Anthropic também ajustou o preço do Sonnet 5.5 ao mesmo tempo. A partir de 7 de outubro, a taxa de leitura de cache do Sonnet 5.5 será reduzida em 50%, de US$ 0,2 por milhão de tokens para US$ 0,1.
A Anthropic estima que esse ajuste pode reduzir ainda mais o custo da maioria das cargas de trabalho de Agentes em cerca de 20%, com a redução real dependendo da medida em que os aplicativos reutilizam o contexto em cache.
Para Agentes que precisam ler repetidamente históricos longos de conversas, descrições de ferramentas e contexto de tarefas, os custos de cache afetam diretamente as despesas operacionais de longo prazo do sistema.
A Anthropic também lançou créditos mensais de API para assinantes do Claude Max e Team: US$ 100 para usuários Max 5x, US$ 200 para usuários Max 20x e até US$ 500 compartilhados por usuários Team.
Esses créditos podem ser usados para chamadas de modelo na plataforma Claude, incentivando mais assinantes a experimentar a criação de seus próprios Agentes e aplicativos.
No lado do desenvolvedor, o Haiku 5.5 já está disponível por meio de plataformas como a API da Anthropic, Amazon Bedrock, Google Cloud e Microsoft Azure, com o ID de modelo da API claude-haiku-5-5.
A Anthropic também atualizou os SDKs de Python e TypeScript, adicionando suporte em fase Beta para operação de navegador e operação de computador.
Neste ponto, a divisão de trabalho dos produtos da série Claude 5.5 já está bastante clara.
O Opus 5.5 lida com tarefas de alta dificuldade e raciocínio complexo, o Sonnet 5.5 cobre o trabalho complexo diário e a programação, e o Haiku 5.5 concentra-se em tarefas com alto volume de chamadas, sensibilidade a custos e requisitos de resposta rápida.
De 22 de setembro a 7 de outubro, a Anthropic levou 15 dias para concluir esta rodada de atualizações de produtos, com todos os três modelos enfatizando desempenho e eficiência de custo.
O lançamento do Haiku 5.5 também torna uma tendência mais óbvia. À medida que os Agentes gradualmente passam de demonstrações para aplicações práticas, os desenvolvedores precisam considerar os custos de chamada de todo o sistema. Quais etapas de uma tarefa exigem um modelo mais forte, quais podem ser entregues a um modelo pequeno e como o trabalho é distribuído entre diferentes modelos afetarão a viabilidade comercial final.
Para a Anthropic, talvez a parte mais atraente do Haiku 5.5 esteja aqui: ele faz com que mais tarefas que originalmente eram difíceis de escalar devido a custos de chamada excessivamente altos comecem a se tornar economicamente viáveis.
A competição entre modelos pequenos já começou a penetrar em cada elo de execução do sistema de Agentes.
Materiais de referência
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Este artigo vem da conta pública do WeChat "Machine Heart" (ID: almosthuman2014), editor: Spoon-billed Sandpiper