Товарищи, Anthropic снова снижает цены. На этот раз это самая дешёвая модель в семействе Claude — Haiku.
7 октября Anthropic официально выпустила Claude Haiku 5.5, заявив, что это самая быстрая, самая способная и самая дешёвая малая модель на сегодняшний день.
Самое возмутительное — это цена, всего $0,1 за миллион входных токенов, прямое снижение цены на 90% по сравнению с предыдущим поколением.
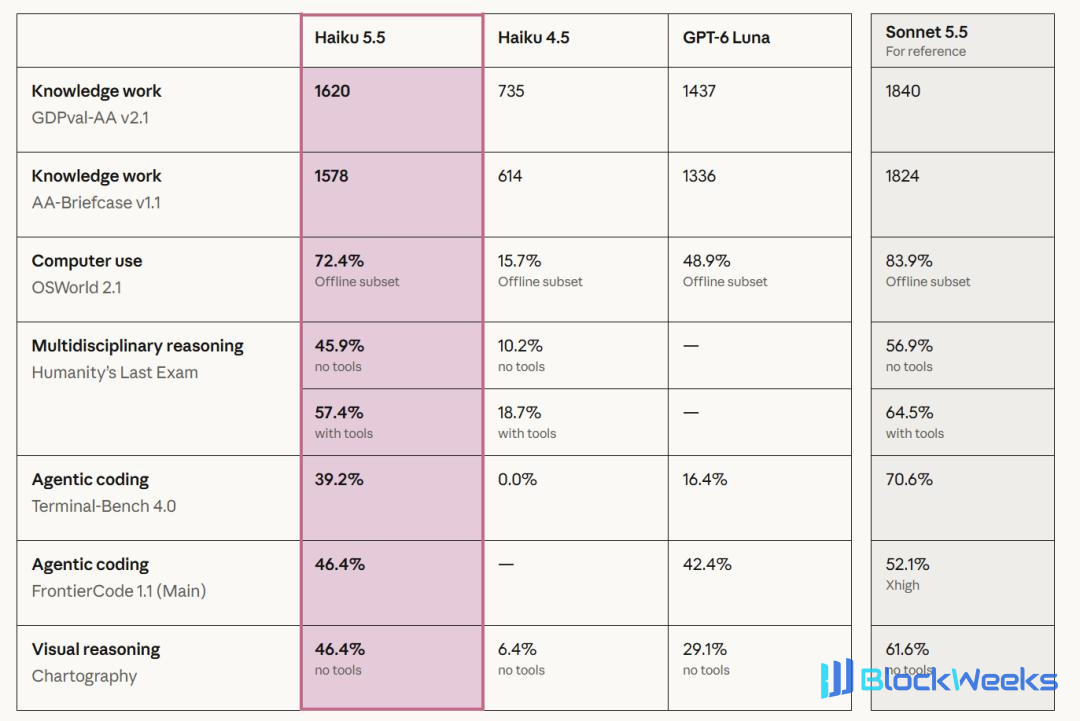
Производительность тоже не отстаёт. Согласно результатам тестов, опубликованным Anthropic, Haiku 5.5 превосходит OpenAI GPT-6 Luna по нескольким бенчмаркам, включая работу с компьютером, интеллектуальную работу и программирование агентов, причём некоторые оценки показывают значительный разрыв.
Более того, Haiku 5.5 также вводит регулируемую интенсивность рассуждений, поддерживая контекстное окно в 1 миллион токенов и вывод до 128 000 токенов.
На данный момент Anthropic завершила обновление всего семейства Claude 5.5 всего за 15 дней: Opus 5.5 появился 22 сентября, Sonnet 5.5 был выпущен 28 сентября, а теперь официально присоединился Haiku 5.5.
На этот раз Anthropic сосредоточилась на тех задачах ИИ с огромными объёмами вызовов и чрезвычайной чувствительностью к цене.
Множество оценок превосходят GPT-6 Luna, успешность работы с компьютером 72,4%
Согласно оценкам Benchmark, опубликованным Anthropic, Haiku 5.5 достиг значительных улучшений по сравнению с предыдущим поколением, а в некоторых тестах даже показал лучшие результаты, чем GPT-6 Luna.
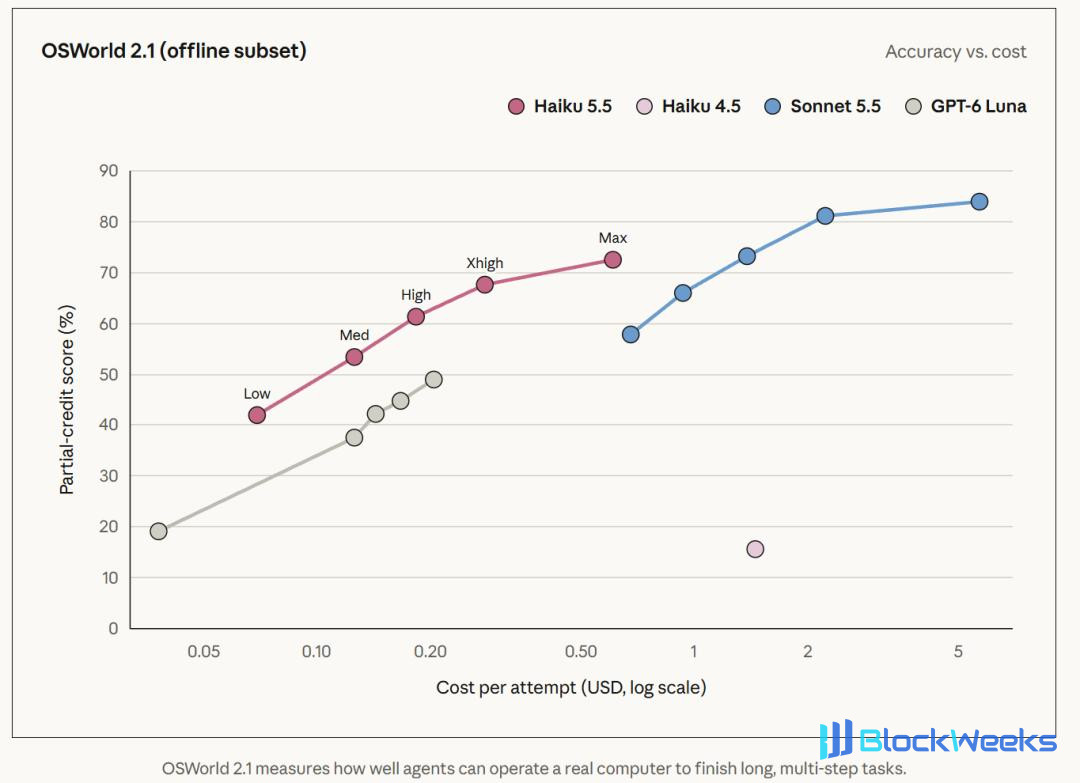
Самый заметный результат получен в OSWorld. Это тест, измеряющий способность ИИ-агента управлять реальным компьютером, требующий от модели выполнения кросс-приложенческих, многошаговых операционных задач.
На офлайн-подмножестве задач OSWorld 2.1 Haiku 5.5 достиг 72,4% успешности, в то время как предыдущее поколение Haiku 4.5 имело только 15,7%, а GPT-6 Luna — 48,9%.
В плане интеллектуальной работы Haiku 5.5 набрал 1620 баллов в GDPval-AA v2.1, превзойдя 1437 баллов GPT-6 Luna. В тесте программирования агентов Terminal-Bench 4.0 они набрали 39,2% и 16,4% соответственно.
Однако в этих данных есть важная деталь. Наивысшие оценки Benchmark Haiku 5.5 часто требуют большего объёма вычислений для рассуждений.
Haiku 5.5 впервые в серии Haiku вводит регулируемую интенсивность рассуждений, позволяя разработчикам контролировать, сколько вычислительных ресурсов модель вкладывает через параметр effort.
Медиа-издание VentureBeat заметило, что в тесте Terminal-Bench, опубликованном Anthropic, оценка 39,2% соответствует максимальной интенсивности рассуждений. После переключения на среднюю интенсивность рассуждений оценка падает примерно до 20%, а средняя интенсивность — это именно настройка по умолчанию для Haiku 5.5.
Стороннее оценочное агентство Artificial Analysis также наблюдало аналогичное явление. В своей оценке Intelligence Index Haiku 5.5 набрал 43 балла при максимальной интенсивности рассуждений и 34 балла при средней интенсивности рассуждений. При той же оценке средняя стоимость за задачу составила около $0,21 и $0,05 соответственно.
Иными словами, модель может обменивать увеличенный бюджет на рассуждение на лучшую производительность в задачах, но фактические затраты также могут значительно возрасти.
В собственном тесте Terminal-Bench 4.0 компания Artificial Analysis измерила показатели 33% при максимальной интенсивности рассуждений и 15% при средней интенсивности. Из-за различных настроек оценки эти цифры отличаются от официальных результатов Anthropic.
Именно поэтому при рассмотрении производительности небольших моделей необходимо одновременно учитывать интенсивность рассуждений, процент выполнения задач и фактические затраты.
На более сложных задачах программирования агентов Sonnet 5.5 по-прежнему имеет явное преимущество: его показатель в Terminal-Bench 4.0 достигает 70,6%.
Anthropic также четко заявила, что Sonnet и Opus по-прежнему больше подходят для сложных задач программирования агентов, тогда как преимущества Haiku сосредоточены на высокочастотной работе с четко определенной областью применения.
Цена снижена сразу в десять раз, прямая конкуренция с GPT-6 Luna
Если улучшение производительности делает Haiku 5.5 конкурентоспособной, то цена может стать самым важным ярким моментом этого выпуска. Anthropic разработала два уровня цен на API для новой модели.

Для запросов с длиной подсказки не более 100 000 токенов удельные цены ввода и вывода Haiku 5.5 на 90% ниже, чем у предыдущего поколения. Выше этого порога цена все еще на 50% ниже, чем у Haiku 4.5.
Anthropic заявила, что около 90% запросов к предыдущему поколению Haiku были в пределах 100 000 токенов. Объединив различные длины запросов и изменения в потреблении токенов, компания оценивает, что Haiku 5.5 выполняет среднюю стоимость аналогичных задач снижается примерно на 75%.
Здесь также есть легко упускаемая деталь — Haiku 5.5 перешла на новый токенизатор. Согласно официальной документации для разработчиков, один и тот же фрагмент текста может генерировать примерно на 30% больше токенов в новой модели, чем в Haiku 4.5, причем конкретное увеличение зависит от содержания. Поэтому падение удельной цены API на 90% не означает, что счет за каждую задачу можно уменьшить на 90%.
Еще один конкурент, заслуживающий внимания, — GPT-6 Luna. Базовая цена OpenAI для Luna также составляет $0,1 за миллион входных токенов и $0,5 за выходные, а цена чтения кэша также соответствует низкому ценовому уровню Haiku 5.5.
Однако между порогами тарификации длинного контекста у двух компаний есть явное различие.
Haiku 5.5 переходит на более высокий ценовой уровень после превышения подсказкой 100 000 токенов; GPT-6 Luna взимает надбавку за длинный контекст только после превышения ввода 272 000 токенов. Это означает, что для запросов от 100 000 до 272 000 токенов Luna имеет преимущество в удельной цене за токен.
Что касается того, какая модель в конечном итоге более экономична для выполнения задачи, это все еще нужно оценивать на основе фактического использования токенов, бюджета на вывод и процента успешного выполнения задач.
Глядя на весь рынок, Anthropic также оказывает давление на другие недорогие модели.
Цены API за тот же период, перечисленные VentureBeat, показывают, что Google Gemini 3.5 Flash-Lite стоит $0,3 за миллион входных токенов и $2,5 за выходные; Gemini 3.8 Flash стоит $0,75 и $3,75 соответственно.
Конечно, разные модели имеют разные позиционирование возможностей, стратегии кэширования и производительность в задачах. Эти цифры в первую очередь отражают конкуренцию в ценах на API.
Ценовая война среди небольших моделей продолжает обостряться.
8 миллионов вызовов в неделю, предприятия начинают заставлять небольшие модели работать на большие модели
Для чего именно подходит Haiku 5.5?
Сценарии, приведенные Anthropic, включают суммирование документов, классификацию информации, запросы к базам данных, сжатие контекста и работу в качестве субагента в сложных рабочих процессах агентов.
За этим стоит очень реалистичная проблема: сегодняшние агенты становятся все более сложными, и задача часто требует множества вызовов моделей. Если каждый шаг передавать большой модели, затраты будут быстро накапливаться.
Финансовая AI-компания Rogo приводит пример. В её рабочем процессе более мощная большая модель отвечает за создание финансовых презентационных колод. При обработке определённого слайда субагент Haiku 5.5 заходит в корпоративный годовой отчёт 10-K, находит необходимые данные о выручке бизнеса, а затем передаёт результат основной модели.
Для такого рода задач модель должна быстро и точно выполнять поиск и извлечение информации. Rogo считает, что Haiku 5.5 достигает баланса, подходящего для крупномасштабных повторяющихся вызовов, между точностью, скоростью и ценой.
Платформа управления корпоративным контентом Box также предоставила результаты раннего тестирования. По сравнению с Haiku 4.5, внутренняя оценка Haiku 5.5 выросла на 11 баллов, а задержка снизилась примерно на 50%.
Box заявила, что это делает новую модель подходящей для аналитической работы, которую нужно запускать в масштабе, например для отчётов о затратах, финансовых сводок и периодических обзоров. Однако Box не раскрыла полные критерии оценки.
Тесты Asana охватывали задачи агента, такие как классификация ошибок, создание проектов и поиск по крупному портфелю проектов. Согласно раскрытым ею результатам, по сравнению с currently используемой моделью Haiku 5.5 сократила задержку выполнения задач более чем на 30% и увеличила скорость однораундового вывода агента до 2,5 раз.
Ещё один пример, лучше демонстрирующий ценность затрат, исходит от AlphaSense. Функция этой компании Ask in Document должна обрабатывать около 8 миллионов вызовов в неделю, в основном отвечая на конкретные вопросы об одном или нескольких документах.
Среди 400 тестовых запросов внутренняя оценка Haiku 5.5 достигла 0,84, тогда как у Haiku 4.5 она составила 0,76.
Если модель вызывается миллионы раз в неделю, даже если она экономит лишь небольшую сумму каждый раз, долгосрочное накопленное изменение затрат может быть значительным.
Эти данные взяты из ранней обратной связи клиентов, раскрытой Anthropic. Конкретные рабочие нагрузки, модели для сравнения и стандарты оценки не полностью согласованы, и всё ещё требуется больше независимого тестирования.
Sonnet также снижает цены, и семейство Claude 5.5 начинает конкурировать по стоимости
Помимо Haiku 5.5, Anthropic также одновременно скорректировала ценообразование Sonnet 5.5. Начиная с 7 октября плата за чтение кэша Sonnet 5.5 будет снижена на 50%, с $0,2 за миллион токенов до $0,1.
Anthropic оценивает, что эта корректировка может дополнительно снизить стоимость большинства рабочих нагрузок агента примерно на 20%, причём фактическое снижение зависит от того, в какой степени приложения повторно используют кэшированный контекст.
Для агентов, которым нужно многократно читать длинные истории диалогов, описания инструментов и контекст задач, затраты на кэш напрямую влияют на долгосрочные операционные расходы системы.
Anthropic также запустила ежемесячные API-кредиты для подписчиков Claude Max и Team: $100 для пользователей Max 5x, $200 для пользователей Max 20x и до $500, совместно используемых пользователями Team.
Эти кредиты можно использовать для вызовов моделей на платформе Claude, побуждая больше подписчиков попробовать создавать собственных агентов и приложения.
На стороне разработчиков Haiku 5.5 уже доступна через такие платформы, как Anthropic API, Amazon Bedrock, Google Cloud и Microsoft Azure, с идентификатором API-модели claude-haiku-5-5.
Anthropic также обновила SDK для Python и TypeScript, добавив поддержку работы с браузером и работы с компьютером на стадии Beta.
На данный момент разделение труда между продуктами серии Claude 5.5 уже довольно чёткое.
Opus 5.5 решает задачи высокой сложности и сложных рассуждений, Sonnet 5.5 охватывает повседневную сложную работу и программирование, а Haiku 5.5 сосредоточена на задачах с большим объёмом вызовов, чувствительностью к стоимости и требованиями к быстрому отклику.
С 22 сентября по 7 октября Anthropic потребовалось 15 дней, чтобы завершить этот раунд обновлений продуктов, при этом все три модели делают акцент на производительности и экономической эффективности.
Выпуск Haiku 5.5 также делает одну тенденцию более очевидной. По мере того как агенты постепенно переходят от демонстраций к практическим приложениям, разработчикам приходится учитывать стоимость вызовов всей системы. Какие шаги в задаче требуют более мощной модели, какие можно передать небольшой модели и как распределяется работа между разными моделями, — всё это влияет на итоговую коммерческую жизнеспособность.
Для Anthropic, возможно, самое привлекательное в Haiku 5.5 именно здесь: она позволяет многим задачам, которые изначально было трудно масштабировать из-за чрезмерно высокой стоимости вызовов, начать становиться экономически жизнеспособными.
Конкуренция среди небольших моделей уже начала проникать в каждое звено выполнения системы агента.
Справочные материалы
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Эта статья взята из публичного аккаунта WeChat «Machine Heart» (ID: almosthuman2014), редактор: Spoon-billed Sandpiper