Сьогоднішні агенти вже вміло викликають інструменти, змінюють файли та запускають тести, але чи здатні вони, зіткнувшись із великою програмною системою, що розвивалася протягом тривалого часу, почати з нової вимоги та поставити завершену функцію?
Коли продакт-менеджер пропонує нову вимогу, розробники часто отримують не список файлів чи сигнатури функцій. Спочатку їм потрібно зрозуміти обмеження, простежити залежності модулів, а потім визначити, де змінювати, як змінювати і як довести, що зміни правильні. Ці аналізи впливають на подальшу поставку.
Університет Фудань, Міський університет Гонконгу, Китайський університет Гонконгу та інші установи пропонують LoLBench, який поміщає агентів у програмні системи із середнім обсягом близько 2,4 мільйона рядків вихідного коду, оцінює повний процес від пропозиції функції до поставки модуля та перевіряє здатність сприйняття прив'язувати вимоги до системи, а також здатність реалізації виконувати міжмодульні зміни.
Посилання на статтю: https://arxiv.org/abs/2609.37143
Набір даних: https://huggingface.co/datasets/lolbench26/LoLBench
Експерименти виявляють ключову точку розриву: агент може зробити правильну локальну зміну, але пропустити зміни в інших модулях, які необхідно синхронізувати. Навіть із додатковими вказівками щодо реалізації більшість завдань залишаються невирішеними, і від розуміння вимог до завершення поставки все ще залишається довга дистанція.
Переосмислення довготривалих кодових завдань
Яке довготривале кодове завдання має реальну інженерну цінність?
«Довготривалість» не можна оцінювати лише за витраченим часом, кількістю раундів чи споживанням токенів. Наприклад, прохання до агента виводити одне число щохвилини, рахуючи від 1 до 1000, займає багато часу, але потребує лише простого циклу. Завдання локального виправлення помилок у стилі SWE-bench також не можуть охопити виклик від аналізу вимог до поставки модуля.
Довготривалі кодові завдання, на яких зосереджується LoLBench, — це розробка модулів для складних систем. Отримавши нову вимогу, розробники багаторазово аналізують: які поведінки потрібно реалізувати? Чи може існуюча архітектура їх підтримати? Які залежності будуть порушені? Як перевірити? LoLBench також включає цей аналіз, прихований у думках розробників, до оцінювання, дозволяючи агенту самостійно виводити план реалізації з наміру користувача.
Такі завдання одночасно мають складність сприйняття та складність реалізації: перша — це складність розуміння пропозиції, виявлення неявних обмежень і міжмодульних залежностей та виведення обсягу змін і специфікації реалізації; друга — це складність перетворення специфікації на правильні міжфайлові зміни та, через тестування й виправлення, запобігання порушенню існуючої функціональності.
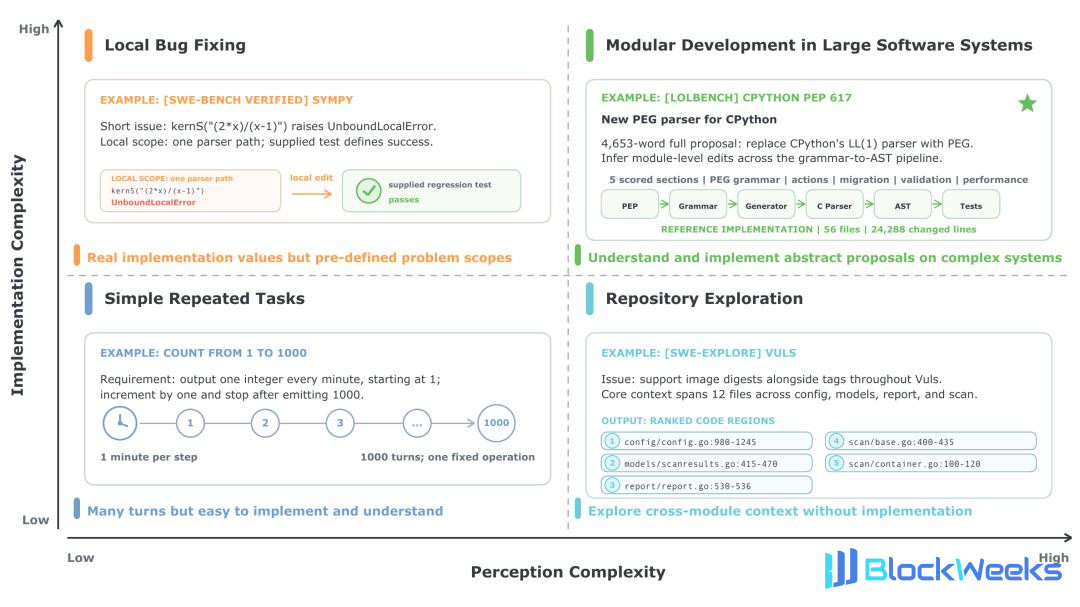
Рисунок 1. Порівняння складності сприйняття та складності реалізації.
Як LoLBench оцінює обидва типи складності одночасно
Виведення специфікації реалізації з пропозицій функцій
LoLBench відбирає 100 завдань із пропозицій щодо вдосконалення від спільноти та відповідних злитих PR, охоплюючи 29 систем, 8 мов і 5 доменів.
Агент отримує лише пропозицію та репозиторій коду до реалізації; пропозиція в середньому містить близько 5000 англійських слів. Оцінювання проводиться в офлайн-середовищі Docker, щоб запобігти отриманню агентом висхідних реалізацій.
Наприклад, PEP 617 [1] пропонує замінити LL(1)-парсер CPython на PEG, і реалізація вимагає з'єднання визначень граматики, генерації парсера, абстрактних синтаксичних дерев і звітування про помилки. Агент повинен визначити весь ланцюжок реалізації.
З точки зору складності сприйняття, середня частота згадування в пропозиції назв цільових класів у еталонній реалізації LoLBench становить лише 7,3%, менше половини від SWE-bench Verified (15,9%) і менше однієї п'ятої від FeatureBench (38,7%). Агент повинен самостійно вивести зв'язок між вимогами та кодом.
Перетворення специфікацій на інженерну поставку
З точки зору складності реалізації, репозиторії LoLBench в середньому містять близько 2,4 мільйона рядків вихідного коду, що приблизно в 9,4 раза більше, ніж SWE-bench Verified, і в 4,9 раза більше, ніж FeatureBench; реалізації змінюють в середньому 5 499 рядків, порівняно з 38 рядками та 2 050 рядками для останніх двох. Кожне завдання змінює в середньому 64,9 файла, 40,1 класу та 195,9 функції; кількість файлів у 25 разів і в 4,2 раза перевищує показники двох інших відповідно. Міжмодульна координація та верифікація є складнішими.

Таблиця 1. Порівняння LoLBench з існуючими наборами оцінювання кодових завдань.
LoLBench перевіряє правильність поставки за допомогою двох типів тестів: тести нових функцій (F2P) вимагають невдачі до реалізації та проходження після реалізації; F2P перевіряє поведінку через публічні інтерфейси та допускає різні внутрішні реалізації. Регресійні тести (P2P) вимагають проходження як до, так і після.
На додаток до оригінальних тестів проєкту, дослідницька група створює помилкові реалізації, такі як відсутні функції та підмінені вимоги, як мутанти, доповнює тестові випадки для виявлення пропущених помилок і покращує покриття тестами еталонних патчів.
Після покращення рівень виявлення 1 688 мутантів зростає з приблизно 61% до 96%, а середнє покриття рядків на завдання для F2P зростає з приблизно 60% до 79%.
Продуктивність і вузькі місця 28 комбінацій Агентів
Зміна моделей або скафолдів: найвищий показник розв'язання Агента становить лише 14%
Дослідницька група оцінює 28 доступних комбінацій 6 передових моделей і 5 скафолдів, з обмеженням часу 6 годин на завдання. Opus 5 у парі з Claude Code або mini-SWE-agent обидва ділять найвищий показник розв'язання на рівні 14%, а медіана по всіх комбінаціях становить лише 2%.

Таблиця 2. Основні експериментальні результати в статті
Використовуючи також Opus 5, mini-SWE-agent і Claude Code досягли однакового показника розв'язання, але перший витратив у 3,2 раза більше часу, ніж другий, і згенерував у 5 разів більше токенів; більше споживання не принесло вищого показника розв'язання.
Велика кількість взаємодій і токенів витрачається на локалізацію коду
З точки зору споживання токенів, у середньому по агентах, етап локалізації становив 52,4% некешованих вхідних токенів і 45,4% згенерованих токенів. З точки зору кількості раундів взаємодії агента, етап локалізації також мав значно більше раундів взаємодії, ніж інші етапи.

Рисунок 2. Середня кількість раундів взаємодії на кожному етапі.
Для наявних файлів і функцій, змінених відносно еталонної реалізації, за всіма 28 групами агентів точність модифікації файлів становила від 38,0% до 80,4%, а повнота — від 30,3% до 65,0%; точність модифікації функцій становила від 54,2% до 65,6%, а повнота — від 20,8% до 53,4%. Точність локалізації коду низька, а покриття залишається неповним.
Навіть після доповнення настанов щодо модифікації агенти все ще не можуть повністю впоратися із завданням
Дослідницька група зберегла початкову пропозицію функціоналу та додатково надала дерево файлів модифікації, експортоване з еталонної реалізації, і специфікації реалізації API, щоб допомогти агентам визначити обсяг модифікацій. Частка вирішених завдань для Opus 5+Claude Code зросла з 14% до 34%, для GPT-5.6 Sol+Codex — з 3% до 25%,
DeepSeek
V4 Flash+OpenCode — з 1% до 17%.

Таблиця 3. Результати експериментів після доповнення дерева файлів модифікації та специфікацій реалізації API
Доповнення настанов щодо модифікації може полегшити навантаження на сприйняття, але найкраща комбінація все ще мала 66% невирішених завдань. Агентам усе ще потрібно координувати модулі, реалізовувати інтерфейси та проходити перевірку, що свідчить про те, що складність реалізації великих систем також дуже висока.
Від генерації коду до еволюції великих програмних систем
Ці результати дають напрями для дослідження та розробки агентів, які можна перевірити: чи може пошук у репозиторії охоплювати ключові залежності, чи є специфікації реалізації перед написанням коду повними, і чи може перевірка своєчасно виявляти міжмодульні пропуски.
Цінність програмної інженерії полягає в тому, чи можна надійно задовольнити вимоги користувача. Агентам потрібно розуміти, чому відбуваються зміни, як вони впливають на систему, і повністю реалізовувати зміни. LoLBench сподівається сприяти оцінюванню можливостей агентів від генерації коду до підтримки безперервної еволюції програмного забезпечення, роблячи результати постачання мірилом для перевірки можливостей агентів.
Джерело: PEP 617: https://peps.python.org/pep-0617/
Ця стаття походить із публічного акаунта WeChat "Xinzhiyuan", автор: Xinzhiyuan; редактор: LRST