GPT-6 Astra 發布才兩個月,GPT-6.2 Astra 眼看就要來了。
然而具身智能行業還沒從上一輪打擊中緩過神來。
一切都是那麼猝不及防。
還記得 GPT-6 Astra 剛出來時,一批具身從業者被打懵了。特別是在一線搞預訓練的工程師,更是人人自危。
近期,業內又傳出消息,一些具身智能公司開始裁撤算法崗。
過去需要大量數據、算力和算法工程師一
點點
啃下來的能力,GPT-6 Astra 在部分測試中,卻不需要針對具體任務進行額外後訓練,就能夠展現出來。
這還讓人怎麼捲???
一位在機器人公司搞模型開發的工程師告訴量子位:
比起具身智能遲遲沒有出現新的範式級突破,以 Astra 為代表的通用大模型,正在以 coding 的方式垂直打擊具身行業,這才是真衝擊。
衝擊帶來的壓力,不完全來自矽谷。
相比 OpenAI 等海外大模型公司的技術進展,國內具身公司對本土大模型玩家的下一步動作更敏感。
Kimi
、
DeepSeek
、智譜……這些名字正在成為具身行業不得不關注的變量。
在最近火熱的 RoboDojo 評測中,越來越多團隊也開始嘗試將通用大模型(如 GPT-6 Astra)引入自己的機器人系統,泛化很強,能力驚人。
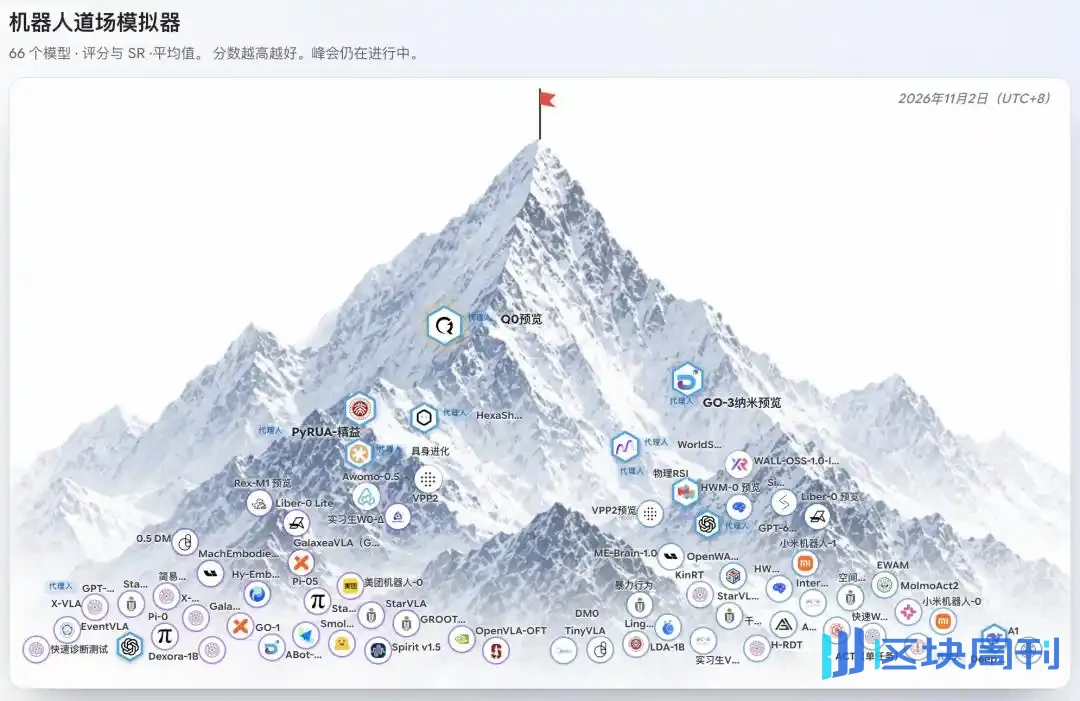
據 RoboTwin/RoboDojo 評測基準第一作者陳天行透露,一些原本堅持訓練原生具身基礎模型的團隊,如今也開始提交結合 Robot-Use-Agent(RUA)等技術的方案,借助通用大模型完成機器人任務。
效果相當直接。原先只有 20 分、30 分的模型,在結合 Astra 相關方案後,評測成績能夠提升至 50 分、60 分。
榜單分數漲上去了,具身公司滿腦子卻只有一個聲音:
還有必要自研模型嗎……(cry)

作為香港大學 MMLab 具身智能方向的博士生,陳天行參與了 RoboDojo 針對 GPT-6 Astra 的評測及評估報告(以下簡稱「報告」)撰寫。

△RoboDojo 團隊對 GPT-6 Astra 的早期評估報告
回憶起 9 月中旬的一天,陳天行告訴量子位,當夥伴們陸續把測試結果拿來,他愣了好幾秒:
你能看到它對 3D 重建、對數學等各個領域的衝擊都是空前的。
嚇人,真挺嚇人的。
都被 GPT-6 打懵了
「具身自研模型還在 80 分上不斷加 0.1、加 0.2,GPT-6 Astra 已經一次性從 80 分跳到了 90 分。」
這是陳天行復盤這次評測時,給出的一個形象比喻。
更扎心的是,在部分測試中,Astra甚至沒有針對具體任務進行額外後訓練,也沒有使用任務示範,僅憑語言指令,就能完成不少機器人操作任務。
最讓他意外的,還是Astra一下子展現出了三項具身模型過去需要重點攻克的能力。
第一項是ICL(In-Context Learning,上下文學習)。
簡單來說,就是讓機器人透過少量上下文資訊,快速學會一個新任務。
比如,人類拍一段自己操作的影片,再配上文字說明,機器人就能理解人是怎麼做的,並嘗試讓機械臂複現。
今年7月,ICL還是具身圈一個相當熱門的研究方向。常見的範式是展示人類操作,讓機器人模仿以習得新技能——即所謂的單次情境學習。
但社區發現,給Astra提供圖像或文字示範,成功率可以高於不提供示範。
更讓人意外的是它的線上適應能力。研究人員故意改變攝影機畫面與動作座標系,Astra能夠根據實際執行結果,在幾輪嘗試後調整策略,順利完成任務。
也就是說,它不光能理解上下文,還能邊做邊修正。
在陳天行看來,因為通用模型本身就有很強的上下文理解能力。平時聊天時,它能記住之前的對話歷史,給它一段影片,它也能理解影片內容和文字之間的關係。
把這些能力遷移到機器人操作上,原本需要專門研究的ICL問題,突然就有了現成的解法。
第二項是OOD(Out-of-Distribution,分布外泛化)和Correction(糾錯能力)。
機器人在真實環境裡,很容易碰到訓練資料之外的情況。
比如,機械臂正準備抓一個杯子,結果杯子突然被碰了一下,位置變了。
一個過度依賴訓練資料的模型,可能還會沿著原來的軌跡執行,最後抓了個空。
而Astra能夠根據變化後的視覺資訊重新調整動作,嘗試把物體抓起來。
聽起來只是一個很小的動作,背後卻是機器人能不能適應真實世界的問題。
畢竟,現實世界可沒有人負責把每一個杯子都擺回訓練時的位置。
第三項是Open-Vocabulary Manipulation(開放詞彙操作)。
這項能力涉及語言與動作之間的對齊。
比如,使用者換不同的說法提出操作要求,機器人依然能夠聽懂並執行。
過去,語言理解和動作執行之間往往存在斷層,具身模型需要針對具體任務進行後訓練,才能更好地完成對齊。
但Astra在這方面展現出了更強的能力。在部分測試中,即使沒有針對具體任務額外後訓練和示範,它也能僅憑語言指令完成不少機器人操作。
在陳天行看來,以上三項曾是具身領域極具分量的技術命題,過去都屬於可以單獨拿出來講創業故事的。
如今,Astra一次性把這三道題都做了,對原有具身模型研發路線是一場近乎爆裂的衝擊。

△在RoboDojo-Sim基準測試中的零樣本測試結果,不代表Astra已經能夠在真實機器人上穩定完成這些任務。
報告中,RoboDojo團隊提示,Astra的真機測試曾因安全問題中止。
模擬榜單上的高分,還不能直接等同於真實世界中的生產力。
但它已經足以讓具身公司重新審視過去的研發投入。
為什麼一個原本不是為機器人操作而生的通用大模型,能快速逼近具身公司多年累積的能力?
說起來有點無心插柳。
雖然通用大模型不是從零開始學機器人,但它是帶著在大規模預訓練中,攢下的語言、視覺、推理和Coding等一系列能力進入的機器人領域。
這些能力原本各有各的用處,沒想到放到機器人身上,竟也能直接派上用場。
反觀具身公司,很多團隊從零開始訓練機器人大腦,手裡的資料主要來自機器人操作本身。

模型要理解環境、聽懂指令、學會動作,很多能力都得從有限的資料裡一
點點
磨出來。
一個是帶著一身通用本事來做機器人,一個還在為每一項能力單獨投入資料、算力和人力。
這場較量,本身起跑線就不一樣。
自研模型還有必要嗎?
GPT-6 Astra確實很強,但它還沒強到讓具身公司可以直接繳械投降。
至少在真實物理世界裡,還有不少硬骨頭等著啃。
破殼機器人創始人許華哲把具身智能的能力拆成了語義、空間和物理泛化三個層次。
他認為,Astra在前兩項上表現突出,但到了複雜物理接觸、受力變化、物體形變和高精度操作,仍然面臨挑戰。
比如,讓機器人知道一個杯子在哪裡、應該伸手去拿,和讓它穩穩抓住一個杯子,完全是兩回事。
杯子是軟是硬?抓取時該用多大的力?物體被擠壓、碰撞後會發生什麼變化?
這些問題,光靠看懂畫面、理解指令還不夠。

△報告截圖
RoboDojo團隊在評測中也發現,Astra並非在所有任務上都佔優。
幾何對齊、語言指令理解是它的強項,但到了連續接觸和多步驟物理操作,現有VLA仍然有不少機會。
自變量創始人王潛的觀點是,通用大模型要進入具身,依然必須面對機器人數據、現實世界評測、硬件、仿真和部署等基礎設施問題。
這些難度不會因為擁有一個更強的語言模型而自動消失。
問題是,Astra今天做不好的事情,明天會不會突然就做到了?
目前,業內吐槽Astra比較多的,還有推理速度太慢。

陳天行也注意到,GPT-6 Astra雲端API推理延遲較高,這對機器人實時閉環控制是現實阻礙。
你想呀,如果機器人每做一個動作,都要等大模型想半天,恐怕很難滿足真實場景的要求。
但陳天行認為,該問題並非根本性壁壘,現有LLM端側部署方案已經較多,包括模型量化、蒸餾、端側推理引擎等技術。只要大模型公司將機器人視為重要商業場景,就可以利用現有技術棧完成延遲優化。
這個問題出現的背後,是一個極易弄混的概念:「模型推理頻率」和「機器人控制頻率」,不是一回事。
一位不願具名的具身模型工程師告訴量子位:
推理慢仍然可以控制快,犧牲的只是反應速度。對於比較吃節拍類型的流水線任務來說,反而無關緊要。
比如快遞分揀,機器人需要連續、穩定地抓取和投放。高層模型負責理解任務、規劃動作,底層控制系統則以更高頻率執行控制指令。
只要任務允許提前規劃,或者對反應延遲有一定容忍度,大模型未必需要參與每一個底層控制週期。
當然,遇到高速動態變化、複雜接觸等任務,反應速度依然重要。
但至少,推理慢未必意味著機器人的控制不快。

今天通用大模型所暴露出來的各類短板,不能直接當作具身公司未來賴以生存的護城河。
對具身公司來說,這句實話,多少有些扎心。
但事實擺在那裡。今年,OpenAI已經開始大量招機器人相關崗位。
倘若未來通用模型吸收更多機器人操作數據,原本屬於專用具身模型的能力邊界,還可能繼續被壓縮。
具身公司還有機會嗎?自研模型還有必要嗎?
陳天行的判斷是,具身公司的機會,不在於比誰的模型更聰明,而在於比誰能創造更好的「經濟效益」。
這筆帳很容易算。
在一條高度標準化的工業流水線上,機器人每天重複同樣的動作,客戶最關心的是成功率、節拍、穩定性和成本。
如果花幾毛錢調用一個模型就能穩定完成任務,為什麼非要花幾塊錢調用GPT-6 Astra?
即使需要一定的智能和泛化能力,一個經過專門優化的小模型,也可能比直接調用Astra更經濟。

當然,如果換成家庭服務機器人,情況就不同了。
今天收拾桌子,明天尋找物品,後天又來了一個從未見過的新任務。
在這樣的開放環境裡,任務變化越多,對理解、規劃和泛化能力的要求就越高。更強的通用模型,可能反而更有優勢。
11月6日,陳天行在個人博客上,用兩條軸線解釋了其中的區別。
左側是「場景需求」,右側是「模型能力」。越往上越偏重通用性,越往下越偏重效率。

△陳天行博客
「開放任務可以更多借助通用模型,穩定任務可以採用規則或輕量策略,中間的場景則給場景優化模型留下了空間。」陳天行說。
依我看,兩條軸線放在一起,就一句話:
能用規則/輕量策略解決的事,沒必要上大模型;能用小模型完成的任務,也沒必要每次都請Astra出場。
反過來,如果任務變化太多,專用模型需要不斷採集數據、重新訓練,直接調用通用模型可能更合算。
決定採用哪種方案,最終還得算一筆完整的經濟帳。
一次任務的成功率是多少?要花多少時間?失敗後需要多少人工介入?數據採集、模型訓練和長期部署又要花多少錢?
這些實打實的數字,決定了一套機器人系統有沒有商業價值。
所以說,不是自研不重要,而是具身公司的「自研方向」需要重新排序了。
通用模型已經擅長的語言理解、任務規劃等能力,可以考慮直接利用;涉及物理交互、特定本體控制、真實場景適配和部署效率的問題,仍然需要大量專門研發。
至於有沒有必要繼續從頭訓練一個更大的具身基礎模型,就要看它能否在實際任務中提供足夠明顯、足夠持久的優勢。
有行業朋友和量子位吐槽,很多具身團隊現在還帶著比較強的學者心態,總想著做一個通用智能模型,恨不得把所有任務都裝進自己的模型裡。
但現在情況變了。GPT-6.2 Astra都快要來了。
若企業研究方向和目標產業脫節,模型訓得再漂亮,商業閉環也未必成立。
One more thing
過去的60天裡,很多具身從業者私下聊起來,仍舊迷茫。
只不過到了公開場合,大家該捍衛自己的利益和立場,還是要堅持到底。
可以肯定的是,GPT-6 Astra確實攪亂了具身行業原本的節奏……
馬太效應、宇樹上市後的行業重估、RSI成為新風口……疊加在一起,最終形成的是近期的行業情緒——
「投資人開始不投具身了」。
或許有誇張的成分,但具身智能機器人創業告別Demo、燒投資的階段,卻是無比真實的。
百機大戰的淘汰賽,已經開始了。
本文來自微信公眾號 「量子位」(ID:QbitAI),作者:關注前沿科技