
Alrededor del 90% del propio código de Claude Code ya se ha entregado a Claude para que lo escriba.
Ahora que la IA escribe el código, el número de cambios se ha disparado en consecuencia: de junio a septiembre, el número de PR fusionados en el repositorio de código se multiplicó por más de dos.
En todo Anthropic, los cambios fusionados en el repositorio principal de código cada día aumentaron de unos 2.500 en mayo a más de 30.000 en septiembre.
Con tanto código, ¿pueden los humanos seguir el ritmo de leerlo? Y si incluso la revisión se entrega a la IA, ¿quién juzga si ha cometido un error?
El 15 de octubre, el equipo de Claude Code reveló públicamente su proceso interno de revisión de código, y reveló que, aunque el número de PR se duplicó, la proporción de PR que requirieron reversión en realidad cayó más de un 40% en relación con eso.
Lo lograron mediante seis capas de comprobaciones, además de un mecanismo de respaldo para la detección rápida y la reversión rápida.
El juicio del equipo de Claude Code es:
A esta escala, la revisión humana línea por línea ya no es realista.
Pero no abolieron la revisión; en cambio, entregaron la mayor parte del trabajo de leer el código a las máquinas.
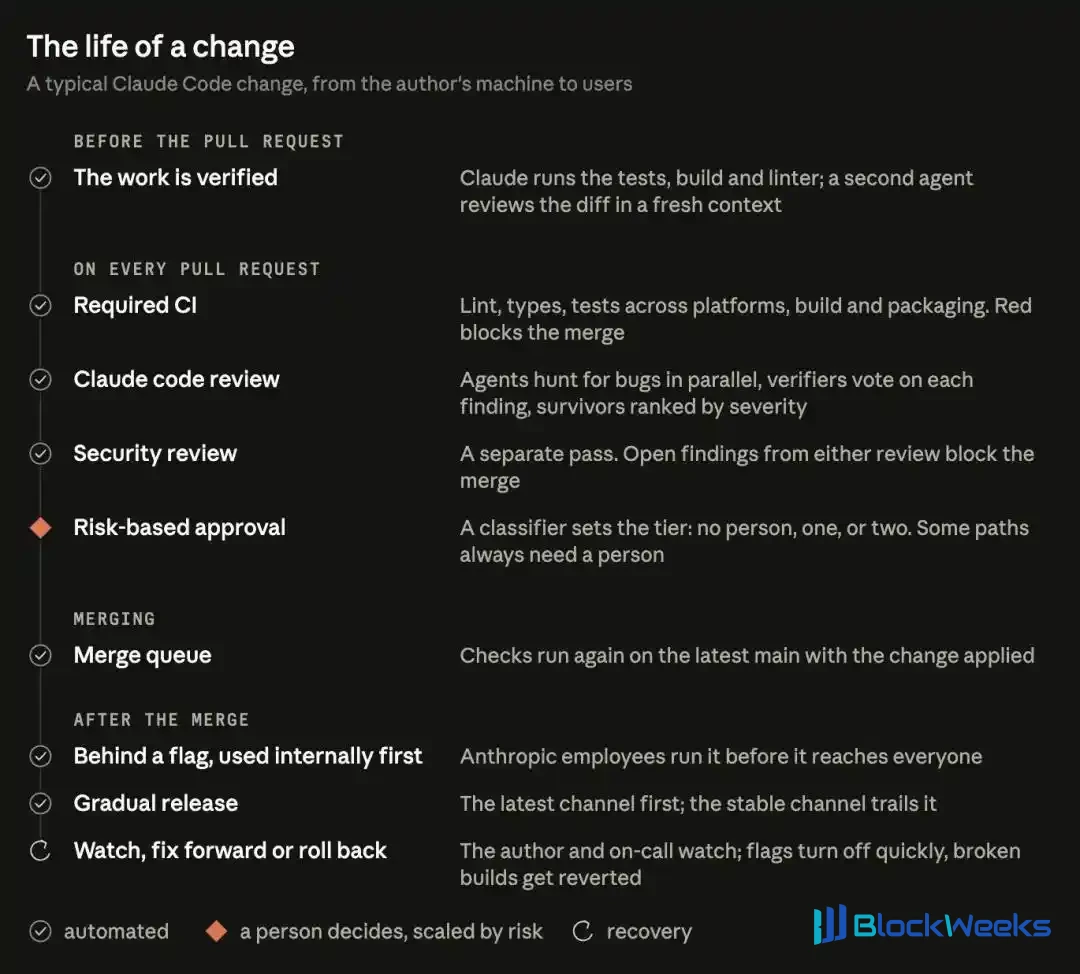
Antes de que un fragmento de código escrito por IA se publique, primero debe ejecutar pruebas, someterse a revisión de IA y de seguridad y, luego, según el riesgo, se decide si se necesita aprobación humana.
En opinión del equipo de Claude Code, "¿alguien ha leído este código?" no es una pregunta lo suficientemente precisa.
La verdadera pregunta debería ser:
¿Qué podría salir mal con este cambio y, si sale mal, qué comprobación debería detenerlo?
Antes de la revisión humana , la IA primero presenta los resultados de verificación
Un solo cambio debe pasar seis comprobaciones, con una red de seguridad al final.
La primera puerta llega antes de crear una solicitud de fusión (PR).
Claude debe ejecutar las pruebas y completar la compilación; para los cambios que afectan la interfaz, también debe tomar capturas de pantalla para compararlas con los mockups de diseño.
A continuación, se envía un subagente que utiliza un contexto nuevo para revisar el diff del código; no participó en la escritura del código y se dedica a encontrar fallos.
El requisito oficial es muy claro:
Claude debe presentar los comandos ejecutados y su salida; responder simplemente "todas las pruebas pasaron" no cuenta.
Los desarrolladores comunes pueden hacer lo mismo: cuando le den una tarea a la IA, indiquen claramente también cómo se verificará la aceptación.
La segunda puerta es la revisión de IA en el PR.
Varios agentes buscan errores en paralelo, y otro grupo vota para verificar. Solo cuando se alcanza suficiente número de votos se publicará el problema en el PR.
Los comentarios que solo se refieren al estilo del código, sugerencias de diagnóstico o limpieza del código no se publicarán en el PR y se filtran directamente.
Cuando este sistema de revisión se lanzó por primera vez en marzo, la proporción de PR internos que recibían comentarios de revisión sustantivos aumentó del 16% al 54%.
La tercera puerta es la revisión de seguridad.
Dentro del equipo, mientras los hallazgos dejados por la revisión de código o la revisión de seguridad sigan sin resolverse, el PR no puede fusionarse: o se corrigen o se cierran con una justificación por escrito.
La cuarta puerta son las comprobaciones de integración continua (CI), que incluyen estándares de código, verificación de tipos, pruebas de plataforma y empaquetado de compilación.
Un solo cambio ordinario en una herramienta de línea de comandos (CLI) puede tener que ejecutar docenas de comprobaciones antes de pasar a la revisión humana.
Los problemas recurrentes también deben convertirse en la base para la siguiente ronda de comprobaciones.
CLAUDE.md registra las convenciones del proyecto, y REVIEW.md indica al revisor en qué debe centrarse y qué puede omitirse, de modo que los problemas encontrados esta vez se conviertan en experiencia para la próxima revisión.
Cuando el mismo comentario se menciona por tercera vez, debe escribirse en las reglas.
La quinta puerta es la aprobación humana, que es la más crítica; la analizaremos en detalle en la siguiente sección.
La sexta puerta es la fusión y el lanzamiento.
Después de que un cambio pasa las puertas anteriores, todavía tiene que entrar en la cola de fusión y esperar su turno.
Cuando llega su turno, el sistema lo coloca en la última versión de la rama principal y todas las comprobaciones se ejecutan de nuevo.
Este paso protege contra "cada parte está bien por separado, pero surgen problemas al combinarlas".
Después de la fusión, las nuevas funciones tampoco se envían inmediatamente a todos los usuarios.
Primero se ocultan detrás de indicadores de función y se abren solo a los empleados internos de Anthropic. Los empleados las usan intensivamente cada día y a menudo encuentran problemas antes que los usuarios externos.
Y el indicador de función es como un interruptor maestro: sin cambiar el código ni volver a lanzar una versión, puede decidir si una función está activada o desactivada.
Finalmente, está el mecanismo de respaldo.
Si ocurre un problema, primero se acciona el interruptor maestro.
El equipo rota la guardia de disponibilidad cada semana, y cada análisis posterior a un incidente debe preguntar: ¿en qué puerta debería haberse detenido esto?
Así que la revisión no ha desaparecido: se ha convertido en capa tras capa de comprobaciones que recorren el desarrollo, la fusión y el lanzamiento.
Dónde están los límites de la aprobación cero-humana
Después de que las primeras cuatro puertas están todas en verde, la quinta puerta decide, según la clasificación por niveles de riesgo, cuántas personas necesitan aprobar este cambio.
La documentación, los textos, las funciones visibles solo internamente y los nuevos cambios ocultos detrás de indicadores son de bajo riesgo; una vez que la revisión automatizada y las comprobaciones de seguridad pasan, pueden omitir la aprobación humana.
Los cambios ordinarios de producto, así como áreas sensibles como el almacenamiento en caché, el actualizador automático y las indicaciones del sistema, necesitan una persona.
El código de mayor riesgo, además de un puñado de rutas designadas, necesita dos personas.
A primera vista, ¿los cambios de bajo riesgo ya son "sin conductor"?
No es tan simple.
El nivel de riesgo lo determina el propio cambio: el primer clasificador lee el código y establece el riesgo, y el segundo decide entonces si se necesita aprobación humana adicional.
Las rutas sensibles marcadas por los propietarios del código, así como todos los archivos de flujo de trabajo de CI, deben ser revisados por una persona.
El canal de aprobación ligera también tiene un umbral: está abierto solo a las personas de la lista de "autores de confianza" del repositorio; cualquiera fuera de la lista debe buscar a otra persona para que apruebe.
La persona que dirige a la IA para escribir código cuenta como revisor, y debe asumir la responsabilidad del cambio tal como si hubiera escrito el código a mano.
La aprobación cero-humana no significa que nadie sea responsable.
Los humanos deben decidir si se debe construir una función, si la arquitectura es razonable y si las comprobaciones existentes pueden cubrir el riesgo de este cambio.
Así que el equipo de Claude Code tiene una regla: el código que fusionas—si algo sale mal, normalmente lo arreglas tú.
Antes de hacer clic en aprobar, el revisor debe poder explicar claramente: qué verificaron estas comprobaciones y qué riesgos quedan sin cubrir.
Si no puedes explicarlo, no te apresures a hacer clic en aprobar—primero añade la revisión necesaria.
La revisión con IA también puede fallar
La revisión automatizada también puede quedarse atascada.
Un PR de un proyecto de CLI pasó por más de cincuenta rondas de revisión y correcciones durante la noche, hasta que el autor finalmente lo detuvo manualmente.
Un humano puede ignorar un problema menor en un segundo, pero la IA no lo hará—obedientemente irá a corregirlo, y tras corregirlo hay otro commit, y otra ronda de revisión.
El equipo usó git blame para rastrear y descubrió que, de los problemas que el revisor señalaba repetidamente, alrededor del 59% eran código antiguo que existía antes de la primera ronda de revisión. Rara vez encontraba errores nuevos; en cada ronda simplemente desenterraba unos cuantos antiguos más.
Más tarde cambiaron cuatro reglas:
Si aún no ha pasado después de tres rondas, recordar al autor que dé un paso atrás y replantee el enfoque;
Después de las primeras rondas, revisar solo los cambios recién añadidos;
Señalar los problemas del mismo tipo todos a la vez;
No repetir problemas que ya se han planteado.
El efecto fue inmediato.
La proporción de PR internos que pasaron tras una ronda de revisión y correcciones subió del 65% al 78%; los que necesitaban cinco o más rondas cayeron del 8,9% al 1,5%; el número promedio de revisiones bajó de 2,08 a 1,32.

Tras ajustar las reglas de re-revisión, la tasa de aprobación después de una ronda de revisión y correcciones subió del 65% al 78%, y el número promedio de revisiones bajó de 2,08 a 1,32.
El arte de la revisión es mitad encontrar problemas y mitad saber cuándo parar.
¿Acaso la revisión en múltiples capas significa que es infalible?
La propia Anthropic dio un contraejemplo.
El 26 de marzo, Claude Code lanzó una optimización: cuando una sesión permanece inactiva más de una hora, limpiar una vez los registros de razonamiento antiguos.
Pero un error hizo que ejecutara la limpieza en cada turno después de reanudar una conversación. Como resultado, Claude se volvió olvidadizo, empezó a repetirse y usó las herramientas de forma anormal. El error no se corrigió hasta el 10 de abril.

Tras la inactividad, el razonamiento antiguo debería haberse limpiado solo una vez, pero en realidad seguía limpiando en cada turno; el recuadro rojo marca el contenido eliminado por error.
El análisis posterior oficial del 23 de abril admitió:
Este cambio pasó por múltiples rondas de revisión humana y automatizada; las pruebas unitarias, las pruebas de extremo a extremo y el dogfooding interno no lograron detectarlo, y solo confirmar la causa raíz llevó más de una semana.
El punto de inflexión llegó en el análisis posterior.
El equipo volvió a revisar con Code Review el PR que causó el incidente; al darle suficiente contexto de los repositorios relevantes, Opus 4.7 encontró el error, mientras que Opus 4.6 no.
Esta prueba retrospectiva mostró que tanto la capacidad del modelo como la completitud del contexto afectan los resultados de detección. Así que habilitaron que la revisión incorporara más repositorios.
Hoy, cada incidente se convierte en una pregunta de examen.
El equipo recopila PR, cuenta con ingenieros familiarizados con el código que confirman los errores uno por uno y los compila en un conjunto de pruebas.
El revisor se ejecuta contra este conjunto de pruebas todos los días. Cada vez que se ajustan los prompts, las herramientas o los modelos, también se usa para comprobar el efecto: si la puntuación no mejora, el ajuste no se adopta.
El equipo tampoco exageró las cosas.
Después de que los cambios se ponen en producción, los desarrolladores y el personal de guardia todavía necesitan detectar anomalías usando paneles de datos.
El mecanismo de "cortacircuitos" que ajusta automáticamente las aprobaciones según métricas como la tasa de reversión aún no se ha construido. Los ingenieros quieren añadir primero esta salvaguarda antes de permitir que más cambios pasen con aprobación de cero humanos.
La revisión inevitablemente pasará cosas por alto; la detección y la remediación también deben mantenerse al día.
Un miembro del equipo de Claude Code lo explicó así: ralentizar reduce los errores, pero principalmente porque estás haciendo menos de todo. Por eso prefieren dedicar esfuerzo a encontrar problemas más rápido y corregirlos más rápido.
Cuando una persona escribe código con IA, qué hay que aceptar
La revisión de IA solo da opiniones; tú sigues siendo quien toma la decisión.
Así que no te apresures a perseguir "no necesitar mirar"; en su lugar, primero haz que la IA responda tres preguntas en cada entrega.
Primero, ¿cómo se verificó?
Qué comprobaciones se ejecutaron, cuáles fueron los resultados y qué casos aún no están cubiertos.
Boris Cherny, el creador de Claude Code, ha dicho que darle a Claude una forma de verificarse a sí mismo puede ser lo más importante. Estima que esto puede hacer que la calidad del resultado final alcance 2 a 3 veces la original.

Boris Cherny recomienda dejar que Claude verifique su propio trabajo para formar un bucle de retroalimentación; estima que la calidad del resultado final puede mejorarse de 2 a 3 veces.
Segundo, ¿qué afectará?
Qué usuarios, datos y permisos están involucrados en el cambio.
Si haces que la IA añada una función para compartir a una herramienta de informes, tienes que preguntar claramente: quién puede abrir el enlace y qué se puede ver después de abrirlo.
Tercero, ¿cómo se revierte si algo sale mal? ¿Puedes desactivar la nueva función con un clic y volver a la versión anterior?
Confirma un archivo antes de empezar y mantén cada cambio lo más pequeño posible. Primero poder revertir, luego hablar de revisar menos.
Además de estas tres preguntas, cultiva tres hábitos más.
Primero, revisa con un "cerebro" diferente.
En la sesión en la que se escribe el código, es más fácil hacer la vista gorda ante los propios errores.
Abre una nueva sesión, o haz que un subagente revise con un contexto completamente nuevo; los comandos locales /code-review y /security-review también se pueden ejecutar directamente.
Segundo, clasifica los cambios por niveles.
Para cambios de texto y ajustes de estilo, fusiona después de que las comprobaciones pasen y se confirme el efecto real; para cualquier cosa que implique inicio de sesión, pagos o eliminación de datos, una persona debe inspeccionar cuidadosamente la lógica clave y añadir pruebas específicas.
Sé más estricto al principio y, una vez que los procesos de verificación y reversión funcionen sin problemas, reduce gradualmente la revisión manual de los cambios de bajo riesgo.
Tercero, si tres rondas no lo consiguen, cambia de enfoque.
Si la IA ha revisado durante tres rondas y sigue dando vueltas, no la presiones para una cuarta ronda; primero pregunta si el enfoque en sí es incorrecto.
El punto más importante: que la IA diga "aprobado" no significa que hayas completado la aceptación.
Tú le hiciste escribir el código, y también debes ser responsable de los resultados después de que se ponga en producción.
El objetivo del equipo de Claude Code es que la mayoría de los PR involucren como máximo a una persona, manteniendo bajo control la tasa de reversión y la tasa de incidentes.
La atención humana debería centrarse más en juzgar los riesgos, confirmar si las comprobaciones son suficientes y cómo remediar las cosas después de que ocurran errores.
No es necesario que las personas lean cada línea de código, pero cada lanzamiento debe tener a alguien responsable de él.
Referencias:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
Editor: Yuanyu
Este artículo proviene de la cuenta pública de WeChat "Xinzhiyuan" (ID: AI_era), autor: ASI Revelation