
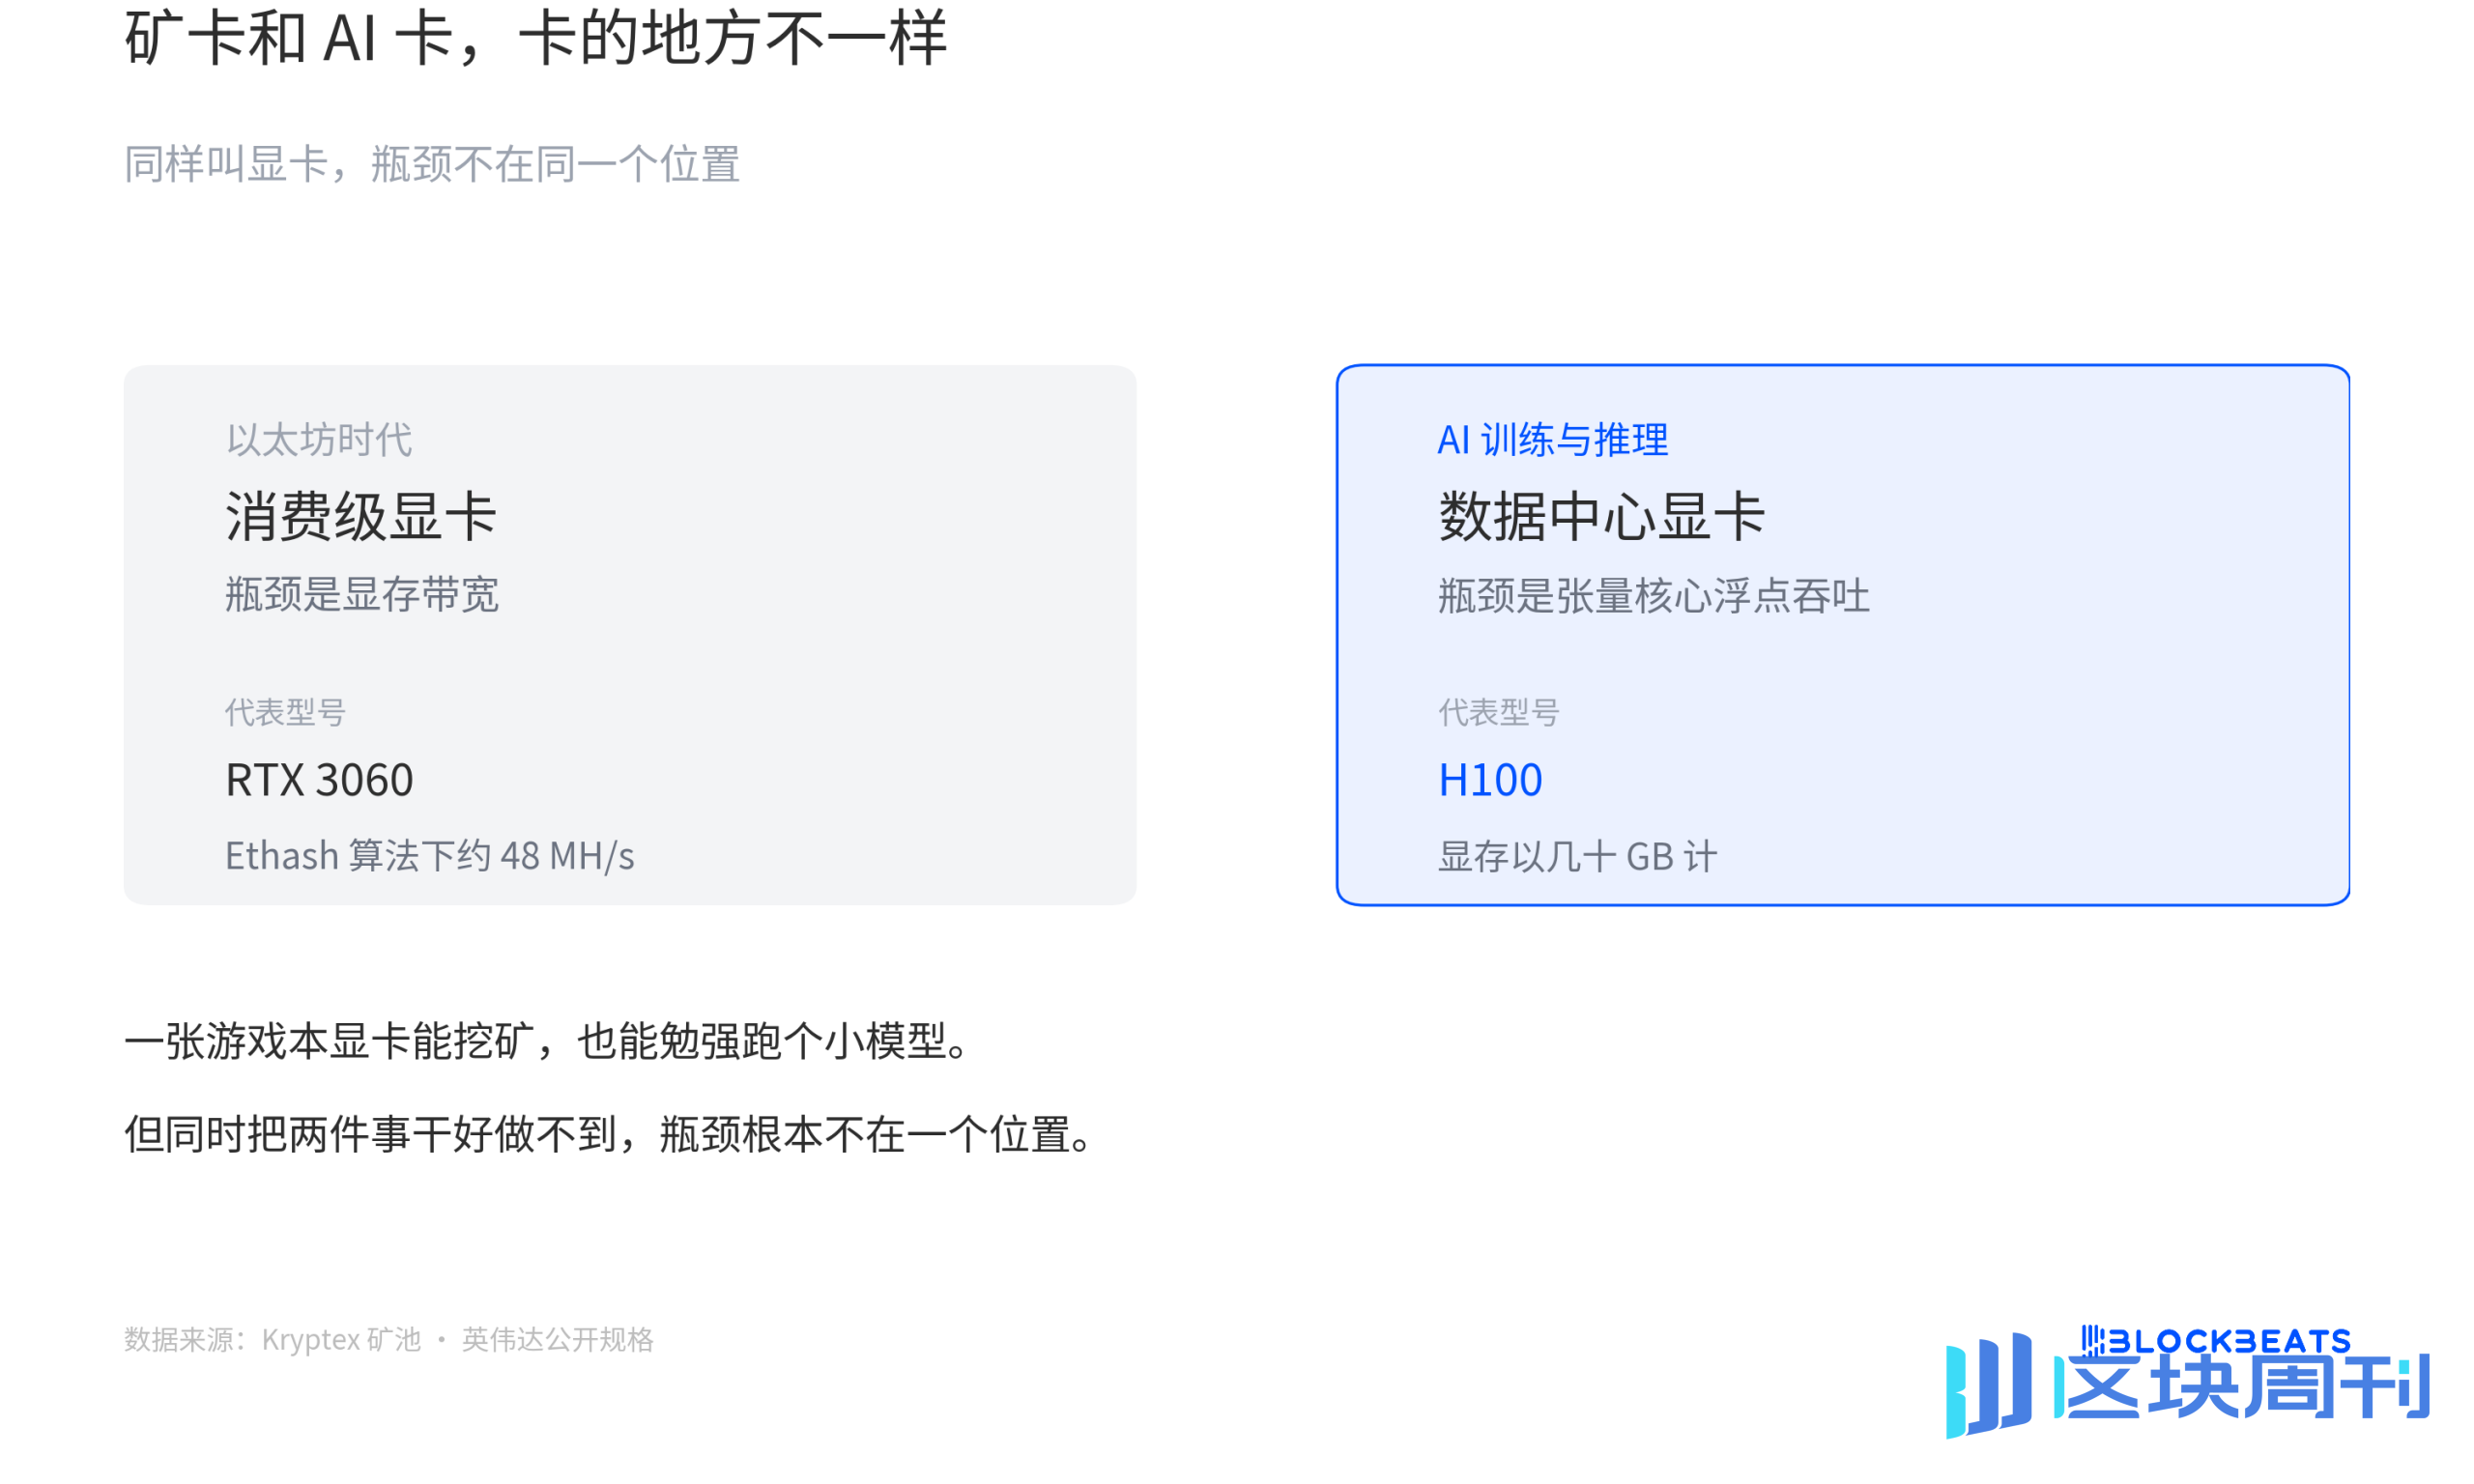
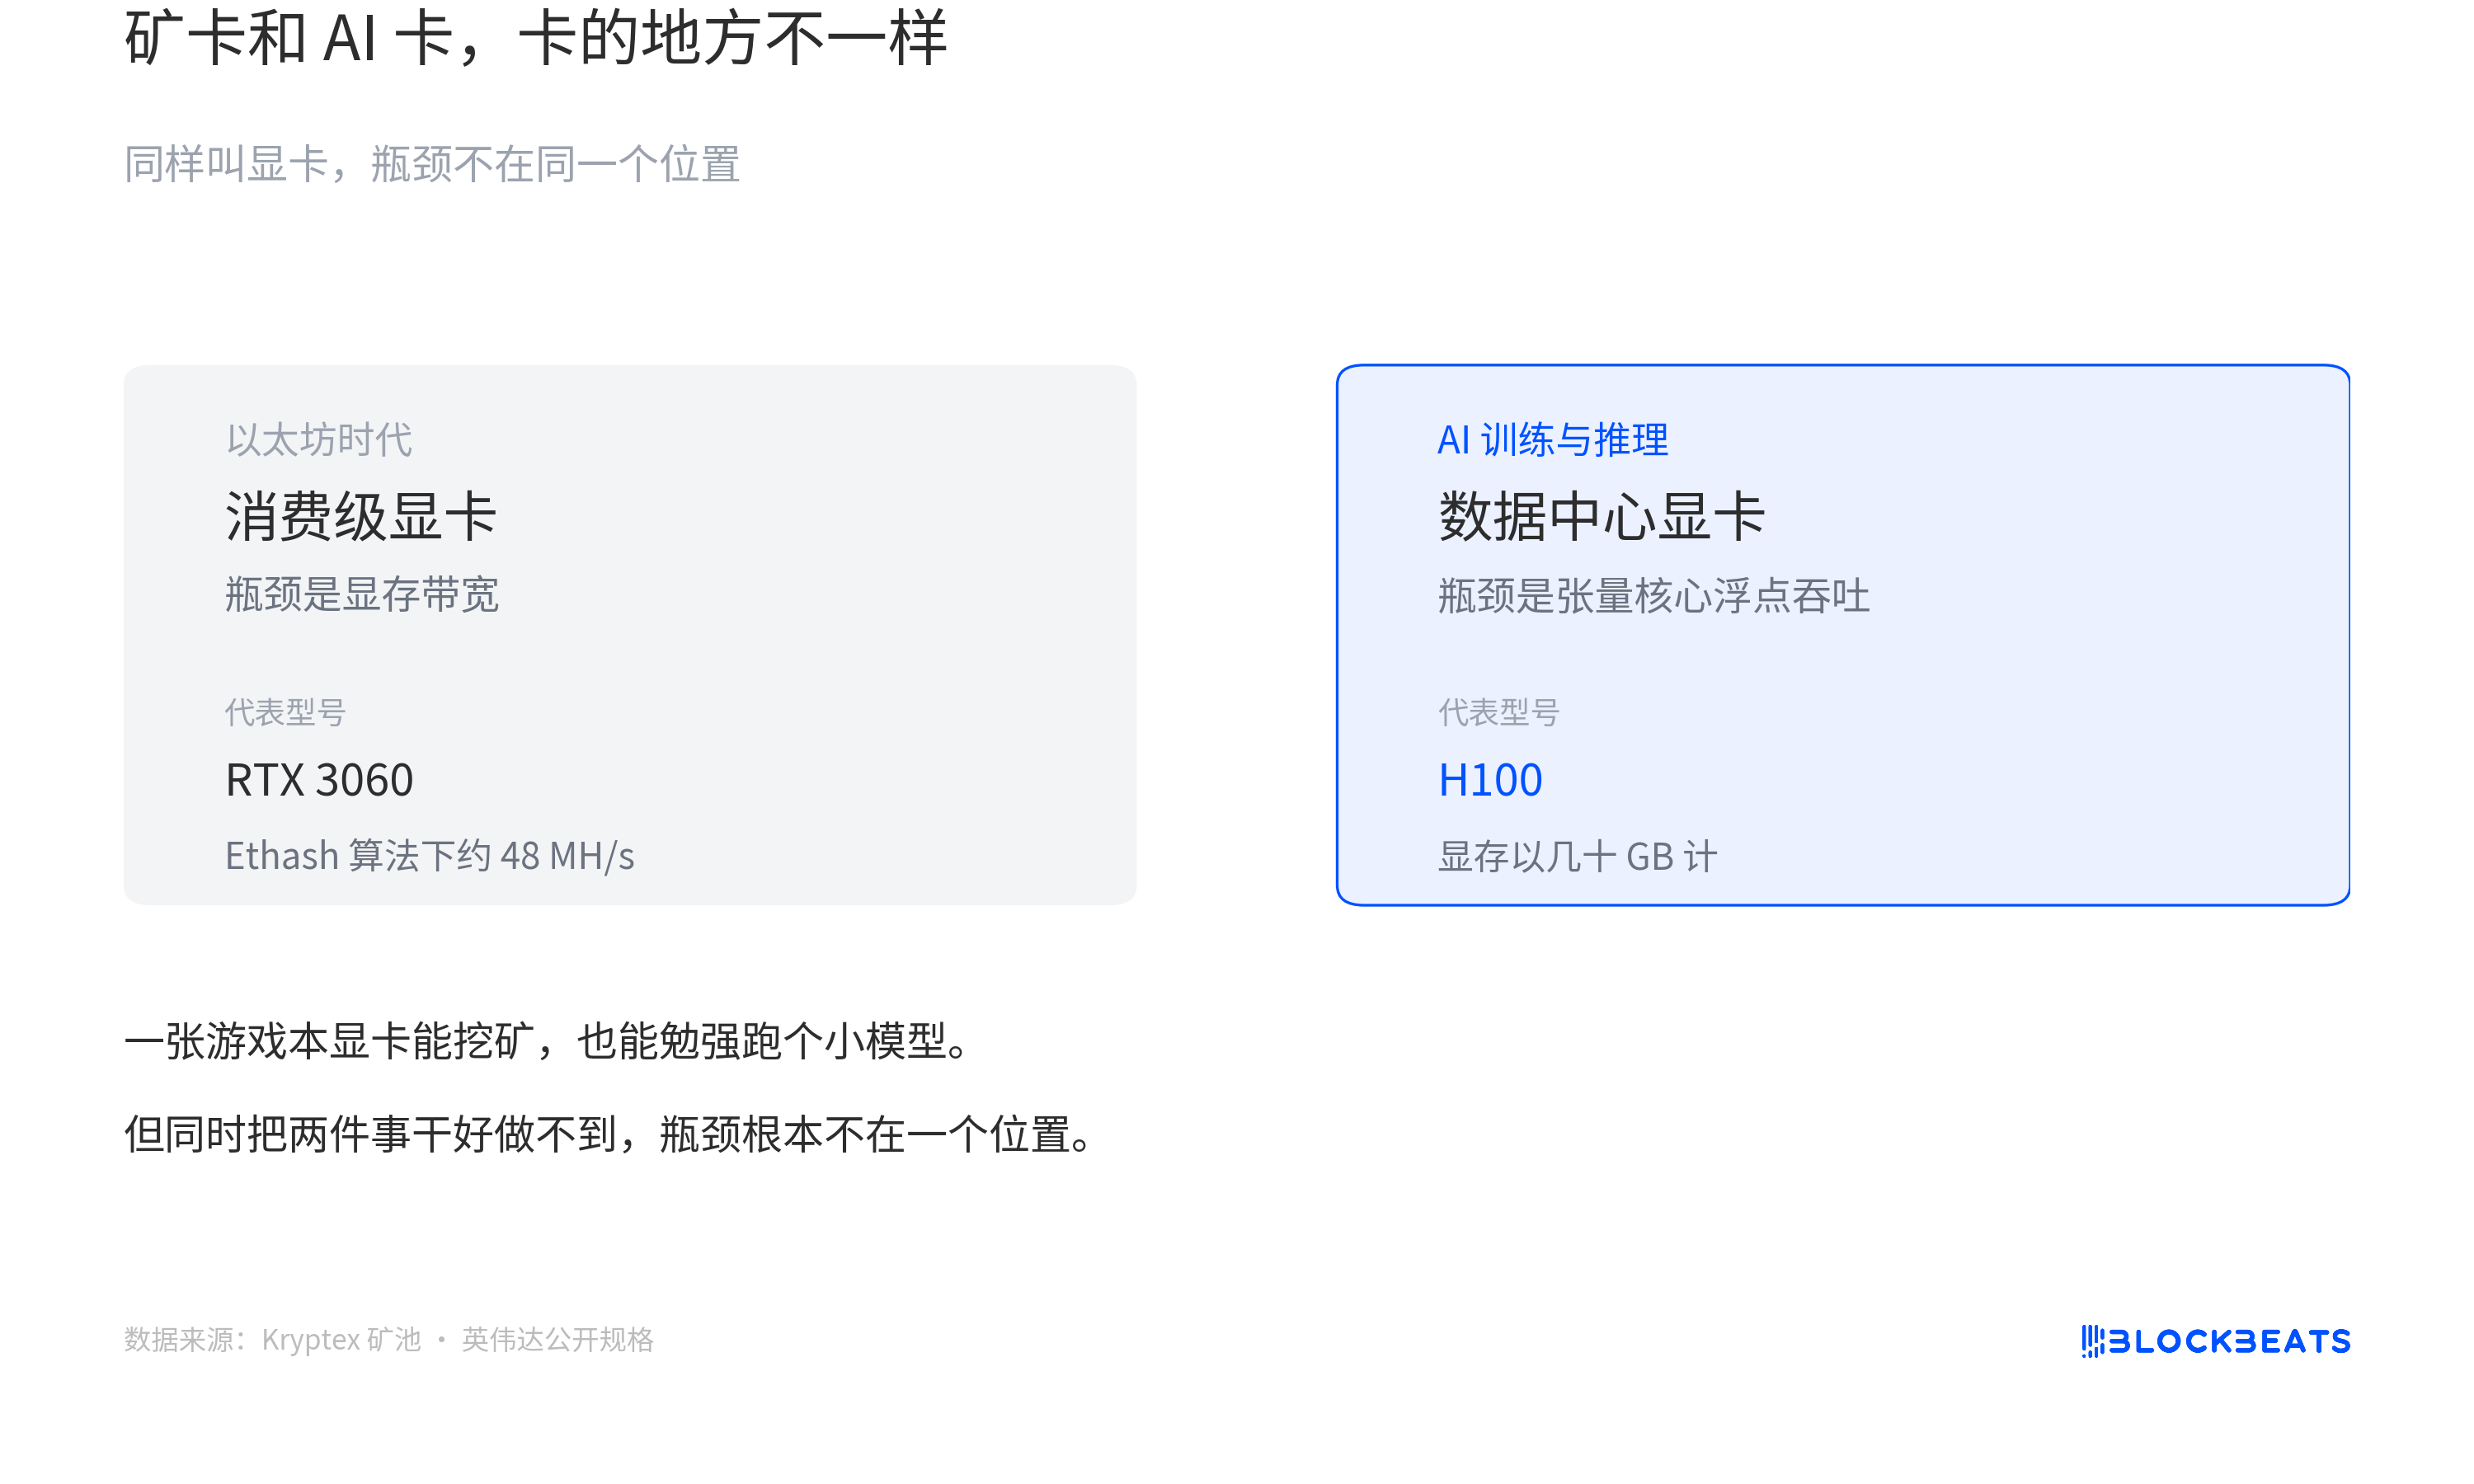
Pendant les années où Ethereum était encore en POW, les mineurs utilisaient des cartes graphiques grand public, et l'algorithme s'appelait Ethash. Une RTX 3060 fait environ 48 MH/s sur Ethash. À l'époque, certains pensaient que puisque le minage et l'IA reposent tous deux sur des cartes graphiques, la même carte pourrait miner et exécuter des modèles en même temps.
Cette idée n'a pas fonctionné car les deux choses ont des goulots d'étranglement à des endroits différents. Ethash est limité par la bande passante mémoire et calcule des hachages à difficulté fixe. L'IA a besoin du débit en virgule flottante des cœurs tensoriels et de dizaines de Go de VRAM, les principaux chevaux de trait étant des cartes de centre de données comme la H100. Une carte graphique dans un ordinateur portable de jeu peut miner et peut à peine exécuter un petit modèle, mais elle ne peut pas faire les deux bien en même temps.
En 2019, Vitalik Buterin a porté un jugement sur cette question. Ses mots originaux étaient que si un type de calcul utile et facilement vérifiable pouvait être trouvé, le minage de cryptomonnaie deviendrait une immense richesse pour la société, mais c'est probablement impossible.
Pearl affirme l'avoir fait. Le jugement de Vitalik d'il y a quelques années est affiché bien en évidence sur le site officiel de Pearl.
Pearl est une chaîne publique indépendante à preuve de travail, et son jeton s'appelle PRL. Les mineurs ne calculent plus répétitivement des hachages ; au lieu de cela, ils effectuent des multiplications matricielles, le type de multiplication-addition que chaque couche d'un réseau neuronal effectue. Par conception, le même calcul GPU produit à la fois des blocs et émet des pièces, et produit également un calcul d'IA vérifiable.
La description officielle de cela est « énergie, données et argent en une seule opération ». Bitcoin lie l'énergie et l'argent, l'IA lie l'énergie et les données, et la monétisation lie les données et l'argent. Ces trois choses se rencontraient auparavant deux à la fois ; Pearl veut que les trois se produisent simultanément dans une seule multiplication matricielle.
La ligne PoW est restée silencieuse pendant longtemps. La dernière vague de nouvelles chaînes publiques qui pouvait faire asseoir les gens et les discuter sérieusement s'est essentiellement terminée il y a des années. Après cela, l'engouement a été dans les L2, la modularité et le restaking. Une nouvelle chaîne PoW en soi est rare. Maintenant, PRL, avec une capitalisation boursière en circulation de 430 millions USD, veut raconter quel genre d'histoire ?
Quel problème veut-il résoudre
La preuve de travail de Bitcoin a une caractéristique : ce que les mineurs calculent n'a rien à voir avec le monde réel. Le même kilowattheure, s'il est utilisé pour exécuter des modèles, peut produire des jetons, générer des images et faire du travail. Beaucoup de gens estiment qu'il est un peu gaspilleur de l'utiliser pour le minage.
La véritable difficulté n'est pas « l'utilité », mais l'absence de permission. L'absence de permission signifie que n'importe qui peut venir miner, sans s'inscrire, et personne ne vérifie les qualifications. Le modèle de sécurité de Bitcoin est construit là-dessus : peu importe ce que vous calculez, le coût est le même. Une fois que le travail est remplacé par quelque chose de valeur réelle, les mineurs ont intérêt à réduire les coins ou à choisir une entrée bon marché. Donc la question n'est pas de savoir si le minage peut être rendu utile, mais s'il peut être rendu utile alors que personne ne peut tricher.
L'affirmation de Pearl est qu'elle remplace le hachage aléatoire de Bitcoin par la multiplication matricielle, permettant aux GPU de traiter la preuve de travail comme un sous-produit des charges de travail d'IA. Le livre blanc utilise directement le terme « 2 pour 1 ». En termes simples, auparavant un lot de GPU n'avait que deux destinations : soit miner, brûlant de l'électricité tout en émettant des pièces, soit exécuter des modèles, brûlant de l'électricité tout en produisant des jetons. Pearl veut fusionner ces deux destinations en une seule.
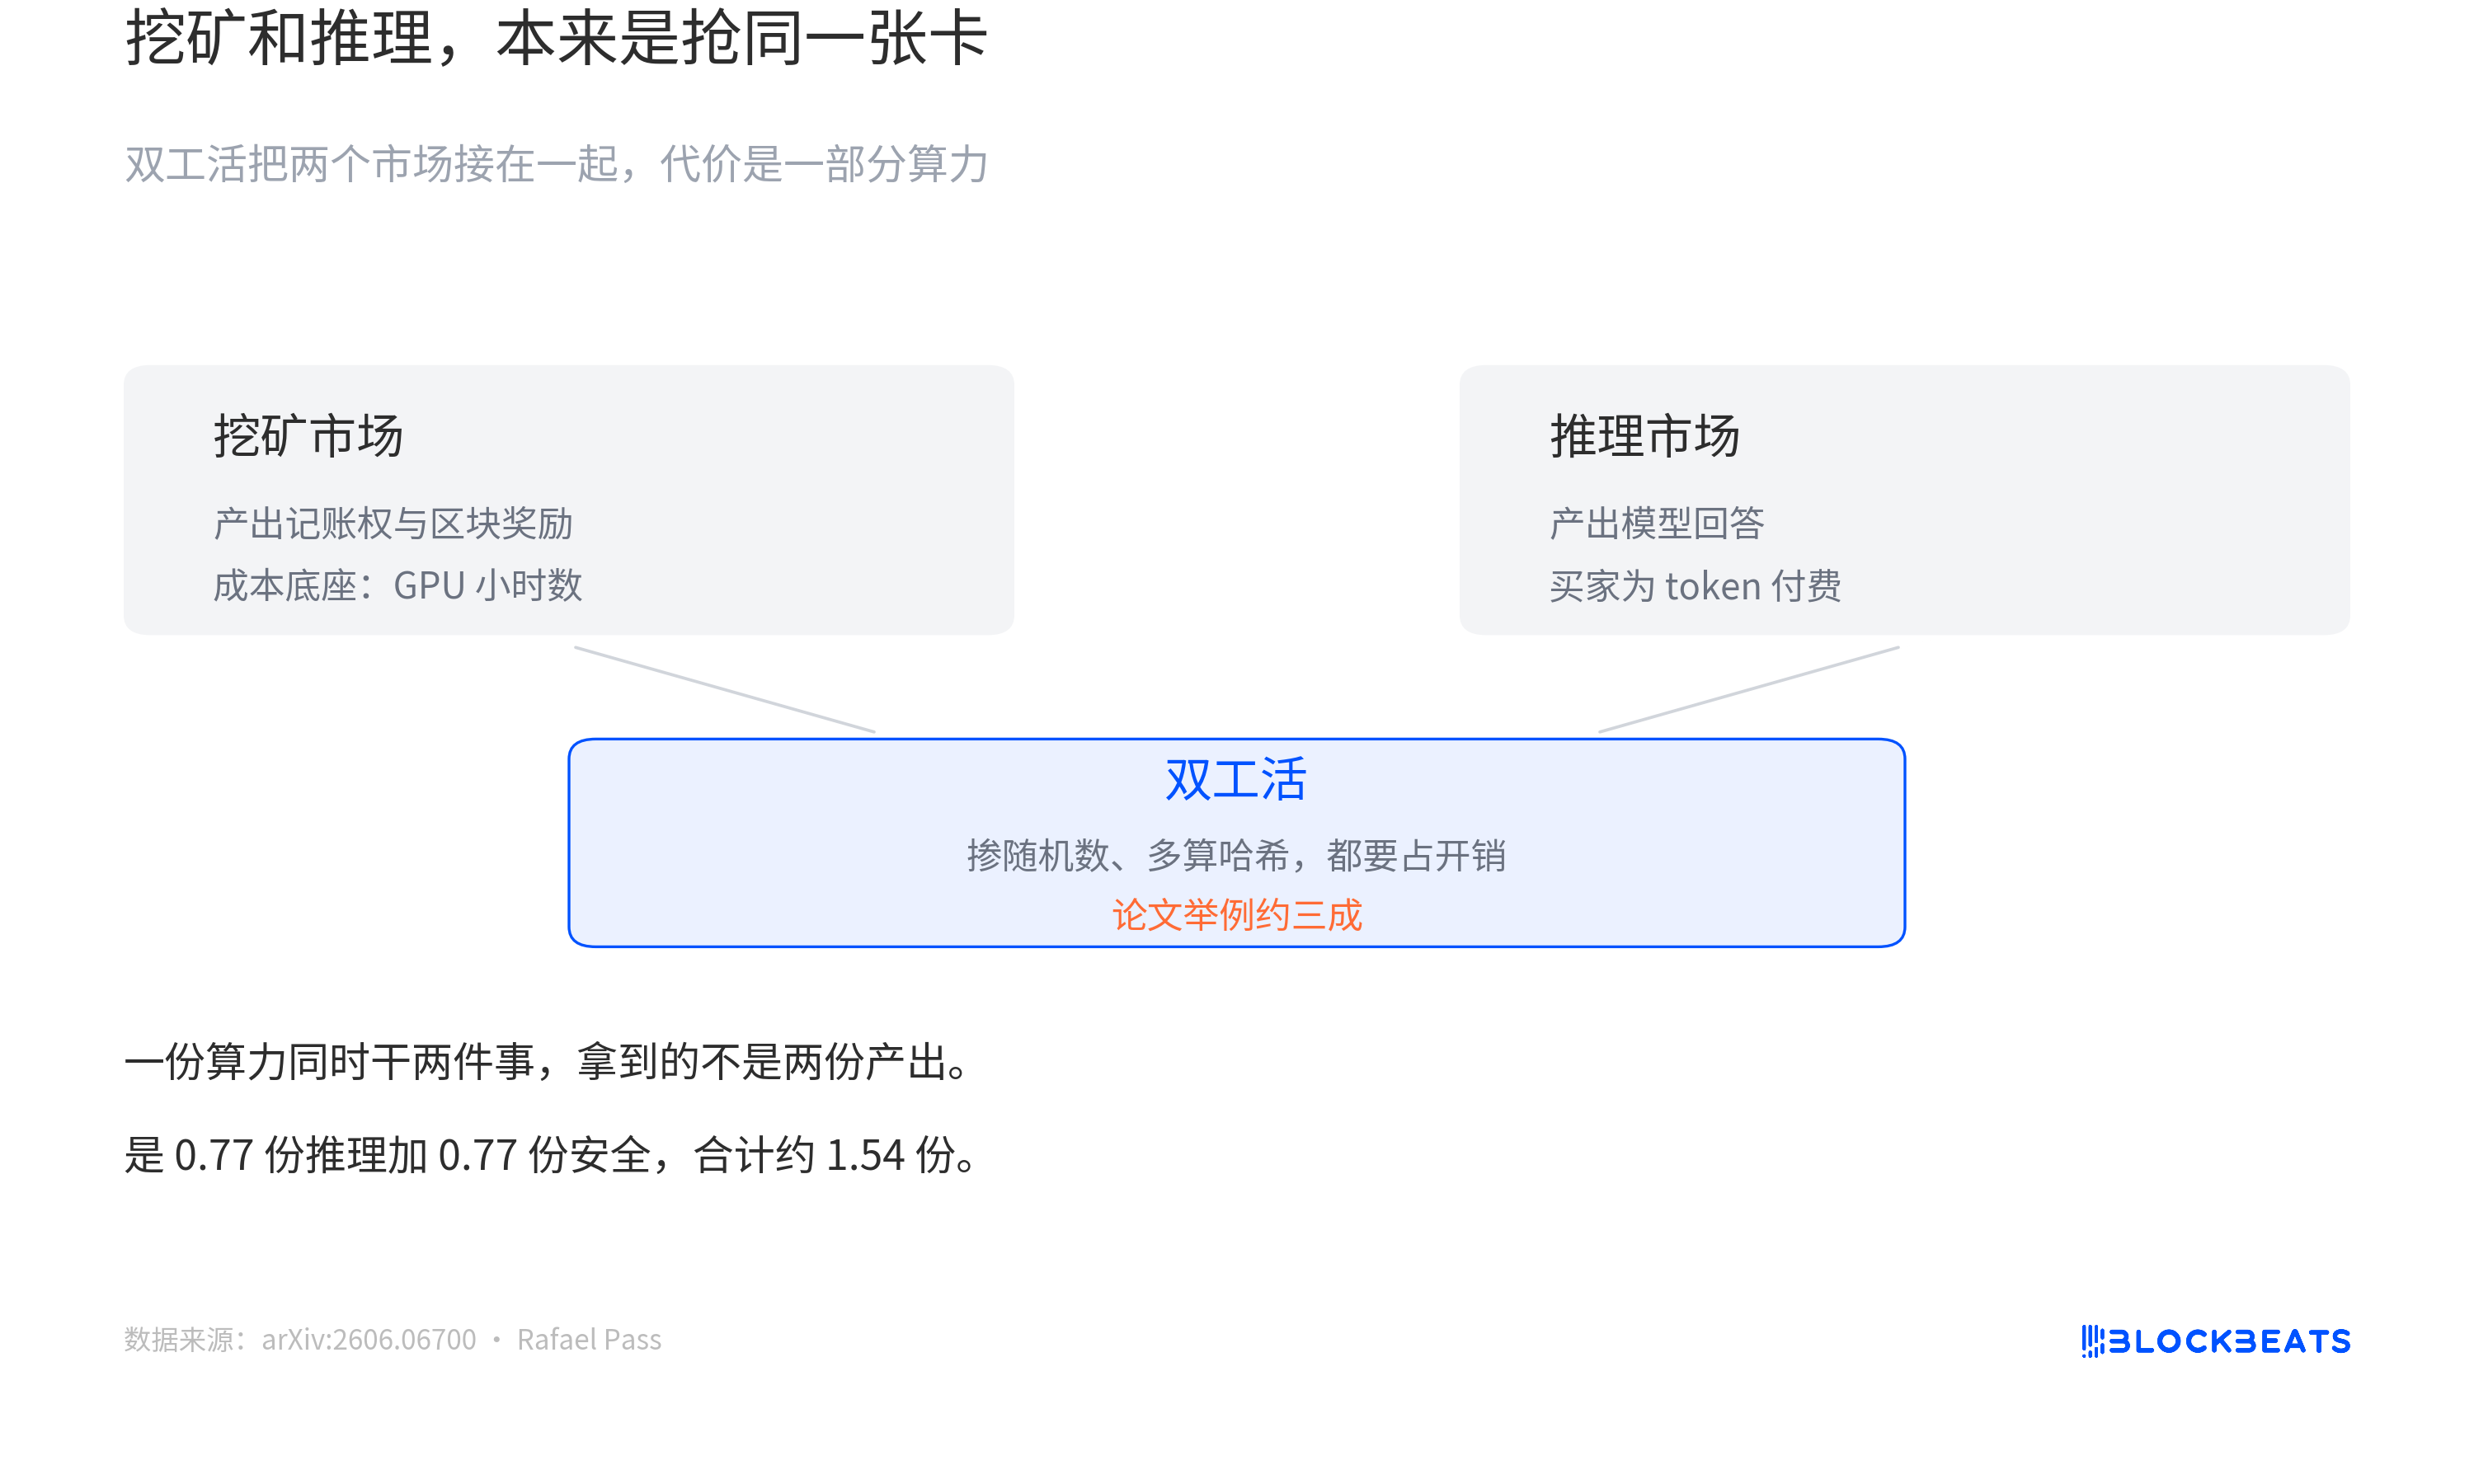
Quelqu'un a calculé cette idée en détail. L'article du chercheur en cryptographie Rafael Pass « The Economics of Proof-of-Useful-Work » divise le travail d'une machine en trois types : minage pur, inférence pure, et double travail qui produit les deux simultanément. Le double travail n'est pas gratuit. L'article donne un exemple : une unité de puissance de calcul faisant deux choses à la fois n'obtient pas deux sorties, mais environ une et demie. Si la surcharge est suffisamment faible et l'échelle à laquelle le jeton est accepté par le marché suffisamment grande, la récompense de bloc équivaut à accorder un rabais sur le prix de l'inférence, attirant une puissance de calcul d'inférence qui autrement n'aurait pas été effectuée. Ce raisonnement est mathématiquement impeccable, mais le problème est que ses trois variables—surcharge, prix du jeton et demande d'inférence—ne sont pas quelque chose que Pearl peut décider seule. Une note de bas de page dans l'article révèle que l'auteur a réalisé ce travail en tant que consultant pour Pearl Research Labs.
La logique de fonctionnement de Pearl
Pour expliquer comment ce système fonctionne, nous devons d'abord décomposer le terme multiplication matricielle. Il n'a pas été inventé par Pearl ; c'est une opération très ancienne, et presque chaque couche d'un réseau neuronal l'utilise.
Une matrice est un tableau de nombres disposés en lignes et en colonnes. Deux tableaux peuvent être multipliés si le nombre de colonnes du premier est égal au nombre de lignes du second. Chaque cellule du tableau résultat est la somme des produits d'une ligne du premier tableau et d'une colonne du second tableau, multipliés un à un puis tous additionnés. Prenons le plus petit exemple : la première ligne de A est 1 et 2, la première colonne de B est 5 et 7, alors le coin supérieur gauche du tableau résultat est 1 fois 5 plus 2 fois 7, ce qui équivaut à 19. Les cellules restantes sont remplies une par une selon cette règle.
Dans un modèle d'IA, le calcul d'une couche peut s'écrire comme « entrée fois poids ». La phrase d'un utilisateur est découpée en vecteurs, multipliée par le tableau de poids de cette couche pour obtenir un résultat, puis passée par une fonction non linéaire et transmise à la couche suivante. Plus le modèle est grand, plus les tableaux sont grands, et le nombre de multiplications-additions en une passe peut se chiffrer en billions. Les GPU sont conçus pour ce genre de multiplications-additions bien ordonnées, ce qui explique aussi pourquoi les cartes de minage et les cartes d'IA sont le même type de puce.
En théorie, les choses fonctionnent ainsi. Quelqu'un pose une question à un chatbot en ligne, et la carte graphique du serveur commence à exécuter le modèle, effectuant la multiplication matricielle couche par couche. Si cette machine a le plugin de Pearl installé et exécute son modèle open source certifié, alors ces multiplications, tout en produisant une réponse, servent aussi à tenter leur chance. Après le calcul de chaque petit bloc, une empreinte est frottée une fois. Si l'empreinte est suffisamment petite, un ticket de loterie est gagné, et gagner permet d'obtenir la récompense de bloc. L'utilisateur ne voit aucune différence, obtient toujours la réponse, et le prix pourrait même être un peu moins cher. Le même lot de multiplications-additions se transforme en tokens d'un côté et en pièces de l'autre.

Pour que ce système fonctionne, il doit d'abord résoudre la triche. Le mineur a juste deux tableaux en main, et il doit d'abord frotter les tableaux en une empreinte et la soumettre. Ce qu'on appelle frotter une empreinte signifie prendre tous les nombres de ce tableau et calculer un hachage ensemble, en le compressant en un segment très court. Ce n'est qu'après que la chaîne a vu cette empreinte qu'elle lui dira quels nombres aléatoires mélanger dans les tableaux. L'ordre est verrouillé, et il est trop tard pour qu'il modifie les tableaux. Le terme officiel pour cette action est ajouter du bruit. En termes simples, cela signifie mélanger une série de nombres aléatoires dans les deux tableaux. Combien est mélangé et où est déterminé par cette empreinte, et le mineur ne peut pas le choisir lui-même.
Sans mélange, il existe un raccourci. Entre le produit propre A fois B et le produit après mélange de nombres aléatoires, il n'y a qu'une différence de trois termes de correction. Ces trois termes ne sont pas de petite magnitude, mais leur calcul est peu coûteux. Le mineur a déjà les A et B propres en main, il pourrait donc complètement d'abord calculer la réponse propre, puis ajouter ces termes de correction peu coûteux pour produire la réponse avec les nombres aléatoires mélangés, sans du tout effectuer cette grande multiplication. C'est comme une question d'examen demandant 3987 fois 2913, mais l'élève a déjà mémorisé la réponse et assemble quelques petits nombres pour donner l'impression qu'il a calculé sérieusement.
Ainsi, le protocole n'exige pas que le mineur remette le résultat calculé, seulement les lignes d'entrée qu'il a utilisées, plus une preuve. Le vérificateur prend cette partie, mélange les mêmes nombres aléatoires, recalcule uniquement ce petit bloc, et vérifie si l'empreinte est correcte. Recalculer un petit bloc est peu coûteux et suffisant pour confirmer qu'il n'a pas triché. Si ces tableaux impliquent des poids d'entreprise ou des données utilisateur, une couche supplémentaire de preuve à divulgation nulle de connaissance peut être ajoutée pour prouver que le calcul a bien été effectué, sans révéler quels deux tableaux ont été utilisés.

Où en est-il arrivé maintenant
Allez sur Hugging Face et regardez ; sous l'organisation pearl-ai, il y a quatre modèles certifiés : Llama 3.3 70B, Llama 3.1 8B, Qwen3 30B et Gemma 4 31B. Officiellement, ils sont appelés « variantes certifiées » ; l'approche ne consiste pas à réentraîner, mais à recompresser le même ensemble de poids dans le format de quantification de Pearl afin qu'ils puissent effectuer l'inférence tout en minant à l'intérieur du plugin. La perte de précision est très faible ; le MMLU de Gemma 4 31B est passé de 90,93 à 90,56. Au 9 octobre 2026, les téléchargements de ces quatre modèles au cours des trente derniers jours variaient de 195 à 6 424, et leurs likes étaient respectivement de 0, 3, 5 et 6.
Il existe également un débouché commercial. En mai 2026, Pearl s'est associé à Together AI pour lancer une interface exécutant le modèle Gemma. Selon l'annonce de Together, le prix d'appel est 25 % moins cher que les interfaces ordinaires, la différence étant compensée par la valeur future des jetons.
Les modèles sont publiés, le code est open source, et puis il n'y a plus rien. En juin 2026, le chercheur Abhinaba Basu a testé cela dans « The Usefulness Gap in Proof-of-Useful-Work ». Selon la puissance de calcul du réseau à l'époque, d'environ 24 EH/s, équivalant à environ 320 000 cartes de niveau RTX 3090, une consommation électrique estimée à 112 mégawatts, et une production de calcul IA utile nulle.
L'auteur a échantillonné 8 012 unités de travail de mineurs ; tout le matériel avait une capacité d'inférence, mais dans le logiciel principal de la machine de minage, il y avait 4 803 chaînes liées à la multiplication matricielle et 0 liée aux frameworks d'apprentissage automatique. Il a également écrit lui-même un programme de minage, remplissant des tables avec des nombres aléatoires, et l'a exécuté avec succès sur Nvidia, AMD, CPU et puces Apple, obtenant des shares reconnus par le pool de minage, 44 au total. Une personne fournissant des données et laissant le modèle calculer le résultat, et utilisant la même carte pour miner des pièces, peuvent être combinés dans la conception, mais en pratique ils sont séparés.
Alors qu'est-ce qui tourne réellement sur le réseau. Selon la page du pool de minage Kryptex, la puissance de calcul du réseau est montée à 46,37 EH/s, la difficulté à 2,26 TH, le temps de bloc à environ 203 secondes, la récompense de bloc à 2 271,03 PRL, la production quotidienne à environ 966 000 pièces, et le prix de la pièce à environ 1,30 $. En six mois, la puissance de calcul a presque doublé, et la grande majorité de cette augmentation consiste encore à remplir des nombres aléatoires. Ce qui est fait sur le marché actuellement se résume principalement à une seule chose : acheter des cartes, les brancher, remplir des nombres aléatoires, attendre le règlement.
Quels problèmes existent
Imaginons que la cafétéria affiche une notice : celui qui hache assez de cent jin de légumes peut recevoir un salaire. L'acte de hacher des légumes est en soi réel ; la dextérité, la force et le temps doivent tous être dépensés. Mais la notice vérifie seulement si vous avez haché assez de cent jin, pas quels légumes vous avez hachés. Alors quelqu'un apporte un chariot de feuilles de légumes pourries, en hache assez de cent jin, et prend le salaire. Il a bien haché des légumes, et il a vraiment dépensé de la force, c'est juste que la cuisine ne peut pas utiliser ce tas de feuilles.
Pearl est maintenant bloqué ici. Le protocole vérifie si l'empreinte de la table correspond, si le résultat est vraiment égal à la multiplication de deux tables, si la charge de travail est suffisante pour la difficulté ; dans la conception formelle, il y a aussi une porte statistique spécialement destinée à bloquer les entrées que l'on peut voir au premier coup d'œil comme ayant été falsifiées. Il vérifie tout cela. Ce qu'il ne vérifie pas, c'est d'où viennent ces deux tables. Ainsi, les mineurs peuvent tout à fait créer eux-mêmes deux tables de nombres aléatoires ; la multiplication est tout aussi difficile, l'empreinte répond tout autant au standard, et ils peuvent gagner tout autant, sauf que personne ne veut utiliser le résultat calculé. Le protocole ne reconnaît que la relation de multiplication, pas la sémantique ; « utile » ici est une question commerciale, pas une garantie cryptographique.
Ce n'est pas une conjecture. Selon le rapport mentionné précédemment, toutes les machines échantillonnées pouvaient exécuter des modèles, pourtant il n'y avait pas une seule ligne de code d'inférence dans le logiciel de la machine de minage, et les tables que l'auteur a remplies lui-même avec des nombres aléatoires ont également obtenu des shares reconnus par le pool de minage. Actuellement, la puissance de calcul du réseau est d'environ 45 EH/s, et la grande majorité consiste encore à remplir des nombres aléatoires.
L'écart d'échelle peut aussi se voir ainsi. L'article a donné un contrefactuel : si cette conception fonctionnait vraiment comme annoncé, alors à ce moment-là le réseau de 24 EH/s aurait dû produire environ 7,7 millions d'heures GPU de puissance de calcul IA utile par jour. L'article a également mentionné un indicateur appelé le ratio de destruction de valeur ; la valeur mesurée de Pearl est de 1,0, au niveau de Bitcoin, tandis que celle de Filecoin est d'environ 0,64.
Les mineurs ne prennent pas de commandes d'inférence, non pas parce qu'ils ne comprennent pas, mais parce qu'ils ont fait le calcul. L'article estime que coupler le moteur d'inférence à l'exploitation minière ferait perdre environ 10 % à 30 % de la puissance de calcul effective. Autrement dit, prendre de véritables inférences nécessite non seulement de changer les logiciels et de s'adapter au rythme des requêtes, mais aussi de perdre d'abord cette portion de puissance de calcul. Les années où le prix de la pièce n'est pas élevé, ce compte est facilement calculé comme négatif.
Alors comment cela pourrait-il être résolu. L'article a énuméré plusieurs pistes. L'une consiste à gérer la source des tables, en exigeant que les mineurs utilisent des tables soumises par des clients externes. Le plugin et les modèles certifiés que Pearl propose officiellement vont dans cette direction : remettre le modèle et le plugin aux mineurs ; vous utilisez le vrai modèle pour exécuter l'inférence, et cette multiplication exploite commodément la pièce également. La difficulté est que c'est volontaire ; la décision de l'accepter dépend encore des mineurs qui calculent leur propre compte économique.
Une autre consiste à vérifier si les tables ressemblent à de vraies. Les poids des vrais modèles et des nombres aléatoires remplis au hasard diffèrent par leurs caractéristiques statistiques. Mais l'article lui-même a rejeté cette piste : les mineurs n'ont qu'à ajuster la distribution pour tromper la vérification, à un coût presque nul. Il existe aussi plusieurs pistes plus lointaines qui n'ont pas encore abouti. Faire de la source du modèle une signature vérifiable nécessite d'abord de disposer d'un système de clé publique pour le côté modèle. Utiliser du matériel de confiance pour prouver la provenance des données nécessite de faire confiance en plus aux fabricants de puces et ralentira également les choses. Différencier les récompenses, en donnant un peu plus pour l'utilisation de données réelles, nécessite d'abord d'avoir un groupe de clients réellement prêts à payer.
Le développeur de Pearl est Pearl Research Labs. Omri Weinstein est cofondateur et PDG ; ce titre provient de l'annonce du partenariat avec Together AI. Il est chercheur en théorie de la complexité, occupe un poste de professeur à l'Université hébraïque et est l'un des auteurs de cet article fondamental.
Un autre auteur, Ilan Komargodski, figure également sur la liste des membres de l'organisation Hugging Face ; on ne peut pas prouver à partir de sources publiques si son identité précise est employé ou consultant. Un autre nom qui peut être associé est Erez Badash, premier auteur de l'article Hawkeye sur la reproduction bit à bit des GPU.
Bittensor a des validateurs qui notent les sorties de modèles soumises par les mineurs, la note étant déterminée par un consensus appelé Yuma. io loue des GPU à la demande pour des tâches d'apprentissage automatique. Pearl parie sur une hypothèse plus étroite : la multiplication utilisée pour la génération de blocs elle-même peut être recherchée par quelqu'un.
Il parie que la demande d'inférence deviendra suffisamment importante pour consommer la puissance de calcul de génération de blocs. À ce moment-là, les mineurs eux-mêmes calculeront clairement que prendre de vraies commandes est plus rentable que de remplir des nombres aléatoires. S'il ne peut pas atteindre ce point, alors ce n'est qu'une chaîne d'exploitation minière de cartes graphiques avec des mathématiques modifiées ; ce qui est calculé est homologue à l'IA, et sans rapport avec les attentes d'un utilisateur spécifique.