Towarzysze, Anthropic znowu obniża ceny. Tym razem chodzi o najtańszy model w rodzinie Claude, Haiku.
7 października Anthropic oficjalnie wydał Claude Haiku 5.5, twierdząc, że jest to jego najszybszy, najbardziej wydajny i najtańszy mały model do tej pory.
Najbardziej absurdalna jest cena, zaledwie 0,1 dolara za milion tokenów wejściowych, co stanowi bezpośrednią obniżkę ceny o 90% w porównaniu z poprzednią generacją.
Wydajność również nie pozostaje w tyle. Według wyników testów opublikowanych przez Anthropic, Haiku 5.5 przewyższa OpenAI GPT-6 Luna w wielu benchmarkach, w tym w obsłudze komputera, pracy z wiedzą i programowaniu Agent, a niektóre wyniki pokazują nawet znaczną różnicę.
Co więcej, Haiku 5.5 wprowadza również regulowaną intensywność rozumowania, obsługując okno kontekstu o rozmiarze 1 miliona tokenów i do 128 000 tokenów wyjściowych.
W tym momencie Anthropic zakończył aktualizację całej rodziny Claude 5.5 w zaledwie 15 dni: Opus 5.5 pojawił się 22 września, Sonnet 5.5 został wydany 28 września, a teraz Haiku 5.5 oficjalnie dołączył.
Tym razem Anthropic skupił się na tych zadaniach AI o ogromnej liczbie wywołań i ekstremalnej wrażliwości na cenę.
Wiele wyników przewyższa GPT-6 Luna, wskaźnik sukcesu obsługi komputera 72,4%
Według wyników Benchmark opublikowanych przez Anthropic, Haiku 5.5 osiągnął znaczącą poprawę w porównaniu z poprzednią generacją, a w niektórych testach osiągnął nawet lepsze wyniki niż GPT-6 Luna.
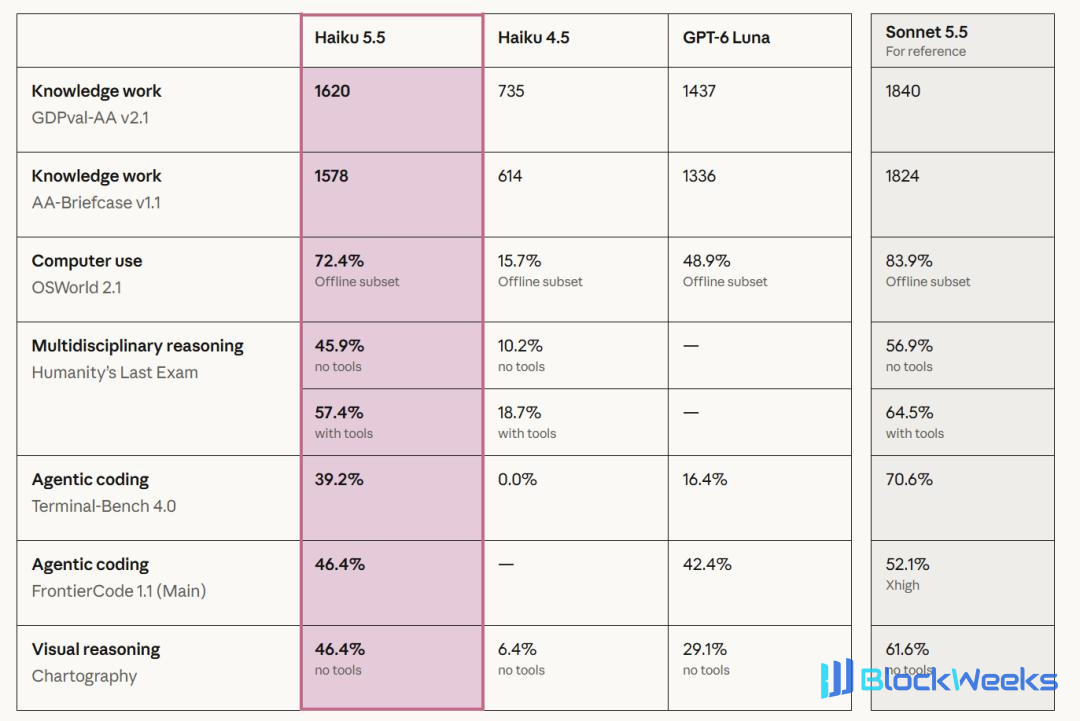
Najbardziej godny uwagi wynik pochodzi z OSWorld. Jest to test mierzący zdolność Agenta AI do obsługi prawdziwego komputera, wymagający od modelu wykonania zadań obejmujących wiele aplikacji i wiele kroków.
W podzbiorze zadań offline OSWorld 2.1, Haiku 5.5 osiągnął 72,4% wskaźnika sukcesu, podczas gdy poprzednia generacja Haiku 4.5 miała tylko 15,7%, a GPT-6 Luna 48,9%.
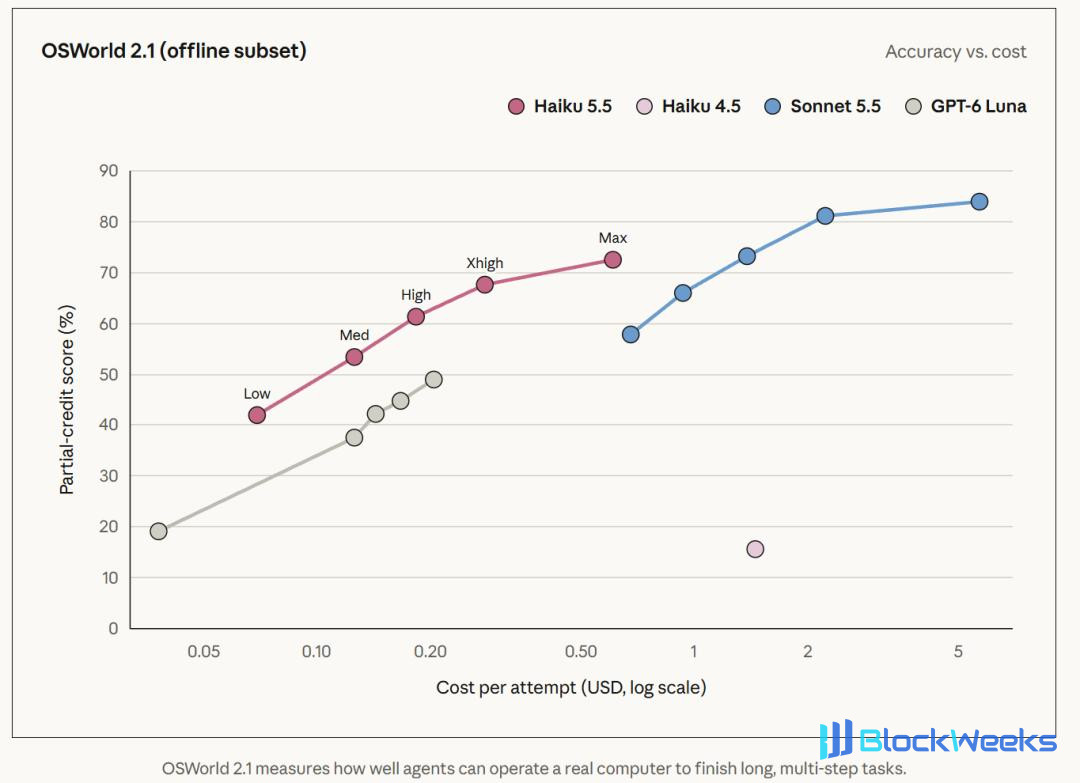
W zakresie pracy z wiedzą, Haiku 5.5 uzyskał 1620 punktów w GDPval-AA v2.1, przewyższając GPT-6 Luna z wynikiem 1437. W teście programowania Agent Terminal-Bench 4.0 oba modele uzyskały odpowiednio 39,2% i 16,4%.
Jednak w tych danych kryje się ważny szczegół. Najwyższe wyniki Benchmark Haiku 5.5 często wymagają większej ilości obliczeń rozumowania.
Haiku 5.5 po raz pierwszy w serii Haiku wprowadza regulowaną intensywność rozumowania, pozwalając programistom kontrolować, ile zasobów obliczeniowych model inwestuje poprzez parametr effort.
Medium VentureBeat zauważyło, że w teście Terminal-Bench opublikowanym przez Anthropic, wynik 39,2% odpowiada maksymalnej intensywności rozumowania. Po przełączeniu na średnią intensywność rozumowania wynik spada do około 20%, a średnia intensywność jest dokładnie domyślnym ustawieniem dla Haiku 5.5.
Zewnętrzna agencja oceniająca Artificial Analysis również zaobserwowała podobne zjawisko. W jej ocenie Intelligence Index, Haiku 5.5 uzyskał 43 punkty przy maksymalnej intensywności rozumowania i 34 punkty przy średniej intensywności rozumowania. W tej samej ocenie średni koszt na zadanie wyniósł odpowiednio około 0,21 dolara i 0,05 dolara.
Innymi słowy, model może wymieniać zwiększony budżet rozumowania na lepszą wydajność zadania, ale rzeczywisty koszt może również znacznie wzrosnąć.
W swoim własnym teście Terminal-Bench 4.0, Artificial Analysis zmierzył wyniki na poziomie 33% przy maksymalnej intensywności rozumowania i 15% przy średniej intensywności. Ze względu na różne ustawienia oceny, liczby te różnią się od oficjalnych wyników Anthropic.
To także dlatego, patrząc na wydajność małych modeli, należy jednocześnie rozważyć intensywność rozumowania, wskaźnik ukończenia zadań i rzeczywisty koszt.
W bardziej złożonych zadaniach programowania Agent, Sonnet 5.5 nadal ma wyraźną przewagę: jego wynik w Terminal-Bench 4.0 osiąga 70,6%.
Anthropic również wyraźnie stwierdził, że Sonnet i Opus są nadal bardziej odpowiednie do złożonych zadań programowania Agent, podczas gdy zalety Haiku koncentrują się na pracy o wysokiej częstotliwości i jasno określonym zakresie.
Cena obniżona bezpośrednio do jednej dziesiątej, konkurencja wprost z GPT-6 Luna
Jeśli poprawa wydajności czyni Haiku 5.5 konkurencyjnym, to cena może być najważniejszym punktem tej premiery. Anthropic zaprojektował dwa poziomy cen API dla nowego modelu.

Dla żądań o długości podpowiedzi nieprzekraczającej 100 000 tokenów, ceny jednostkowe wejścia i wyjścia Haiku 5.5 są zarówno o 90% niższe niż w poprzedniej generacji. Powyżej tego progu cena jest nadal o 50% niższa niż Haiku 4.5.
Anthropic stwierdził, że około 90% żądań do poprzedniej generacji Haiku mieściło się w granicach 100 000 tokenów. Łącząc różne długości żądań i zmiany w zużyciu tokenów, firma szacuje, że Haiku 5.5 ukończy średni koszt podobnych zadań spada o około 75%.
Jest tu również łatwy do przeoczenia szczegół — Haiku 5.5 przeszedł na nowy Tokenizer. Zgodnie z oficjalną dokumentacją dla programistów, ten sam fragment tekstu może wygenerować około 30% więcej tokenów w nowym modelu niż w Haiku 4.5, przy czym konkretny wzrost zależy od treści. Dlatego spadek ceny jednostkowej API o 90% nie oznacza, że rachunek za każde zadanie można zmniejszyć o 90%.
Innym rywalem wartym uwagi jest GPT-6 Luna. Podstawowa cena OpenAI za Lunę wynosi również 0,1 USD za milion tokenów wejściowych i 0,5 USD za wyjściowe, a cena odczytu z pamięci podręcznej jest również zgodna z niskim poziomem cenowym Haiku 5.5.
Jednak istnieje wyraźna różnica między progami rozliczeniowymi dla długiego kontekstu obu firm.
Haiku 5.5 wchodzi w wyższy poziom cenowy po przekroczeniu 100 000 tokenów podpowiedzi; GPT-6 Luna uruchamia dopłaty za długi kontekst dopiero po przekroczeniu 272 000 tokenów wejściowych. Oznacza to, że dla żądań między 100 000 a 272 000 tokenów Luna ma przewagę w cenie jednostkowej tokena.
Co do tego, który model jest ostatecznie bardziej opłacalny w wykonaniu zadania, nadal należy oceniać na podstawie rzeczywistego zużycia tokenów, budżetu wnioskowania i wskaźnika sukcesu zadania.
Patrząc na cały rynek, Anthropic wywiera również presję na inne modele niskocenowe.
Ceny API za ten sam okres podane przez VentureBeat pokazują, że Google Gemini 3.5 Flash-Lite kosztuje 0,3 USD za milion tokenów wejściowych i 2,5 USD za wyjściowe; Gemini 3.8 Flash kosztuje odpowiednio 0,75 USD i 3,75 USD.
Oczywiście różne modele mają różne pozycjonowanie możliwości, strategie buforowania i wydajność zadań. Liczby te odzwierciedlają przede wszystkim konkurencję w cenach API.
Wojna cenowa wśród małych modeli jeszcze bardziej się zaostrza.
8 milionów wywołań tygodniowo, przedsiębiorstwa zaczynają zmuszać małe modele do pracy dla dużych modeli
Do czego dokładnie nadaje się Haiku 5.5?
Scenariusze podane przez Anthropic obejmują podsumowywanie dokumentów, klasyfikację informacji, zapytania do baz danych, kompresję kontekstu i służenie jako Subagent w złożonych przepływach pracy Agent.
Za tym stoi bardzo realistyczny problem: dzisiejsze Agenty stają się coraz bardziej złożone, a zadanie często wymaga wielu wywołań modeli. Jeśli każdy krok zostanie przekazany dużemu modelowi, koszty szybko się nagromadzą.
Firma finansowa AI Rogo podaje przykład. W jej przepływie pracy bardziej wydajny duży model odpowiada za tworzenie prezentacji finansowych. Podczas przetwarzania danego slajdu podagent Haiku 5.5 wchodzi do firmowego raportu rocznego 10-K, znajduje wymagane dane dotyczące przychodów z działalności, a następnie przekazuje wynik głównemu modelowi.
W przypadku tego rodzaju zadań model musi szybko i dokładnie wyszukiwać oraz wyodrębniać informacje. Rogo uważa, że Haiku 5.5 osiąga równowagę odpowiednią do wywołań na dużą skalę i wielokrotnych pod względem dokładności, szybkości i ceny.
Platforma do zarządzania treścią przedsiębiorstwa Box również podała wczesne wyniki testów. W porównaniu z Haiku 4.5 wewnętrzny wynik oceny Haiku 5.5 wzrósł o 11 punktów, a opóźnienie spadło o około 50%.
Box stwierdził, że czyni to nowy model odpowiednim do pracy analitycznej, która musi być uruchamiana na dużą skalę, takiej jak raporty kosztowe, podsumowania finansowe i przeglądy okresowe. Jednak Box nie ujawnił pełnych kryteriów oceny.
Testy Asany obejmowały zadania agentowe, takie jak klasyfikacja błędów, tworzenie projektów i wyszukiwanie w dużych portfelach projektów. Zgodnie z ujawnionymi wynikami, w porównaniu z obecnie używanym modelem, Haiku 5.5 skrócił opóźnienie ukończenia zadania o ponad 30% i zwiększył szybkość wnioskowania agenta w pojedynczej rundzie nawet 2,5-krotnie.
Kolejny przykład, który lepiej pokazuje wartość kosztową, pochodzi od AlphaSense. Funkcja Ask in Document tej firmy musi obsługiwać około 8 milionów wywołań tygodniowo, głównie odpowiadając na konkretne pytania dotyczące jednego lub kilku dokumentów.
Wśród 400 zapytań testowych wewnętrzny wynik oceny Haiku 5.5 osiągnął 0,84, podczas gdy Haiku 4.5 wyniósł 0,76.
Jeśli model jest wywoływany miliony razy tygodniowo, nawet jeśli za każdym razem oszczędza tylko niewielką kwotę, długoterminowa skumulowana zmiana kosztów może być znaczna.
Dane te pochodzą z wczesnych opinii klientów ujawnionych przez Anthropic. Konkretne obciążenia, modele porównawcze i standardy oceny nie są całkowicie spójne, a nadal potrzebne są bardziej niezależne testy.
Sonnet również obniża ceny, a rodzina Claude 5.5 zaczyna konkurować kosztami
Oprócz Haiku 5.5 Anthropic dostosował jednocześnie ceny Sonnet 5.5. Od 7 października opłata za odczyt pamięci podręcznej Sonnet 5.5 zostanie obniżona o 50%, z 0,2 USD za milion tokenów do 0,1 USD.
Anthropic szacuje, że ta korekta może dodatkowo obniżyć koszt większości obciążeń agentowych o około 20%, przy czym rzeczywista obniżka zależy od zakresu, w jakim aplikacje ponownie wykorzystują kontekst z pamięci podręcznej.
W przypadku agentów, które muszą wielokrotnie odczytywać długie historie rozmów, opisy narzędzi i kontekst zadania, koszty pamięci podręcznej bezpośrednio wpływają na długoterminowe koszty operacyjne systemu.
Anthropic uruchomił również miesięczne kredyty API dla subskrybentów Claude Max i Team: 100 USD dla użytkowników Max 5x, 200 USD dla użytkowników Max 20x i do 500 USD współdzielonych przez użytkowników Team.
Te kredyty mogą być wykorzystane na wywołania modeli na platformie Claude, zachęcając większą liczbę subskrybentów do wypróbowania budowania własnych agentów i aplikacji.
Po stronie deweloperów Haiku 5.5 jest już dostępny za pośrednictwem platform takich jak Anthropic API, Amazon Bedrock, Google Cloud i Microsoft Azure, z identyfikatorem modelu API claude-haiku-5-5.
Anthropic zaktualizował również zestawy SDK dla Pythona i TypeScript, dodając wsparcie dla obsługi przeglądarki i obsługi komputera w fazie Beta.
W tym momencie podział zadań produktowych w serii Claude 5.5 jest już dość jasny.
Opus 5.5 obsługuje zadania o wysokim stopniu trudności i złożonym rozumowaniu, Sonnet 5.5 obejmuje codzienną złożoną pracę i programowanie, a Haiku 5.5 koncentruje się na zadaniach o dużej liczbie wywołań, wrażliwych na koszty i wymagających szybkiej odpowiedzi.
Od 22 września do 7 października Anthropic potrzebował 15 dni, aby ukończyć tę rundę aktualizacji produktów, przy czym wszystkie trzy modele kładą nacisk na wydajność i efektywność kosztową.
Premiera Haiku 5.5 sprawia również, że jeden trend staje się bardziej oczywisty. Gdy agenci stopniowo przechodzą od demonstracji do praktycznych zastosowań, deweloperzy muszą brać pod uwagę koszty wywołań całego systemu. Które kroki w zadaniu wymagają silniejszego modelu, które można przekazać małemu modelowi i jak praca jest rozdzielana między różne modele – wszystko to wpłynie na ostateczną opłacalność komercyjną.
Dla Anthropic być może najbardziej atrakcyjna część Haiku 5.5 jest tutaj: sprawia, że więcej zadań, które pierwotnie trudno było skalować z powodu zbyt wysokich kosztów wywołań, zaczyna stawać się ekonomicznie opłacalnych.
Konkurencja wśród małych modeli zaczęła już przenikać do każdego ogniwa wykonawczego systemu agentowego.
Materiały referencyjne
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Ten artykuł pochodzi z publicznego konta WeChat „Machine Heart” (ID: almosthuman2014), redaktor: Spoon-billed Sandpiper