W skrócie
- Najlepsze modele Anthropic i OpenAI kosztują 100 razy więcej za token niż ich najmniejsze odpowiedniki, a mimo to wielu użytkowników domyślnie używa flagowego modelu do wszystkiego.
- Rankingi użycia w Meta, Amazon i Uber podniosły rachunki za AI, a Uber przepalił swój budżet na narzędzia AI na 2026 rok w ciągu około czterech miesięcy.
- Kierowanie zadań do odpowiedniego modelu, ograniczanie kontekstu, buforowanie i przetwarzanie wsadowe ostro obniżają koszty, ale istnieją też inne techniki oszczędzania pieniędzy.
Pracownicy Meta przepalili 60 bilionów tokenów AI w ciągu 30 dni na początku tego roku, walcząc o miejsca na wewnętrznym rankingu nazwanym „Claudeonomics”. Publicysta technologiczny Gergely Orosz oszacował rachunek na około 900 milionów dolarów według cennika Anthropic, choć Meta prawdopodobnie płaci znacznie mniej.
Konsultantka Bain & Company, Jue Wang, wszędzie widzi cichszą wersję tego marnotrawstwa: „Tak wiele firm, tak wielu użytkowników domyślnie używa Opus do wszystkiego, w tym do generowania e-maili” – powiedziała Associated Press tego lata, odnosząc się do modeli wysokiej klasy Anthropic. Jeśli robisz to samo, zatrudniasz Alberta Einsteina, żeby obliczył ci resztę w MacDonald’s.
Każde słowo, które wpisujesz w ChatGPT lub Claude, i każde słowo, które one odpisują, jest liczone w tokenach, fragmentach tekstu o średniej długości około trzech czwartych słowa. W subskrypcji za 20 dolarów ten licznik decyduje o tym, jak szybko osiągniesz limit użycia. W API, czyli w dostępie rozliczanym za token, którego programiści używają do podłączania modeli do własnych aplikacji, decyduje o rachunku.
Oto aktualny cennik Anthropic, za milion tokenów:
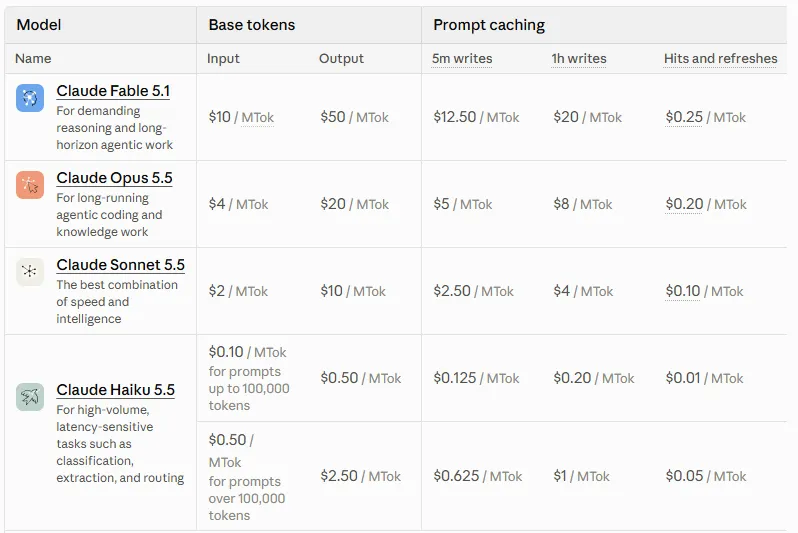
Stawka Haiku dotyczy promptów poniżej 100 000 tokenów; dłuższe prompty kosztują pięć razy więcej.
Najlepszy model kosztuje 100 razy więcej niż najmniejszy, a własna oferta OpenAI ma ten sam rozrzut, od 10 do 0,10 dolara za milion tokenów wejściowych. Te ceny za token szybko się sumują dla laboratoriów — i dla ciebie: wskaźnik przychodów Anthropic wzrósł z około 9 miliardów dolarów pod koniec 2025 roku do ponad 47 miliardów dolarów do maja, podczas gdy OpenAI walczy w wojnie cenowej, aby dotrzymać kroku.
Kilka nawyków znacznie zmniejsza te wydatki, a pierwsze pięć wskazówek poniżej nie wymaga żadnego kodowania.
Co oznacza tokenmaxxing (i co powinien oznaczać)
Tokenmaxxing zaczął się jako popis z Doliny Krzemowej, jak Claudeonomics Meta, gdzie Microsoft, Shopify i Amazon rankingują pracowników na podobnych tabelach liderów tokenów. Dyrektor generalny Nvidii, Jensen Huang, dolał oliwy do ognia, gdy powiedział w marcu w podcaście „All-In”, że byłby „głęboko zaniepokojony”, gdyby inżynier za 500 000 dolarów nie spalił tokenów o wartości co najmniej 250 000 dolarów.
I palili tokeny… na głupie, nieproduktywne rzeczy.
W Amazonii pracownicy przyznali się do zawyżania swoich liczb, uruchamiając wewnętrzne narzędzie AI do nieistotnych zadań, dopóki starszy wiceprezes nie powiedział pracownikom: „Proszę nie używać AI tylko po to, żeby używać AI”.
Ten przewodnik używa znaczenia, które inżynierowie propagują obecnie: maksymalizowanie wartości każdego tokena, a nie liczby, którą wydajesz.
Trzy koncepcje wyjaśniają, gdzie trafiają tokeny, począwszy od pętli agenta. Agent to model, który potrafi używać narzędzi, więc myśli, przeszukuje sieć lub uruchamia kod, odczytuje wynik i robi to ponownie, aż uzna, że skończył, wysyłając całą rozmowę na nowo przy każdym obiegu.
Orkiestracja mnoży ten koszt: jeden model działa jako menedżer, dzieląc twoje żądanie na części, przekazując je modelom roboczym zwanym podagentami i łącząc ich odpowiedzi z powrotem. Każdy pracownik prowadzi własną pętlę z własną pamięcią, dlatego Anthropic twierdzi, że zespoły agentów w Claude Code mogą zużywać około siedem razy więcej tokenów niż standardowa sesja, gdy współpracownicy działają w trybie planowania, ustawieniu omówionym w poniższych wskazówkach średniozaawansowanych.
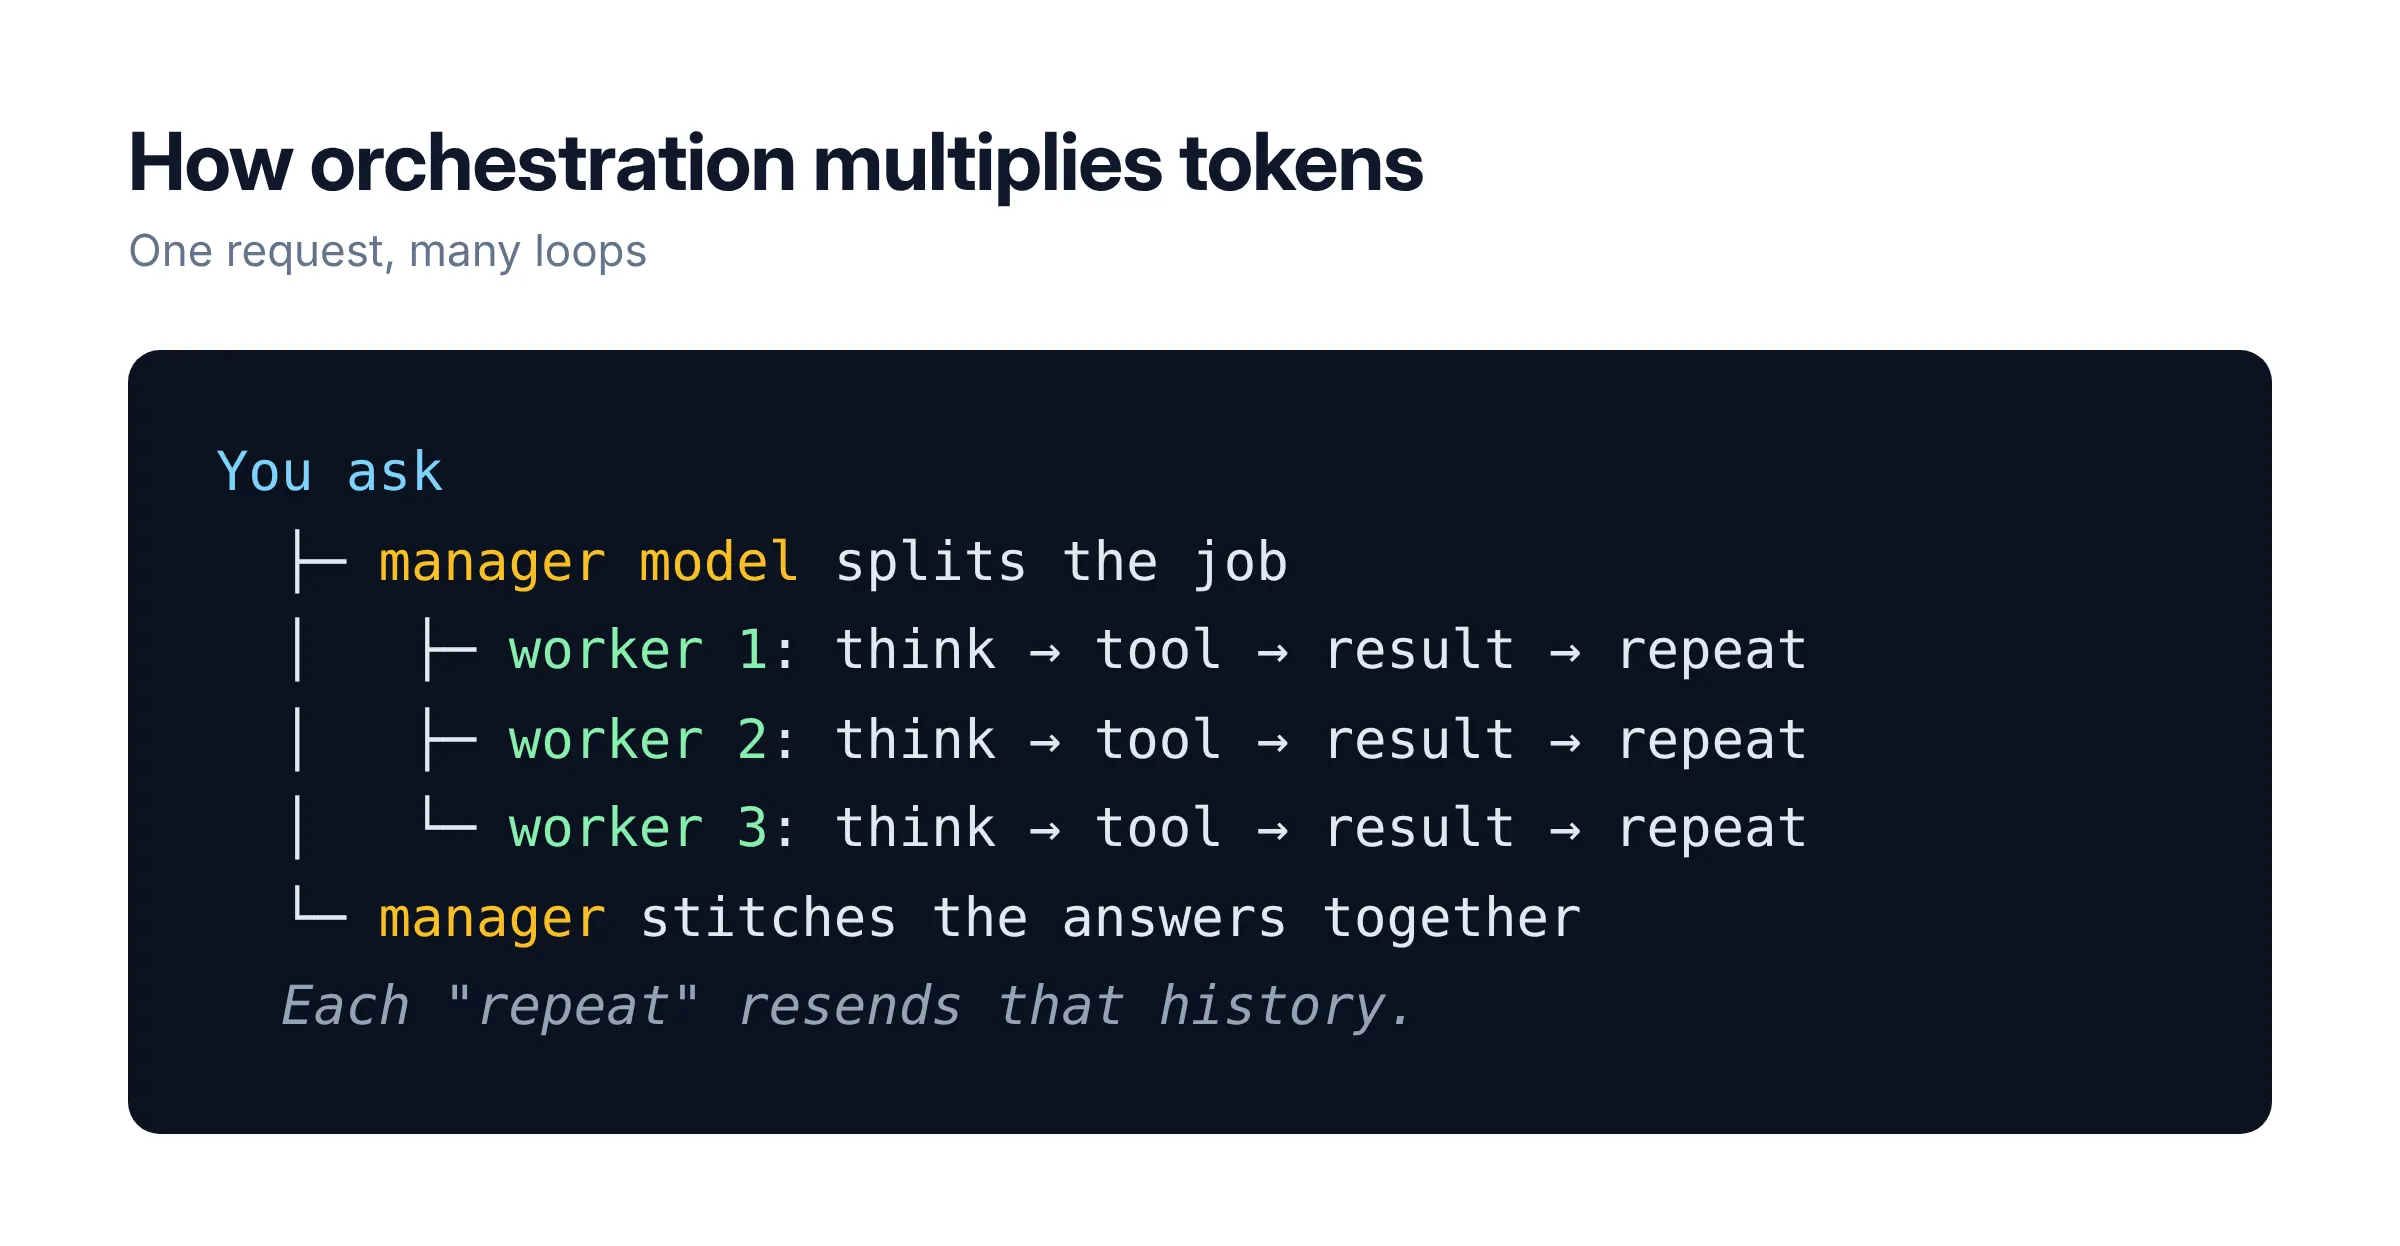
Grafy to sposób, w jaki programiści powstrzymują te pętle przed zbaczaniem z kursu. Frameworki takie jak LangGraph pozwalają narysować przepływ pracy jak mapę metra, ze stacjami (węzłami) wykonującymi pracę i torami (krawędziami) decydującymi, dokąd iść dalej, dzięki czemu model podąża ustaloną trasą, zamiast zapętlać się, aż skończą mu się pomysły lub budżet.
Innymi słowy, pętle pomagają automatyzować zadania i zwiększać jakość, ale wydasz też dużo pieniędzy, więc niezwykle ważne jest, aby być wydajnym. Oto kilka wskazówek, które mogą ci w tym pomóc
Dla początkujących: małe zadania, małe modele
1. Wybierz model odpowiedni do zadania
Jeśli dopiero zaczynasz, prawdopodobnie używasz interfejsu graficznego do uruchamiania swojej sztucznej inteligencji.
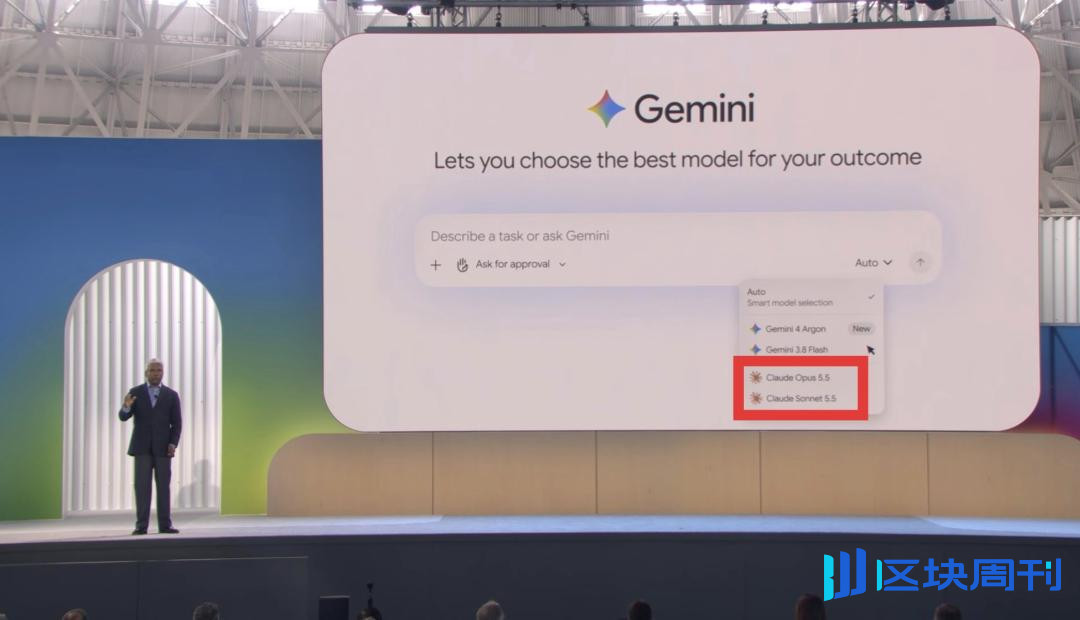
Kliknij nazwę modelu w swojej aplikacji do czatu (na górze czatu w ChatGPT, obok przycisku wysyłania w Claude lub Hermes) i przełącz się na mniejszą, szybszą opcję do e-maili, podsumowań i przeformułowań. Zachowaj najlepszy model do trudnego rozumowania i decyzji, w których subtelny błąd kosztuje prawdziwe pieniądze.
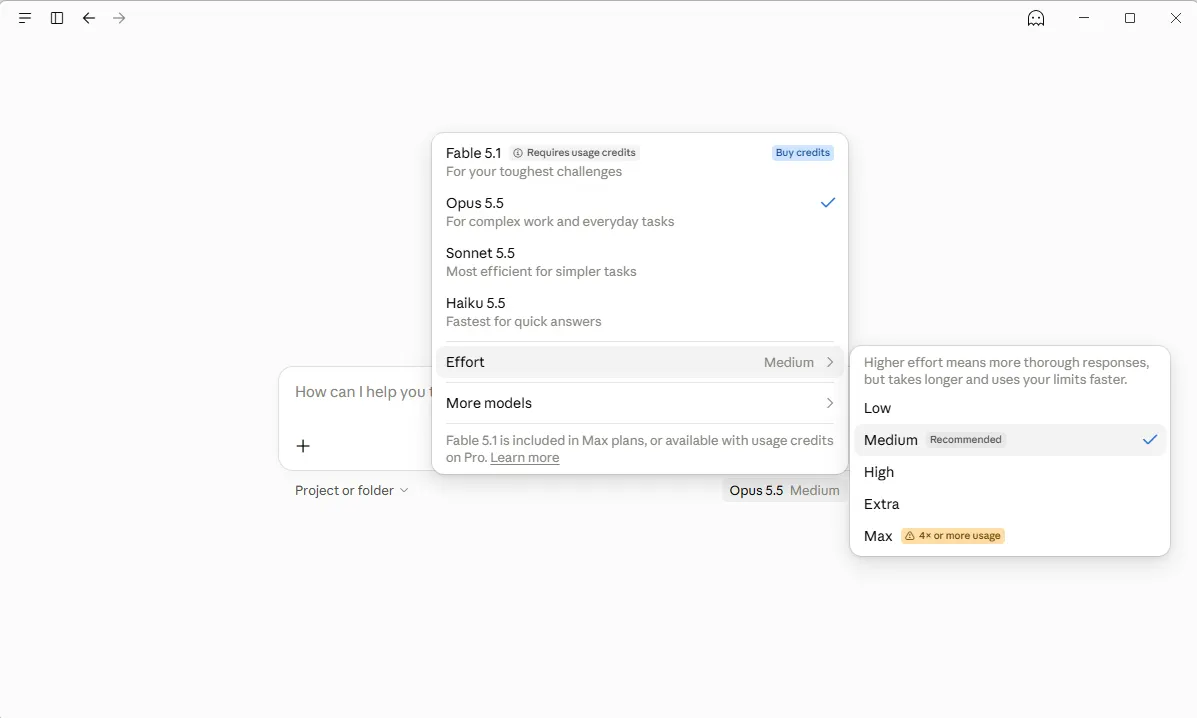
Uruchom pięć zadań z zeszłego tygodnia na obu modelach równolegle, a jeśli mały model sobie poradzi, zachowaj go. W przypadku subskrypcji, która wyczerpuje limit użycia, oraz w API obniża rachunek nawet o 99%.
2. Napisz jeden dobry prompt zamiast pięciu złych
Trzy rundy „nie, tylko suma” lub „popraw to i uczyń bardziej dokładnym” za każdym razem wysyłają cały czat ponownie. Jeden jasny prompt określa zadanie i dokładny kształt odpowiedzi. Coś takiego mogłoby zadziałać:
Wyodrębnij numer faktury, datę, sprzedawcę i sumę z poniższego tekstu. Zachowaj każdą wartość dokładnie tak, jak została zapisana. Zwróć jedną linię na pole i wpisz „brak”, jeśli pole nie występuje.
Wewnętrzne testy OpenAI wykazały, że prostsze, jaśniejsze polecenia uzyskiwały wyższe wyniki przy zużyciu mniejszej liczby tokenów.
3. Rozpocznij nowy czat, gdy zmieniasz temat
Model ponownie odczytuje całą rozmowę za każdym razem, gdy naciśniesz wyślij, więc wątek liczący 50 wiadomości o twoich wakacjach sprawia, że twoje pytanie podatkowe staje się jednocześnie droższe i głupsze.
Anthropic nazywa to zjawisko „gniciem kontekstu.”
Więc, na litość boską, rozpoczynaj nowy czat za każdym razem, gdy zmienia się temat.
4. Proś o rozmiar, którego potrzebujesz
Tokeny wyjściowe kosztują pięć razy więcej niż wejściowe w najlepszych modelach Anthropic i OpenAI. Zakończ swoje polecenia czymś w rodzaju „trzy punkty, poniżej 100 słów” lub „tylko zmienione linie”, a model będzie miał mniej miejsca na wypełniacze.
Jeśli model ma ograniczenie dotyczące długości wyjścia, będzie oszczędzał tokeny, zwłaszcza jeśli zadanie jest twórcze (jak pisanie lub badanie) i nie jest deterministyczne (jak kodowanie lub rozwiązywanie zadań matematycznych).
5. Wypróbuj za darmo, zanim zapłacisz
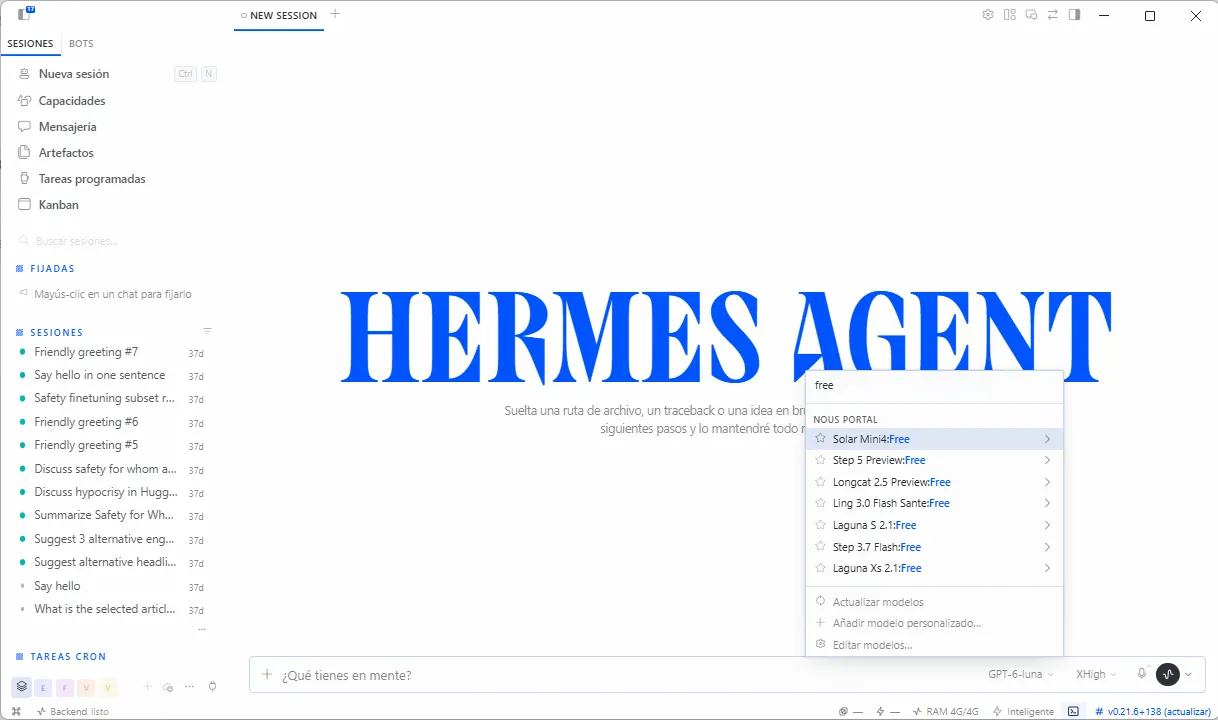
OpenRouter, strona, która łączy się z setkami modeli AI przez jedno konto, ma darmowy router, który wysyła twoje zapytanie do jednego z około 20 bezpłatnych modeli. Możesz także uruchamiać modele lokalnie za pomocą LM Studio lub Ollama na karcie graficznej z 8 GB pamięci wideo lub na komputerze Apple z serii M.
Darmowe plany mogą zniknąć z dnia na dzień, więc nie buduj na nich niczego ważnego i przeczytaj politykę danych, zanim wkleisz cokolwiek wrażliwego.
To powiedziawszy, możesz zmaksymalizować liczbę iteracji, korzystając z darmowych ofert. Hermes ma dobry wybór darmowych modeli, które mogą wykonać potrzebną ci pracę, podobnie jak Nvidia. Lepiej dostosować polecenie za pomocą darmowego, głupszego modelu niż płacić za model premium, który zrobi to samo, ale szybciej.
Dodatkowe wskazówki dla początkujących
Pomiń rozszerzone myślenie w przypadku prostych pytań lub obniż ustawienie wysiłku w nowszych modelach Claude, w których nie można wyłączyć myślenia. Anthropic rozlicza cały proces myślowy jako dane wyjściowe, w tym tę część, której nigdy nie widzisz.
Subskrybenci Claude Pro i Max, którzy włączą kredyty za użytkowanie, mogą ustawić miesięczny limit wydatków w sekcji Ustawienia, a następnie Użytkowanie.
Poziom średniozaawansowany: twój agent czyta zdecydowanie za dużo
Od tego miejsca przykłady wykorzystują Claude Code, agenta Anthropic, który działa w twoim terminalu i edytuje pliki za ciebie; polecenia wpisuje się bezpośrednio w jego okno czatu. Inne środowiska będą miały podobną logikę.
Jeśli używasz tylko aplikacji do czatu, wskazówka 8 również działa w każdym oknie czatu.
6. Zaczynaj tanio, eskaluj w razie niepowodzenia
Wpisz /model, aby przełączać modele, pozostaw Sonnet jako domyślny i przejdź na Opus tylko wtedy, gdy Sonnet zawiedzie w czymś konkretnym, na przykład w przypadku błędu, którego nie potrafi naprawić po dwóch próbach. W przypadku prostych zadań podagenta dokumentacja Anthropic sugeruje ustawienie model: haiku w ustawieniach podagenta.
7. Czyść między zadaniami
Wpisz /clear, gdy przechodzisz do niepowiązanego zadania, co nic nie kosztuje i usuwa starą historię. Użyj /compact z notatką o tym, co zachować, na przykład /compact zachowaj decyzje dotyczące bazy danych, tylko gdy potrzebujesz historii, ponieważ kompaktowanie samo w sobie jest dużym żądaniem.
8. Pozwól kodowi wykonywać nudną matematykę
Wklejenie arkusza kalkulacyjnego z 5000 wierszy do czatu sprawia, że model czyta każdy wiersz, a mimo to może się pomylić w liczeniu, ponieważ model językowy nie jest kalkulatorem, niezależnie od tego, ile za niego płacisz.
Zamiast tego poproś go o formułę lub krótki skrypt, uruchom go samodzielnie i przekaż modelowi tylko wynik.
9. Ogranicz swoje narzędzia
Serwery MCP to wtyczki, które łączą model z aplikacjami takimi jak GitHub czy Google Drive, a każdy z nich dodaje nazwy narzędzi i instrukcje do każdej sesji.
Wpisz /context, aby zobaczyć, co zajmuje miejsce, oraz /mcp, aby wyłączyć serwery, których projekt nie używa.
Dodatkowe wskazówki średniozaawansowane
Wpisz /usage, aby zobaczyć, gdzie poszły twoje tokeny. Utrzymuj swój CLAUDE.md (lub Soul.md), plik instrukcji, który twój agent czyta na początku każdej sesji, poniżej 200 linii.
W przypadku większych zmian naciśnij Shift+Tab, aby przełączyć się w tryb planowania, w którym agent proponuje plan do zatwierdzenia, zanim dotknie plików, i naciśnij Esc w momencie, gdy pójdzie w złym kierunku. Użyj /effort, aby zmniejszyć rozumowanie w przypadku prostych zadań, takich jak zmiana nazwy zmiennej.
Anthropic pokazał, że użycie tokenów przez agenta spadło z 150 000 tokenów do 2000, gdy ładował tylko potrzebne definicje narzędzi, więc narzędzia wiersza poleceń, takie jak gh GitHuba, które nic nie kosztują, dopóki nie zostaną uruchomione, często biją stale włączoną wtyczkę.
Zaawansowane: wbuduj zabezpieczenia w system
Weźmy dewelopera, który musi przetworzyć 1000 faktur po 2000 tokenów każda, z odpowiedziami po 200 tokenów: to zadanie kosztuje około 30 dolarów na Fable 5.1 i około 0,30 dolara na Haiku 5.5, przed zastosowaniem któregokolwiek z poniższych trików.
10. Buforuj części, które nigdy się nie zmieniają
Umieść stałe instrukcje na początku, a zmieniające się części na końcu, i oznacz stały blok do buforowania. W API Anthropic to jedno dodatkowe pole:
"system": [{
"type": "text",
"text": "Twoje instrukcje dotyczące faktur...",
"cache_control": {"type": "ephemeral"}
}]
Odczyt z pamięci podręcznej kosztuje ułamek normalnej ceny wejściowej, natomiast zapis do domyślnej pięciominutowej pamięci podręcznej kosztuje dodatkowo. Sprawdzaj pole cache_read_input_tokens w każdej odpowiedzi; jeśli po pierwszym wywołaniu nadal wynosi zero, pamięć podręczna nie działa.
11. Wsadzaj do partii wszystko, co może poczekać
Zarówno OpenAI, jak i Anthropic przetwarzają zadania wsadowe z 50% zniżką, przy czym OpenAI obiecuje wyniki w ciągu 24 godzin. Prześlij 1000 faktur jako jeden plik wsadowy zamiast wykonywać 1000 wywołań na żywo, a rachunek znacznie spadnie.
12. Trzymaj agentów na smyczy
Ustaw maksymalną liczbę kroków i limit dolarowy dla każdego uruchomienia agenta oraz zdefiniuj, jak wygląda "gotowe", zanim się zacznie. Claude Code akceptuje flagę --max-budget-usd dla uruchomień skryptowych, a Shopify używa wyłączników awaryjnych, które mogą natychmiast odciąć dostęp dewelopera, jeśli jego wydatki gwałtownie wzrosną w ciągu dnia, zaprojektowanych do wychwytywania wymykających się spod kontroli agentów.
Obecnie normalną rzeczą jest faktyczne uwolnienie tych agentów i pozwolenie im działać w pętli, aż wynik zostanie uznany za doskonały. Jeśli nie masz pieniędzy, nie pozwalaj po prostu swoim agentom decydować, co jest, a co nie jest "doskonałe".
Dodatkowe zaawansowane wskazówki
Umieszczaj kluczowe fakty na początku lub na końcu długiego promptu. Badanie prowadzone przez Stanford wykazało, że modele najlepiej wykorzystują informacje w tych pozycjach, a najgorzej, gdy są zakopane w środku.
Płać za drugi model do sprawdzania pracy tylko wtedy, gdy błąd jest kosztowny, na przykład klauzula umowy lub kwota płatności. W API OpenAI włącz twardy limit wydatków dla każdego projektu, ponieważ jego alerty wydatków tylko powiadamiają i nie zatrzymują ruchu.
Zacznij od jednego testu
Ustaw najtańszy model, który przechodzi twój pięciozadaniowy test z porady 1, jako domyślny na tydzień i zmieniaj go tylko wtedy, gdy zawiedzie. Następnie porównaj swoją stronę zużycia z poprzednim tygodniem; w przypadku zadania z fakturami samo routowanie obniżyło rachunek z 30 do 3,90 dolara, nawet po zapłaceniu Opus 5.5 za ponowne wykonanie 300 nieudanych prób.
Tańsze tokeny same jednak nie załatwią sprawy: cena pojedynczego tokena spadła o ponad 90% od 2023 roku, według Token Expenditure Index firmy Silicon Data, a mimo to wydatki na duże modele językowe podwoiły się od końca 2025 roku.
Ekonomiści nazywają to paradoksem Jevonsa, gdy zasób staje się tak tani, że ludzie w sumie wydają na niego więcej. Brief Bain & Co. z czerwca wykazał ten sam wzorzec, przy czym koszty tokenów spadły o połowę między grudniem 2024 a 2025 rokiem, podczas gdy liczba zużywanych tokenów wzrosła o 450%.
Zaletą jest to, że te same spadające ceny działają na twoją korzyść w momencie, gdy przestajesz palić tokeny dla zabawy: połącz je z powyższymi nawykami, a AI stanie się jednocześnie tańsza i lepsza.