Товариші, Anthropic знову знижує ціни. Цього разу це найдешевша модель у сімействі Claude — Haiku.
7 жовтня Anthropic офіційно випустила Claude Haiku 5.5, заявивши, що це її найшвидша, найздібніша та найдешевша мала модель на сьогодні.
Найбільш вражаюча частина — це ціна, всього $0,1 за мільйон вхідних токенів, що є прямим зниженням ціни на 90% порівняно з попереднім поколінням.
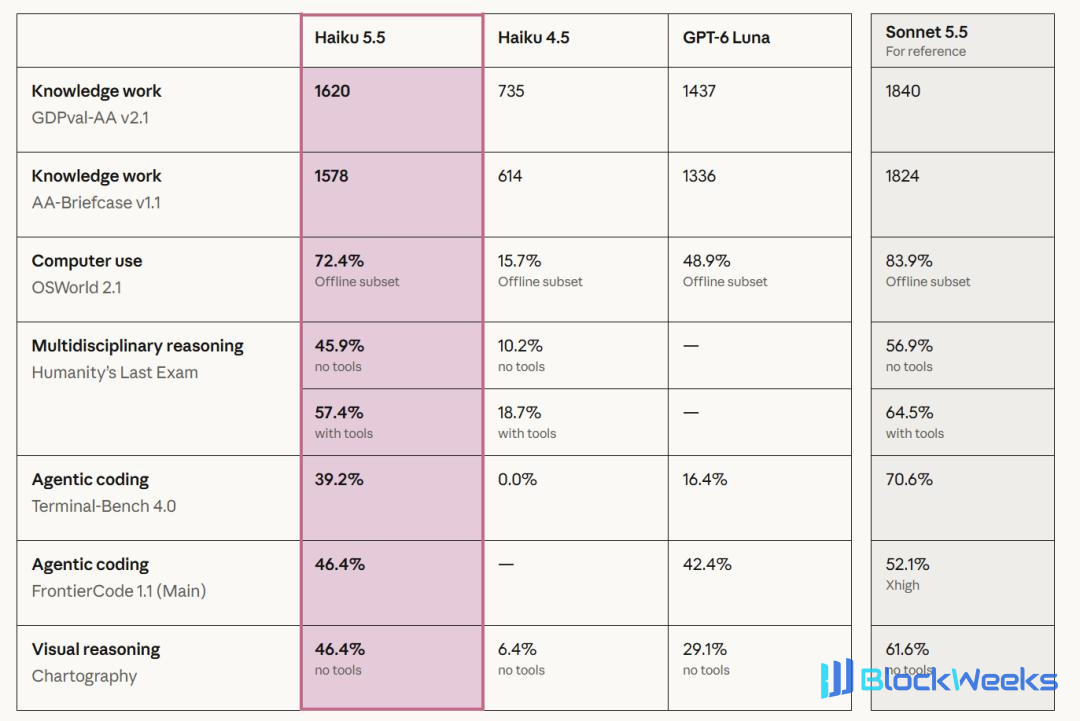
Продуктивність також не відстає. Згідно з результатами тестів, опублікованими Anthropic, Haiku 5.5 перевершує GPT-6 Luna від OpenAI за кількома бенчмарками, включаючи роботу з комп'ютером, інтелектуальну роботу та програмування агентів, причому деякі оцінки демонструють значний розрив.
Більше того, Haiku 5.5 також представляє регульовану інтенсивність міркування, підтримуючи контекстне вікно на 1 мільйон токенів і вихід до 128 000 токенів.
На цей момент Anthropic завершила оновлення всього сімейства Claude 5.5 лише за 15 днів: Opus 5.5 з'явився 22 вересня, Sonnet 5.5 було випущено 28 вересня, а тепер офіційно приєднався Haiku 5.5.
Цього разу Anthropic зосередилася на тих завданнях ШІ з величезними обсягами викликів і надзвичайною чутливістю до ціни.
Кілька оцінок перевершують GPT-6 Luna, успішність роботи з комп'ютером 72,4%
Згідно з оцінками Benchmark, опублікованими Anthropic, Haiku 5.5 досягла значного покращення порівняно з попереднім поколінням, а в деяких тестах навіть досягла кращих результатів, ніж GPT-6 Luna.
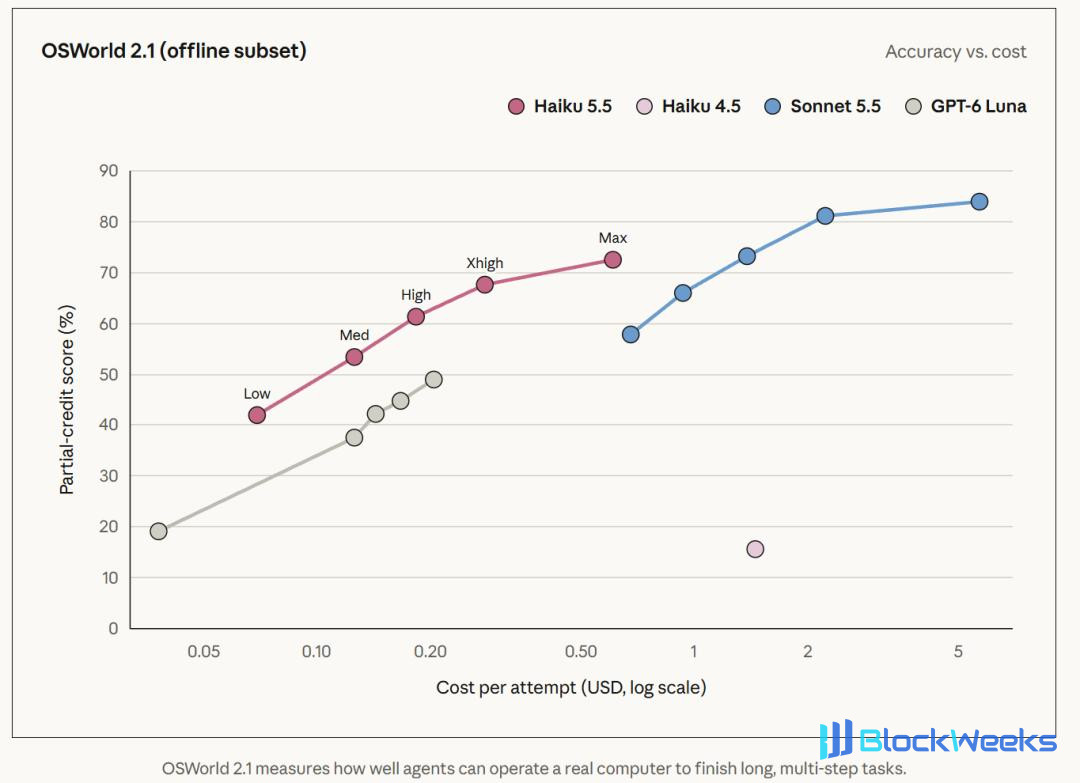
Найпомітніший результат походить від OSWorld. Це тест, який вимірює здатність ШІ-агента керувати справжнім комп'ютером, вимагаючи від моделі виконувати міжпрограмні, багатокрокові операційні завдання.
На офлайн-підмножині завдань OSWorld 2.1 Haiku 5.5 досягла 72,4% успішності, тоді як попереднє покоління Haiku 4.5 мало лише 15,7%, а GPT-6 Luna — 48,9%.
Щодо інтелектуальної роботи, Haiku 5.5 набрала 1620 балів у GDPval-AA v2.1, перевершивши 1437 балів GPT-6 Luna. У тесті програмування агентів Terminal-Bench 4.0 обидві набрали 39,2% та 16,4% відповідно.
Однак у цих даних є важлива деталь. Найвищі оцінки Benchmark Haiku 5.5 часто вимагають більших обчислень для міркування.
Haiku 5.5 вперше в серії Haiku представляє регульовану інтенсивність міркування, дозволяючи розробникам контролювати, скільки обчислювальних ресурсів модель інвестує через параметр effort.
Медіа-видання VentureBeat помітило, що в тесті Terminal-Bench, опублікованому Anthropic, оцінка 39,2% відповідає максимальній інтенсивності міркування. Після перемикання на середню інтенсивність міркування оцінка падає приблизно до 20%, а середня інтенсивність є саме налаштуванням за замовчуванням для Haiku 5.5.
Стороння оцінювальна агенція Artificial Analysis також спостерігала подібне явище. У своїй оцінці Intelligence Index Haiku 5.5 набрала 43 бали при максимальній інтенсивності міркування та 34 бали при середній інтенсивності міркування. За однакової оцінки середня вартість за завдання становила близько $0,21 та $0,05 відповідно.
Іншими словами, модель може обміняти збільшений бюджет на міркування на кращу продуктивність виконання завдань, але фактична вартість також може значно зрости.
У власному тесті Terminal-Bench 4.0 компанія Artificial Analysis виміряла оцінки 33% при максимальній інтенсивності міркування та 15% при середній інтенсивності. Через різні налаштування оцінювання ці цифри відрізняються від офіційних результатів Anthropic.
Саме тому, дивлячись на продуктивність малої моделі, потрібно одночасно враховувати інтенсивність міркування, відсоток завершення завдань і фактичну вартість.
На складніших завданнях програмування агентів Sonnet 5.5 все ще має явну перевагу: його оцінка в Terminal-Bench 4.0 сягає 70,6%.
Anthropic також чітко заявила, що Sonnet і Opus все ще краще підходять для складних завдань програмування агентів, тоді як переваги Haiku зосереджені на високочастотній роботі з чітко визначеними межами.
Ціну одразу знижено до однієї десятої, пряма конкуренція з GPT-6 Luna
Якщо покращення продуктивності роблять Haiku 5.5 конкурентоспроможним, то ціна може бути найважливішою особливістю цього релізу. Anthropic розробила два рівні ціноутворення API для нової моделі.

Для запитів із довжиною підказки, що не перевищує 100 000 токенів, ціни за одиницю введення та виведення Haiku 5.5 обидві на 90% нижчі, ніж у попереднього покоління. Понад цей поріг ціна все ще на 50% нижча, ніж у Haiku 4.5.
Anthropic заявила, що близько 90% запитів до попереднього покоління Haiku були в межах 100 000 токенів. Поєднуючи різну довжину запитів і зміни у споживанні токенів, компанія оцінює, що Haiku 5.5 виконує середня вартість подібних завдань знижується приблизно на 75%.
Тут також є легко помітна деталь — Haiku 5.5 перейшов на новий Tokenizer. Згідно з офіційною документацією для розробників, той самий фрагмент тексту може генерувати приблизно на 30% більше токенів у новій моделі, ніж у Haiku 4.5, причому конкретне збільшення залежить від вмісту. Тому падіння ціни за одиницю API на 90% не означає, що рахунок за кожне завдання можна зменшити на 90%.
Ще один конкурент, вартий уваги, — GPT-6 Luna. Базова ціна OpenAI для Luna також становить $0,1 за мільйон вхідних токенів і $0,5 за вихідні, а ціна читання з кешу також узгоджується з низькоціновим рівнем Haiku 5.5.
Однак між порогами білінгу за довгий контекст у двох компаній є чітка різниця.
Haiku 5.5 переходить на вищий ціновий рівень після того, як підказки перевищують 100 000 токенів; GPT-6 Luna стягує доплату за довгий контекст лише після того, як введення перевищує 272 000 токенів. Це означає, що для запитів від 100 000 до 272 000 токенів Luna має перевагу в ціні за одиницю токена.
Щодо того, яка модель зрештою є більш економічно вигідною для виконання завдання, це все ще потрібно оцінювати на основі фактичного використання токенів, бюджету на висновок і відсотка успішності завдань.
Дивлячись на весь ринок, Anthropic також чинить тиск на інші низькоцінові моделі.
Ціни API за той самий період, наведені VentureBeat, показують, що Google Gemini 3.5 Flash-Lite коштує $0,3 за мільйон вхідних токенів і $2,5 за вихідні; Gemini 3.8 Flash коштує $0,75 і $3,75 відповідно.
Звісно, різні моделі мають різне позиціонування можливостей, стратегії кешування та продуктивність виконання завдань. Ці цифри насамперед відображають конкуренцію в ціноутворенні API.
Цінова війна серед малих моделей ще більше загострюється.
8 мільйонів викликів на тиждень, підприємства починають змушувати малі моделі працювати на великі моделі
Для чого саме підходить Haiku 5.5?
Сценарії, наведені Anthropic, включають узагальнення документів, класифікацію інформації, запити до бази даних, стиснення контексту та виконання ролі субагента в складних робочих процесах агентів.
За цим стоїть дуже реалістична проблема: сьогоднішні агенти стають дедалі складнішими, і завдання часто вимагає кількох викликів моделі. Якщо кожен крок передавати великій моделі, витрати швидко накопичуватимуться.
Фінансова AI-компанія Rogo наводить приклад. У її робочому процесі потужніша велика модель відповідає за створення фінансових презентаційних матеріалів. Під час обробки певного слайда субагент Haiku 5.5 входить у річний звіт підприємства за формою 10-K, знаходить потрібні дані про дохід від бізнесу, а потім передає результат головній моделі.
Для такого типу завдань модель повинна швидко й точно виконувати пошук та вилучення інформації. Rogo вважає, що Haiku 5.5 досягає балансу, придатного для великомасштабних повторюваних викликів, між точністю, швидкістю та ціною.
Платформа управління корпоративним контентом Box також надала попередні результати тестування. Порівняно з Haiku 4.5, внутрішня оцінка Haiku 5.5 зросла на 11 балів, а затримка знизилася приблизно на 50%.
Box заявила, що це робить нову модель придатною для аналітичної роботи, яку потрібно запускати в масштабі, наприклад для звітів про витрати, фінансових підсумків і періодичних оглядів. Однак Box не розкрила повні критерії оцінювання.
Тести Asana охоплювали завдання агента, такі як класифікація помилок, створення проєктів і пошук у великих портфелях проєктів. Згідно з оприлюдненими нею результатами, порівняно з моделлю, яка використовується зараз, Haiku 5.5 скоротила затримку завершення завдань більш ніж на 30% і підвищила швидкість однокругового висновку агента до 2,5 раза.
Ще один приклад, який краще демонструє цінність витрат, походить від AlphaSense. Функція цієї компанії Ask in Document потребує обробки близько 8 мільйонів викликів на тиждень, переважно відповідаючи на конкретні запитання щодо одного або кількох документів.
Серед 400 тестових запитів внутрішня оцінка Haiku 5.5 досягла 0,84, тоді як Haiku 4.5 — 0,76.
Якщо модель викликається мільйони разів на тиждень, навіть якщо вона заощаджує лише невелику суму щоразу, довгострокова накопичена зміна витрат може бути значною.
Ці дані походять із раннього відгуку клієнтів, оприлюдненого Anthropic. Конкретні робочі навантаження, моделі порівняння та стандарти оцінювання не є повністю узгодженими, і все ще потрібне більше незалежного тестування.
Sonnet також знижує ціни, і сімейство Claude 5.5 починає конкурувати за витратами
Окрім Haiku 5.5, Anthropic також одночасно скоригувала ціноутворення Sonnet 5.5. Починаючи з 7 жовтня, плата за читання кешу Sonnet 5.5 буде знижена на 50%, з $0,2 за мільйон токенів до $0,1.
Anthropic оцінює, що це коригування може додатково знизити витрати більшості робочих навантажень агента приблизно на 20%, причому фактичне зниження залежить від того, наскільки застосунки повторно використовують кешований контекст.
Для агентів, яким потрібно багаторазово читати довгі історії розмов, описи інструментів і контекст завдань, витрати на кеш безпосередньо впливають на довгострокові операційні витрати системи.
Anthropic також запустила щомісячні API-кредити для підписників Claude Max і Team: $100 для користувачів Max 5x, $200 для користувачів Max 20x і до $500 спільно для користувачів Team.
Ці кредити можна використовувати для викликів моделей на платформі Claude, заохочуючи більше підписників спробувати створювати власних агентів і застосунки.
На боці розробників Haiku 5.5 уже доступна через такі платформи, як Anthropic API, Amazon Bedrock, Google Cloud і Microsoft Azure, з ідентифікатором API-моделі claude-haiku-5-5.
Anthropic також оновила SDK для Python і TypeScript, додавши підтримку роботи з браузером і комп'ютером на етапі Beta.
На цей момент розподіл праці між продуктами серії Claude 5.5 уже досить чіткий.
Opus 5.5 обробляє високоскладні завдання складного міркування, Sonnet 5.5 охоплює щоденну складну роботу та програмування, а Haiku 5.5 зосереджується на завданнях із великим обсягом викликів, чутливістю до витрат і вимогами до швидкої відповіді.
З 22 вересня по 7 жовтня Anthropic витратила 15 днів, щоб завершити цей раунд оновлень продуктів, причому всі три моделі наголошують на продуктивності та економічній ефективності.
Випуск Haiku 5.5 також робить одну тенденцію більш очевидною. Оскільки агенти поступово переходять від демонстрацій до практичних застосувань, розробники повинні враховувати витрати на виклики всієї системи. Які кроки в завданні потребують потужнішої моделі, які можна передати малій моделі та як розподіляється робота між різними моделями — усе це впливатиме на кінцеву комерційну життєздатність.
Для Anthropic, можливо, найпривабливіша частина Haiku 5.5 саме тут: вона робить більше завдань, які спочатку було важко масштабувати через надто високі витрати на виклики, економічно життєздатними.
Конкуренція між малими моделями вже почала проникати в кожну ланку виконання системи агента.
Довідкові матеріали
https://www.anthropic.com/claude-haiku-5-5
https://venturebeat.com/technology/anthropic-launches-claude-haiku-5-5-with-90-api-price-reduction-matching-gpt-6-luna
https://x.com/claudeai/status/2107894042235166750
Ця стаття походить із публічного акаунта WeChat «Machine Heart» (ID: almosthuman2014), редактор: Spoon-billed Sandpiper