
Claude Code約90%的自身程式碼,已經交給Claude編寫。
寫程式碼的換成了AI,改動數量也跟著暴漲:6月到9月,合併進程式碼庫的PR數量,翻了一倍多。
放眼整個Anthropic,主程式碼庫每天合併的改動,從5月約2500次,漲到9月超過3萬次。
這麼多程式碼,人還讀得過來嗎?如果連審查也交給AI,誰來判斷它有沒有犯錯?
10月15日,Claude Code團隊公開了內部程式碼審查流程,披露在PR數量翻倍的同時,需要回滾的PR佔比,反而相對下降超過40%。
做到這一點,他們靠的是六層檢查,加上一套快速發現、快速回滾的兜底機制。
Claude Code團隊的判斷是:
在這個體量下,逐行人審已經不現實。
但他們並沒有取消審查,而是把大部分讀程式碼的活兒,交給了機器。
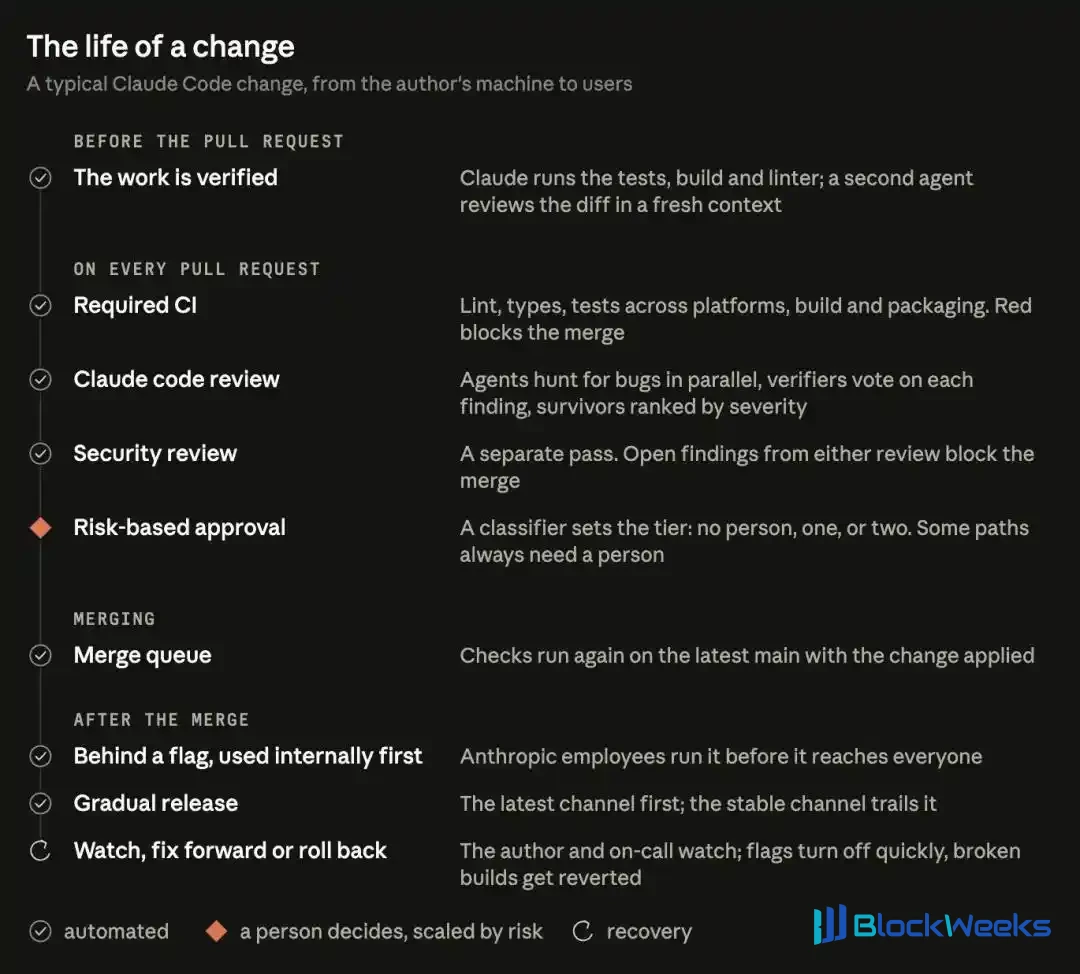
一段AI寫的程式碼,上線前要先跑測試、接受AI和安全審查,再按風險決定是否需要人來批准。
在Claude Code團隊看來,「有沒有人讀過這段程式碼」是個不夠精確的問題。
真正的問題應該是:
這次改動可能出什麼錯,如果出錯應該由哪一道檢查阻攔?
人工審查之前 ,AI先拿出驗證結果
一次改動,要過六道檢查,最後還有一張安全網。
第一關,在建立合併請求(PR)之前。
Claude要跑測試、完成建置;涉及介面的改動,還要截圖對照設計稿。
接著,再派一個使用全新上下文的子智慧體審查程式碼差異,它沒參與寫程式碼,專門挑刺。
官方的要求很明確:
Claude要把執行的命令和輸出擺出來,光回覆一句「測試全部通過」不算數。
普通開發者也能照著做:給AI任務時,把怎麼驗收一起說清楚。
第二關,才是PR上的AI審查。
幾個智慧體並行找bug,另一組再投票核驗。票數夠了,問題才會貼到PR上。
只涉及程式碼風格、診斷提示或程式碼清理的意見,不會發到PR上,直接被過濾掉。
3月這套審查剛上線時,獲得實質性審查意見的內部PR佔比,從16%升到了54%。
第三關,是安全審查。
在團隊內部,程式碼審查或安全審查留下的發現,只要沒關閉,PR就合不進去:要麼修掉,要麼寫明理由關掉。
第四關是持續整合(CI)檢查,包括程式碼規範、型別檢查、各平台測試和建置打包。
一個普通的命令列工具(CLI)改動,在交给人審之前,可能就要跑幾十項檢查。
反覆出現的問題,還要變成下一次的檢查依據。
CLAUDE.md記錄專案約定,REVIEW.md告訴審查器重點查什麼、哪些可以跳過,讓這次發現的問題,成為下次審查的經驗。
同一條意見提到第三遍,就該寫進規則裡。
第五關是人工審批,這一關最關鍵,下一節細說。
第六關,合併與發布。
改動通過前面幾關後,還要進合併佇列排隊。
輪到它時,系統把它放到主分支的最新版本上,所有檢查再跑一遍。
這一步防的是「各自沒問題,合起來出問題」。
合併之後,新功能也不會馬上推給所有使用者。
它先隱藏在功能開關後面,只對Anthropic內部員工開放。員工天天高強度使用,往往比外部使用者更早撞上問題。
而功能開關就像一個總閘,不用改程式碼、不用重新發版,就能決定功能開還是關。
最後是兜底。
出了問題,先拉下總閘。
團隊每週輪班值守,每次事故復盤都要追問:這件事本該在哪一關被攔住?
所以,審查沒有消失,變成了貫穿開發、合併和發布的層層檢查。
零人審批的邊界在哪裡
前四關全綠之後,第五關根據風險分級,決定這次改動需要幾個人批准。
文件、文案、僅內部可見的功能,以及藏在開關後的新增改動,屬於低風險,自動審查和安全檢查通過後,可以免人工審批。
普通產品改動,以及快取、自動更新器、系統提示詞這類敏感區域,需要一個人。
風險最高的程式碼,加上少數指定路徑,需要兩個人。
看上去,低風險改動已經「無人駕駛」了?
沒那麼簡單。
風險檔位由改動本身決定:第一個分類器讀程式碼、定風險,第二個再判斷是否需要額外增加人工審批。
程式碼所有者標記的敏感路徑,以及所有CI工作流檔案,必須有人審查。
輕量審批通道也有門檻:只對倉庫「可信作者」名單裡的人開放,名單外的人必須再找一個人批准。
指揮AI寫程式碼的人,本身就算一名審查者,也要像親手寫程式碼一樣,為這次改動負責。
零人審批,不等於無人負責。
人要決定功能該不該做、架構是否合理,還要判斷現有檢查能不能覆蓋這次的風險。
所以Claude Code團隊有條規矩:你合進去的程式碼,出了問題,通常由你來修。
點下批准之前,審查者得說清楚:這些檢查驗證了什麼,還有哪些風險沒有覆蓋。
說不清,就別急著點通過,先補上必要的審查。
AI審查也會失靈
自動化審查,也會把自己卡住。
一個CLI專案的PR,一夜之間經歷了五十多輪審查和修復,最後是作者手動叫停。
人可以一秒鐘忽略一個小毛病,但AI不會,它會老老實實去改,改完又是一次提交,又是一輪審查。
團隊用git blame回查,發現審查器反覆標出的問題裡,約59%是首輪審查前就在的老程式碼。它很少找到新bug,只是每輪多挖出幾個舊的。
後來他們改了四條規矩:
滿三輪還沒通過,就提醒作者退一步、重新想方案;
前幾輪之後,只審新增改動;
同類問題一次指出;
提過的問題不再重複。
效果立竿見影。
經過一輪審查和修復就通過的內部PR佔比,從65%升到78%;需要五輪及以上的,從8.9%降到1.5%;平均審查次數,從2.08降到1.32。

調整複審規則後,一輪審查和修復後的通過率從65%升至78%,平均審查次數從2.08降至1.32。
審查的本事,一半在找問題,一半在知道何時收手。
多層審查,是不是就萬無一失?
Anthropic自己給過一個反例。
3月26日,Claude Code上線了一項優化:會話閒置超過一小時,就清理一次舊的推理記錄。
但一個bug讓它在恢復對話後的每一輪都在執行清理。結果,Claude變得健忘、開始重複,使用工具也變得反常。這個 bug直到4月10日才修復。

閒置後本應只清理一次舊推理,實際卻每輪持續清理;紅框標出誤刪內容。
官方4月23日的複盤承認:
這個改動穿過了多輪人工和自動審查,單元測試、端到端測試、內部試用全沒攔住,光確認根因就花了一週多。
轉折在複盤裡。
團隊用Code Review重審了出事的PR,在給足相關倉庫上下文時,Opus 4.7找到了這個bug,Opus 4.6沒找到。
這次回測說明,模型能力和上下文完整性,都會影響檢出結果。於是他們讓審查能引入更多倉庫。
如今,每一次事故,都會變成一道考題。
團隊把PR收集起來,由熟悉程式碼的工程師逐個確認其中的bug,整理成一套考題。
審查器每天對著這套考題跑分。每次調整提示詞、工具或模型,也要用它檢驗效果:成績沒有提高,這次調整就不採用。
團隊也沒把話說滿。
改動上線後,仍要靠開發者、值班人員結合數據看板發現異常。
根據回滾率等指標自動收緊審批的「熔斷」機制,還沒有建好。工程師們希望先補上這道保險,再讓更多改動走零人審批。
審查難免漏檢,發現和補救也要跟上。
一位Claude Code團隊成員這樣解釋:放慢速度確實能少出錯,但主要因為你什麼都做得少了。所以他們更願意把力氣花在更快發現問題、更快修復上。
一個人用AI寫程式碼,要驗收什麼
AI審查只給意見,拍板的還是你。
所以,別急著追求「不用看」,而是先讓AI每次交付都回答三個問題。
第一,怎麼驗證的?
跑了什麼檢查,結果是什麼,哪些情況還沒覆蓋。
Claude Code創造者Boris Cherny說過,給Claude一個驗證自己的辦法,可能是最重要的一件事。他估計,這能讓最終結果的質量達到原來的2至3倍。

Boris Cherny建議讓Claude自行驗證工作,形成反饋循環;他估計最終結果質量可提升至2—3倍。
第二,會影響哪裡?
改動涉及哪些用戶、數據和權限。
讓AI給匯報工具加一個共享功能,就得問清楚:鏈接誰能打開,打開後能看到什麼。
第三,出錯怎麼撤回?能不能一鍵關掉新功能、退回上一版。
動手前先提交存檔,每次改動盡量小。先能撤回,再談少審。
除了這三個問題,再養成三個習慣。
第一,換個「腦子」複審。
寫代碼的會話,最容易對自己的bug視而不見。
開一個新會話,或者讓子智能體用全新上下文複審,本地的/code-review和/security-review命令也能直接跑。
第二,給改動分檔。
改文案、調樣式,檢查通過、實際效果確認後再合併;涉及登錄、付款、刪除數據,就要人工細查關鍵邏輯,並補上針對性測試。
先嚴一點,等驗證和回滾流程跑順了,再逐步減少低風險改動的人工審查。
第三,三輪不過,就換思路。
AI改了三輪還在原地打轉,別催它第四輪,先問問方案本身是不是錯了。
最重要的一點:AI說「通過」,不等於你已經完成驗收。
代碼是你讓它寫的,上線後的結果,也得由你負責。
Claude Code團隊的目標,是讓多數PR至多一人介入,同時守住回滾率和事故率。
人的注意力,要更多地放在判斷風險、確認檢查是否充分,以及出錯後如何補救上。
人可以不讀每一行代碼,但每一次上線,都必須有人負責。
參考資料:
https://claude.dev/blog/solving-code-review-at-anthropic/?utm_source=chatgpt.com
https://www.anthropic.com/research/april-23-postmortem?utm_source=chatgpt.com
https://x.com/bcherny/status/2007179861115511237
編輯:元宇
本文來自微信公眾號 「新智元」(ID:AI_era),作者:ASI啟示錄