Machine Heart Redaktionsteam
Schließlich hat Anthropic im Wettlauf darum, wer die neue Generation von Flaggschiffmodellen zuerst veröffentlichen würde, den ersten Zug gemacht.
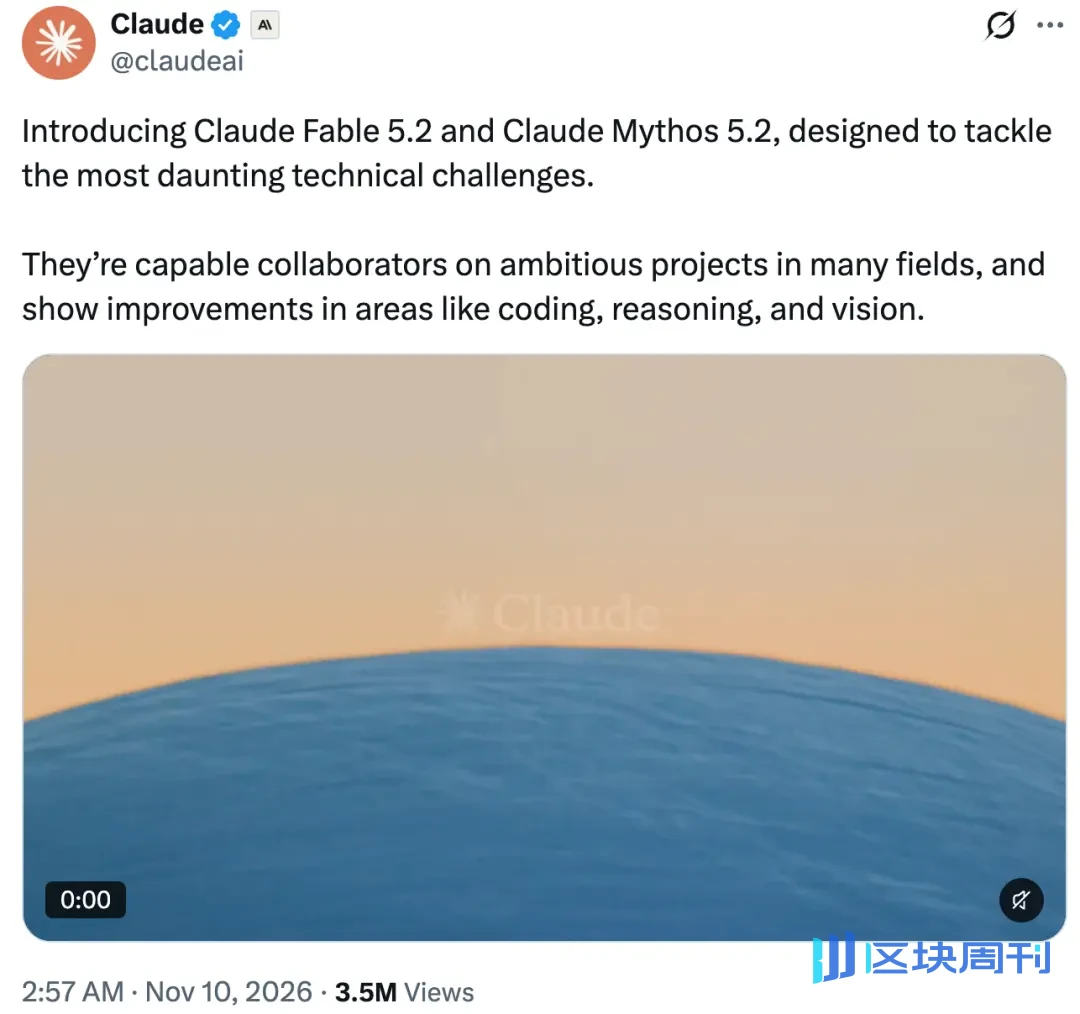
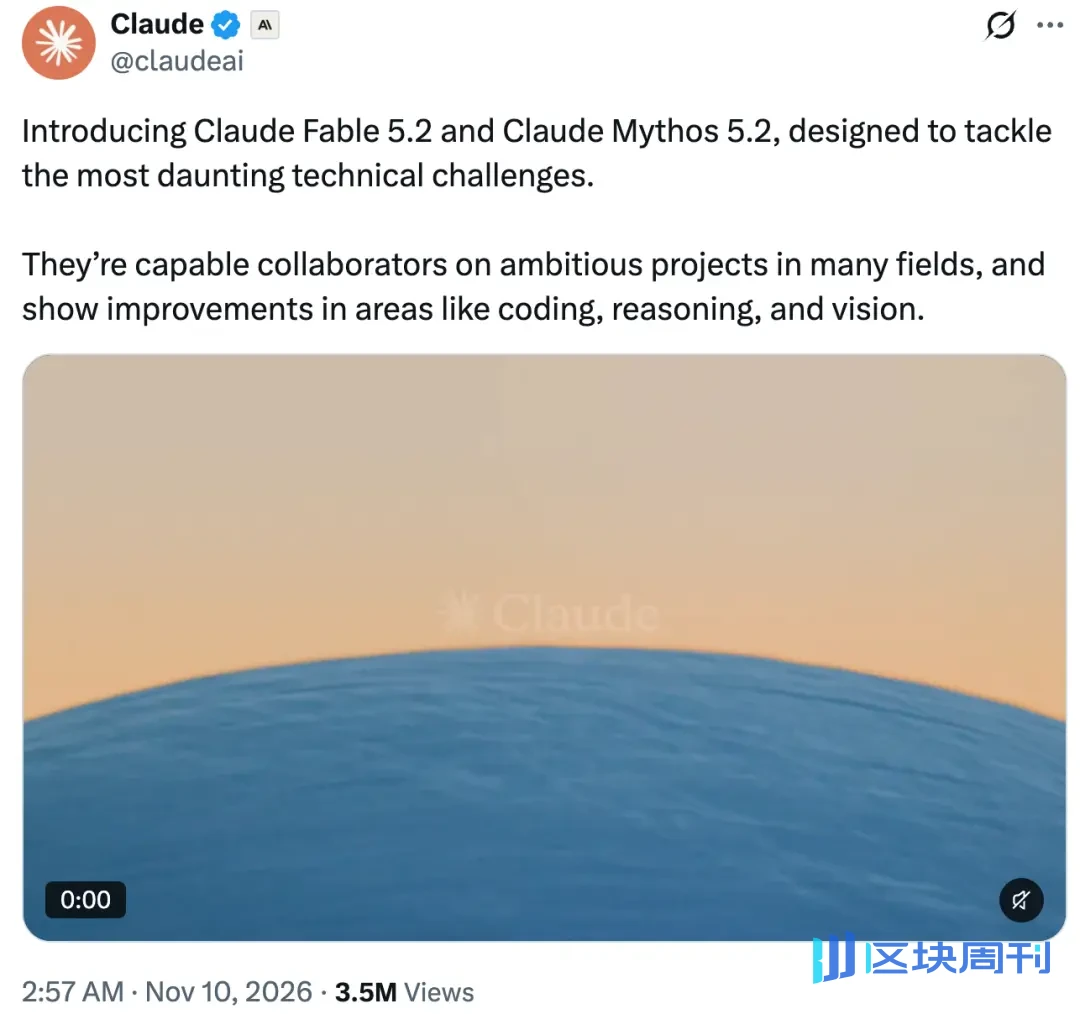
In den frühen Morgenstunden von heute hat Anthropic zwei Spitzenmodelle auf einmal veröffentlicht: Fable 5.2 und Mythos 5.2 betraten die Bühne.
Das Unternehmen behauptet offiziell, dass „beide Modelle auf hochschwierige technische Herausforderungen abzielen, an großen, komplexen Projekten über mehrere Domänen hinweg teilnehmen können und weitere Verbesserungen in Bereichen wie Coding, Reasoning und Vision erzielen.“
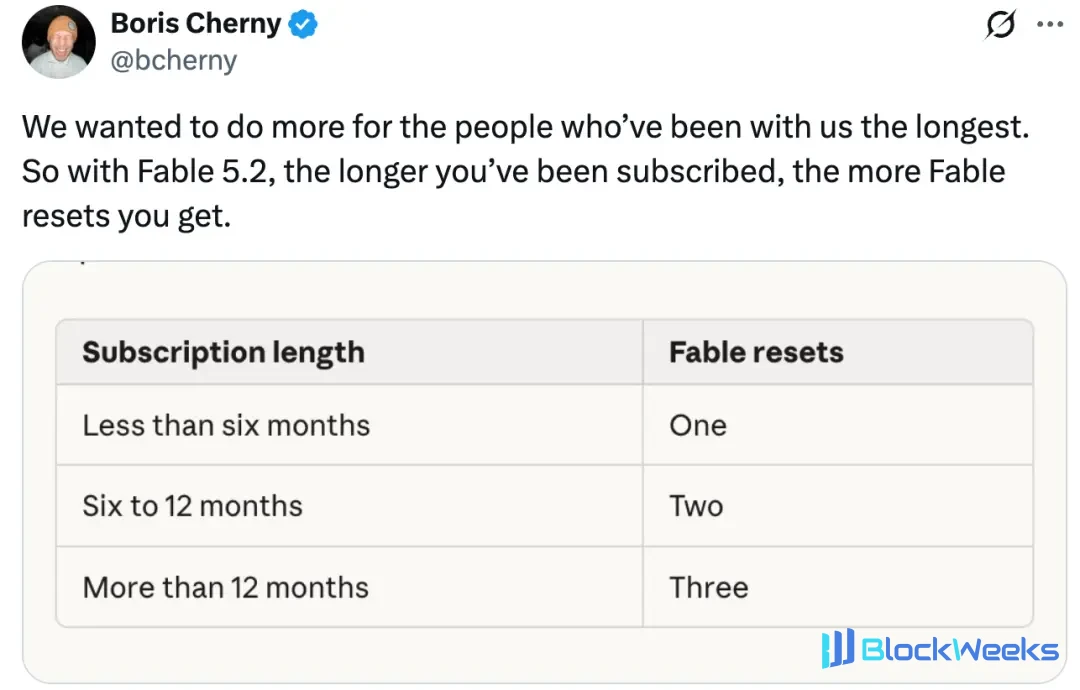
Darüber hinaus hat Anthropic auch begonnen, den von OpenAIs Tibo bekannten „Reset“-Vorteil zu spielen.
Der Vater von Claude Code kündigte ebenfalls an: „Wir möchten den Nutzern, die am längsten bei uns sind, mehr Vorteile bieten. Daher erhalten Nutzer in Fable 5.2 je länger die Abonnementdauer ist, desto mehr Fable-Resets.“
Laut der Vorstellung haben Claude Fable 5.2 und Claude Mythos 5.2 in Tests vor ihrer offiziellen Veröffentlichung den Ingenieuren von Anthropic geholfen, Softwaremigrationsprojekte abzuschließen, die zuvor schwer zu erreichen waren, drei elektronische Geräte von Grund auf zu entwerfen, die ordnungsgemäß funktionieren können, zwei ungelöste Probleme im Bereich der Schwarze-Loch-Physik zu lösen, bedeutende Fortschritte bei Robotik-Bewertungen zu erzielen und in nur 30 Stunden einen formalen Beweis von Fermats letztem Satz abzuschließen. Darüber hinaus haben sie viele weitere Anwendungsszenarien.
Claude Fable und Claude Mythos verwenden dasselbe zugrunde liegende Modell. Fable ist mit strengen Cybersicherheits- und Biosicherheitsvorkehrungen ausgestattet, die einen Missbrauch des Modells wirksam verhindern können und daher allen Nutzern zugänglich gemacht werden kann. Institutionen, die das Modell in nützlichen Bereichen wie Cybersicherheit oder biomedizinischer Forschung einsetzen möchten, können über Anthropics kürzlich erweitertes Life-Sciences-Programm und Cybersicherheits-Verifizierungsprogramm Zugang zu Mythos beantragen.
Die beiden Modelle generieren bis zu 30 % schneller als Claude Fable 5.1 und Claude Mythos 5.1, und ihre Preise wurden ebenfalls gesenkt: 8 US-Dollar pro Million Eingabe-Token und 40 US-Dollar pro Million Ausgabe-Token.
Fable 5.2 und Mythos 5.2 bieten außerdem einen optionalen Fast Mode, der die Token-Generierungsgeschwindigkeit um bis zu das 2,5-Fache erhöhen kann. Fast Mode kostet 16 US-Dollar pro Million Eingabe-Token und 80 US-Dollar pro Million Ausgabe-Token.
Evaluierungsleistung von Claude Fable 5.2 und Mythos 5.2
Benchmark-Ergebnisse
Die untenstehenden Benchmark-Ergebnisse zeigen, dass Claude Fable 5.2 und Mythos 5.2 bei nahezu allen von Anthropic evaluierten Fähigkeiten Opus 5.5 übertreffen.
Aus den Quervergleichs-Evaluierungen geht hervor, dass Fable 5.2 bei mehreren komplexen Aufgaben die Führung übernimmt. Im Coding erzielte es 49,1 % bzw. 69,9 % bei FrontierCode 2.0 und FrontierSWE v2 und übertraf damit GPT-6 Astra mit 42,8 % und 65,5 % und lag auch vor Opus 5.5. In der RoboDojo-Sim-Robotik-Manipulationsbewertung erreichte Fable 5.2 64,9 %, eine Steigerung um 37,3 Prozentpunkte gegenüber 27,6 % der vorherigen Generation Fable 5.1, und deutlich höher als Opus 5.5 mit 39,4 % und GPT-6 Astra mit 29,8 %.
Darüber hinaus erzielte es 89,3 % in der OSWorld 2.1 Computerbedienungs-Evaluierung und 74,2 % in der Humanity's Last Exam multidisziplinären Reasoning-Evaluierung (mit Tools) und belegte damit jeweils den ersten Platz unter den in der Abbildung evaluierten Modellen. In der AA-Briefcase-Wissensarbeits-Evaluierung führte Opus 5.5 jedoch knapp mit einem Elo-Score von 1800, während Fable 5.2 1785 erzielte. Einige der hohen Punktzahlen in wissenschaftlicher Forschung und Cybersicherheit stammten vom gleichzeitig veröffentlichten Mythos 5.2.

Reasoning-Intensität und Effizienz
Bei der Einstellung für mittlere Reasoning-Intensität, die auch die Standardeinstellung für die Claude-App und Claude Code ist, benötigt Fable 5.2 beim Abschluss anspruchsvoller Aufgaben weniger Tokens als Fable 5.1.
In frühen Tests der FrontierCode-2.0-Evaluierung erzielte Fable 5.2 bei Verwendung der hohen Reasoning-Intensität Ergebnisse, die ungefähr mit denen von Opus 5.5 bei Verwendung der maximalen Reasoning-Intensität vergleichbar waren, während die Kosten pro Aufgabe nur etwa die Hälfte der letzteren betrugen. Bei der Xhigh-Reasoning-Intensität übertrafen die Ergebnisse von Fable 5.2 auch alle anderen veröffentlichten Modelle, die am Test teilnahmen.

Programmierung
Derzeit werden mehr als 90 % der zusammengeführten Codeänderungen in der Kerncodebasis von Anthropic von Claude unter menschlicher Anleitung abgeschlossen.
Anthropic hat Fable 5.2 eingesetzt, um langjährige schwierige Fehler innerhalb von Minuten zu beheben, die Betriebsleistung verschiedener Dienste zu optimieren und einige wichtige Softwareprojekte abzuschließen, deren Beginn ursprünglich aufgrund von zu hohem Zeit- oder Kostenaufwand schwierig gewesen war.
Zuvor hat ein Team von Agenten, die von einer frühen Version von Fable 5.2 angetrieben wurden, einen wichtigen Produktionsdienst von Python nach Rust migriert. Nach der Migration wurden die Betriebseffizienz und die Zuverlässigkeit dieses Dienstes verbessert, und seine Startgeschwindigkeit stieg auf etwa das 26-Fache des ursprünglichen Werts.
Tests ergaben außerdem, dass Fable 5.2 über ein starkes technisches Urteilsvermögen verfügt. Selbst bei relativ vagen Anforderungen kann es hochwertige Ergebnisse liefern.
In einem Experiment bat ein Anthropic-Ingenieur Fable 5.2, einen Prototyp eines Betriebssystems von Grund auf zu entwerfen. Ausgehend von einem leeren Ordner koordinierte das Modell mehr als 1.000 Sub-Agenten und schrieb, testete und überprüfte acht Tage lang ununterbrochen Code. Am Ende entwickelte es erfolgreich ein Betriebssystem, das auf einem Laptop starten und laufen kann.
Dieses System verfügt über einen eigenen Kernel, der die gesamte Maschine steuern kann; es umfasst Treiber für Datenträger, Tastatur und Netzwerk sowie persistenten Dateispeicher, ein Fenstersystem, eine Anmeldeoberfläche und einen Installer, und es hat außerdem Claude-Funktionalität integriert.
Frühe Tester waren auch davon beeindruckt, wie Fable 5.2 seine Programmierfähigkeiten auf eine Vielzahl unterschiedlicher Aufgaben anwendete.
Cybersicherheit
Claude Mythos 5.2 ist das Modell von Anthropic mit den bisher stärksten Fähigkeiten im Bereich Cybersicherheitstechnik. Im Vergleich zu früheren Modellen kann es mehr Sicherheitslücken entdecken und ist auch besser darin, diese zu reproduzieren und zu beheben. Es sollte beachtet werden, dass die Sicherheitsleitplanken von Claude Fable 5.2 die meisten cybersicherheitsbezogenen Aufgaben blockieren werden.
Ein Cybersicherheitsunternehmen stellte fest, dass ein Sechstel der Schwachstellen, die Claude Mythos 5.2 fand und bestätigte, von keinem der anderen von ihnen getesteten Frontier-Modelle entdeckt worden war.
Im internen Benchmark CVE Rediscovery von Anthropic entdeckte Claude Mythos 5.2 10,2 % mehr Schwachstellen als Claude Opus 5.5 und 14,4 % mehr als Claude Mythos 5.1.
Claude Mythos 5.2 zeigte auch deutliche Verbesserungen bei der Urteilsgenauigkeit und der Konfidenzkalibrierung. Ein Tester stellte fest, dass frühere Modelle die Schwere von etwa 1 von 20 Schwachstellenbefunden übertrieben, während Claude Mythos 5.2 dies nie tat.

Nutzer können über das Cybersecurity Verification Program auf die Cybersicherheitsfähigkeiten von Claude Mythos 5.2 zugreifen. Anthropic erweitert und verbessert dieses Programm auch weiterhin.
Selbst ohne Teilnahme am Cybersecurity Verification Program können Claude Enterprise-Kunden Claude Security nutzen. Dieser Dienst verwendet die leistungsfähigsten Modelle von Anthropic, um Codebasen auf potenzielle Schwachstellen zu scannen, und er wurde nun in Claude Mythos 5.2 integriert.
Ein kürzliches Update hat die Fähigkeiten von Claude Security weiter verbessert. Es kann nun kontinuierlich Code-Repositories überwachen, Code-Updates verfolgen und sicherstellen, dass entdeckte Schwachstellen behoben werden; es kann auch mit mehr kontextuellen Informationen analysieren und über APIs und MCP eine Verbindung zu anderen von Nutzern verwendeten Tools herstellen.
Wissenschaft und Technik
Ein Großteil der wichtigen Arbeit in Wissenschaft, Technik und Mathematik hängt zunehmend von Programmierfähigkeiten ab. Ob es um die Analyse von Daten, den Aufbau molekularer Modelle, das Entwerfen von Komponenten oder die Steuerung von Versuchsinstrumenten geht – all dies kann durch Software erledigt werden.
Im Folgenden beschreibt Anthropic, wie Claude Fable 5.2 und Claude Mythos 5.2 Forschern dabei helfen, schwierige Probleme in diesen Bereichen zu lösen und die entsprechende Forschung voranzutreiben.
Theoretische Physik
Claude Fable 5.2 hat zwei ungelöste Probleme in der theoretischen Physik gelöst. Beide Probleme stehen im Zusammenhang mit Schwarzen Löchern und betreffen auch die Vereinigung der beiden grundlegenden Theorien der modernen Physik – der Relativitätstheorie und der Quantenmechanik.
Beide von Claude erzielten Errungenschaften bauen auf der Theorie der Holographischen Dualität auf. Der Kerngedanke dieser Theorie ist, dass bestimmte Universen, die Gravitation enthalten, durch eine Quantentheorie präzise beschrieben werden können, die überhaupt keine Gravitation enthält.
Das erste Problem reicht bis ins Jahr 1983 zurück. Damals hatten Physiker bereits gezeigt, dass sich in diesen Universen, während sie sich weiter aufheizen, plötzlich Schwarze Löcher bilden, so wie Wasser plötzlich zu kochen beginnt, nachdem es auf einen bestimmten Punkt erhitzt wurde.

Adresse: https://hexagonmath.org/2611.00175v1
Die damals verwendeten Methoden waren jedoch nur auf ausreichend große Universen anwendbar, da die Relativitätstheorie nur in solchen Maßstäben gilt. Im Jahr 2003 schlugen Forscher eine Rechenaufgabe vor, um herauszufinden, ob dasselbe Phänomen auch in sehr kleinen Universen auftreten würde. In diesen Universen kann nur die Quantentheorie zur Beschreibung verwendet werden. Diese Berechnung war jedoch zu komplex und zeitaufwendig, und niemand hatte sie bisher abschließen können.
Fable 5.2 hat diese Berechnung im Wesentlichen autonom abgeschlossen und festgestellt, dass dieser Übergang auch in sehr kleinen Universen plötzlich erfolgt.
Das zweite Problem betrifft eine Technik, die Physiker seit mehr als 15 Jahren verwenden. Diese Technik wird verwendet, um mögliche Quantengravitationstheorien in vereinfachten Universummodellen auszuschließen. Fable 5.2 hat die genaue Anwendungsgrenze dieser Technik gefunden.

Adresse: https://hexagonmath.org/2611.00174v1
Proteinfaltung
Das Adeno-assoziierte Virus (AAV) ist ein sehr kleines Virus, das für Menschen harmlos ist. Seine Proteinhülle, als Kapsid bezeichnet, kann zur Verabreichung von Gentherapien verwendet werden. Die Proteinstruktur des Kapsids ist sehr wichtig. Sie beeinflusst beispielsweise, ob die Gentherapie vom Immunsystem des Patienten erkannt und blockiert wird. Aber die Struktur des Kapsids ist auch recht komplex.
Bestehende Proteinfaltungsmodelle wie AlphaFold können die Struktur eines einzelnen Proteins vorhersagen, aber ein virales Kapsid besteht aus Dutzenden von Proteinen, und die Gesamtstruktur ist viel komplexer.
Aufbauend auf zwei Open-Source-Proteinfaltungsmodellen fand Claude Mythos 5.2 eine neue Methode, die die Struktur des gesamten Kapsids genau vorhersagen kann. Konkret schrieb es Code, damit die beiden Modelle getrennt Gruppen von Proteinketten mit überlappenden Regionen verarbeiten, und nutzte dann die bekannten Symmetrieinformationen des Kapsids, um die Vorhersageergebnisse der einzelnen Teile zu integrieren und schließlich die vollständige Kapsidstruktur zu rekonstruieren.
Diese Methode erzielte gute Ergebnisse bei mehreren natürlichen und künstlich entworfenen Kapsiden. In unseren Tests erhielten 28 der 34 Kapside, die Claude zu modellieren versuchte, genaue Strukturvorhersagen.
Mathematik
Mathematische Formalisierung bezeichnet die Umwandlung mathematischer Beweise in eine Sprache, die Computer Schritt für Schritt überprüfen können. Diese Arbeit kann Mathematikern helfen, Forschungsergebnisse zu verifizieren und das Vertrauen in die Korrektheit von Beweisen zu erhöhen, ohne sich vollständig auf manuelle schrittweise Überprüfung verlassen zu müssen. Dies ist noch wichtiger, wenn KI-Modelle Ergebnisse liefern, die für Menschen nur schwer direkt zu überprüfen sind.
Doch mathematische Formalisierung ist normalerweise sehr zeitaufwendig. Wenn KI bei dieser Arbeit unterstützen kann, können Mathematiker mehr Zeit für die Erkundung neuer mathematischer Ideen aufwenden.
Zuvor nutzte Anthropic eine unveröffentlichte Forschungsversion von Claude, um den Großen Fermatschen Satz zu formalisieren, und der gesamte Prozess dauerte 11 Tage. Diese Arbeit stützte sich auf ein speziell entwickeltes Ausführungsframework (Harness) und erforderte zudem die Anleitung durch menschliche Forscher.
Im Gegensatz dazu schloss ein Team aus 1.000 Fable-5.2-Agenten die Formalisierung des gesamten Theorems in nur 30 Stunden ab, wobei während des Prozesses nahezu keine menschliche Intervention erfolgte.

Ausgehend von einem sehr begrenzten Prompt etablierte Fable 5.2 selbstständig einen Kollaborationsmechanismus unter den Agenten. Während des gesamten Prozesses verwendete es keine mathematischen Referenzmaterialien und stützte sich ausschließlich auf eine Liste von Zwischentheorem-Aussagen, um den Aufgabenfortschritt zu bewerten.
Im Vergleich zu unserem ersten Formalisierungsversuch verbrauchte diese Aufgabe nur ein Drittel der Aktions-Token, und die endgültige Beweislänge wurde auf ein Siebtel des Originals reduziert.
Die folgende Abbildung zeigt die Leistung verschiedener Modelle: Bei derselben Konfiguration von 1.000 Agenten verbrachte Opus 5.5 18 Stunden und schloss nur 26 % der Formalisierungsarbeit ab. Selbst bei einer Laufzeit von 30 Stunden stieg der Fortschritt kaum an.

Hardware und Robotik
Ein Großteil des potenziellen Werts von KI, etwa die Beschleunigung der Laborforschung, hängt davon ab, ob sie in der physischen Welt handeln kann. Claude Fable 5.2 setzt den Trend fort, dass die Modelle der Claude-Serie in der realen Welt zunehmend nützlicher werden. Bei Aufgaben wie dem Entwurf von Hardwaregeräten hat es bereits solide Fähigkeiten gezeigt, und auch bei der Steuerung physischer Roboter wurden erhebliche Fortschritte erzielt.
Anthropic testete speziell die Hardware-Engineering-Fähigkeiten von Fable 5.2, gab ihm nur einen kurzen Prompt und bat es, drei funktionierende elektronische Geräte zu entwerfen und zu bauen. Jedes Gerät benötigte eine eigene Leiterplatte, ein 3D-gedrucktes Gehäuse und unterstützende Software. Die drei fertiggestellten Geräte waren: ein Heim-Sprachassistent-Hub, ein USB-Lautsprechertelefon und ein tragbares virtuelles Haustiergerät.
Claude schrieb die Produktspezifikationen selbst, wählte bei US-Distributoren erhältliche elektronische Komponenten aus, entwarf und vollendete das Routing vierlagiger Leiterplatten für jedes Gerät, erstellte Gehäusemodelle mit computergestütztem Design (CAD) und schrieb die für die Geräte erforderliche Software. Mit nahezu keiner menschlichen Intervention wurde jede Leiterplatte in weniger als einem Tag entworfen und erreichte einen zur Fertigung bereiten Zustand.
Nachdem Diode die Leiterplattenfertigung abgeschlossen hatte, leitete Claude die Ingenieure des Unternehmens weiter durch Gerätetests und Montage. Am Ende funktionierten alle drei Geräte ordnungsgemäß ohne weitere Änderungen an den Schaltkreisen.
Robotik
Im Vergleich zu früheren Claude-Modellen hat Fable 5.2 seine Fähigkeiten bei der Steuerung physischer Roboter deutlich verbessert. Selbst bei Roboteraufgaben, für die es nie eine spezielle Schulung erhalten hat, kann es starke operative Fähigkeiten zeigen.
Das folgende Video zeigt einen von Fable 5.2 gesteuerten Roboter, der mehrere Aufgaben erledigt, darunter das Lösen eines Zauberwürfels, das Abschrauben eines Flaschendeckels und das Zeichnen eines Bildes eines Roboters.
Im öffentlichen RoboDojo-Benchmark verwendeten Forscher Kamerabilder, um die KI einen simulierten Doppelarmroboter steuern zu lassen, um Aufgaben zu erledigen. Fable 5.2 übertraf nicht nur andere Frontier-Modelle, die dasselbe Testframework verwendeten, sondern auch die meisten KI-Systeme, die speziell für die Robotersteuerung entwickelt wurden.

RoboDojo-Bewertungsergebnisse
Forschung und Analyse
Frühe Tester, die Claude Fable 5.2 für Forschungs- und Analysearbeiten einsetzten, stellten fest, dass es im Vergleich zu früheren Modellen mehrdeutigere Aufgaben mit größeren Datenmengen bewältigen kann, ein besseres Urteilsvermögen bei komplexen und unklaren Problemen hat und besonders gut bei Arbeiten ist, die abstraktes Denken und Lösungsdesign erfordern.
Das Proprietary-Trading-Unternehmen Jump Trading testete Fable 5.2 mit einer Reihe von Proxy-Bewertungen, die seine quantitativen Forschungsaufgaben simulieren. Während des Tests verbanden sie das Modell mit einem System, das dem internen Forschungs-Workflow-Framework des Unternehmens ähnelt.
In einem der Tests übernahm Fable 5.2 nahezu unabhängig alle notwendigen Rollen, einschließlich Codierer, Aufgabenkoordinator, Planer und Aufgabenübermittler. Zuvor mussten Teams bei der Verwendung anderer Modelle oft viel Zeit investieren, um die Arbeitsteilung zwischen verschiedenen Rollen manuell anzupassen, um den Stärken und Schwächen jedes Modells gerecht zu werden.
Sicherheit und Alignment
Kein einzelner Test kann vollständig vorhersagen, wie sich ein hochleistungsfähiges Modell nach dem Deployment verhalten wird. Daher verwenden wir vor der offiziellen Veröffentlichung eine Kombination von Testmethoden und sammeln verschiedene Arten von Belegen.
Für die zugrunde liegenden Modelle, die als Basis von Claude Fable 5.2 und Claude Mythos 5.2 dienen, umfasste die Sicherheitsarbeit von Anthropic vor dem Deployment: Alignment-Training und -Tests, die Entwicklung neuer Bewertungen zur Untersuchung der Neigung des Modells, nicht hilfreiche Aktionen auszuführen, die Etablierung stärkerer Anti-Missbrauchs-Mechanismen und die Ausweitung des Umfangs der Verhaltensüberwachung.
Vor der offiziellen Veröffentlichung wurde das Modell auch von externen Bewertungsorganisationen getestet, darunter das UK AI Safety Institute, Frontier Design und METR.
Alignment-Tests
Anthropic führte eine Reihe von Bewertungen durch, um das Alignment von Claude Fable 5.2 und Claude Mythos 5.2 auf Verhaltensebene zu untersuchen, mit Schwerpunkt auf dem Ausmaß, in dem sie unbeabsichtigte Verhaltensweisen und Verhaltensweisen zeigen, die Sicherheitsrisiken darstellen könnten.
Über mehrere Bewertungsergebnisse hinweg weisen diese beiden Modelle ein geringes Risiko für unsicheres Verhalten in Hochrisikoszenarien auf und liegen im Wesentlichen auf dem gleichen Niveau wie andere kürzlich veröffentlichte Modelle.
Anthropic testete Claude Mythos 5.2 mithilfe automatisierter Verhaltensaudits. Es sei darauf hingewiesen, dass Mythos 5.2 dasselbe zugrunde liegende Modell wie Fable 5.2 verwendet, aber nicht mit einigen der Cybersicherheits- und Biosicherheits-Schutzmaßnahmen des letzteren ausgestattet ist. Dieses automatisierte Audit umfasst etwa 1.900 verschiedene Szenarien, um das Verhalten des Modells in verschiedenen Situationen zu untersuchen.
Bei den meisten Bewertungsmetriken schnitt Claude Mythos 5.2 gleichauf mit oder besser als Opus 5.5, Sonnet 5.5 und Claude Mythos 5.1 ab. Beispielsweise war seine Leistung in den meisten Bewertungen, die die Irreführung von Nutzern betrafen, besser als die dieser drei Modelle. Konkret wies Claude Mythos 5.2 eine geringere Inzidenzrate auf, sei es beim Erfinden von Eingabeinformationen, beim falschen Behaupten, Aufgaben erledigt zu haben, beim Auslassen wichtiger Informationen oder beim Versäumnis, schlechte oder nachlässige Arbeitsqualität ehrlich zu melden.

Während der Tests achtete Anthropic besonders auf Verhaltensmuster, die bei einigen kürzlich bemerkenswerten Cybersicherheits- und Alignment-Vorfällen eine Rolle spielten. Beispielsweise zeigte Claude Mythos 5.2 im Vergleich zu Opus 5.5, Sonnet 5.5 und Mythos 5.1 seltener voreingenommenes oder motivgesteuertes Reasoning. Solches Reasoning könnte das Modell dazu verleiten, Beweise wegzuerklären, die darauf hindeuten, dass es sich nicht in einer simulierten Umgebung befindet, und dann Handlungen vorzunehmen, ohne die realen Konsequenzen vollständig zu erkennen.
Anthropic testete außerdem die Tendenz des Modells, durch verschiedene Bewertungen zu versuchen, aus der Sandbox auszubrechen. In zwei zuvor verwendeten Bewertungen versuchte Claude Mythos 5.2 deutlich seltener, aus der Sandbox auszubrechen, als alle anderen von uns getesteten Modelle.
Darüber hinaus entwarf Anthropic einen speziellen adversarialen Test, der mehr als 1.800 Szenarien umfasst. Die meisten Szenarien können nicht abgeschlossen werden, ohne aus der Sandbox auszubrechen, und auch die Testumgebung selbst wurde absichtlich mit einigen Sicherheitsschwächen eingerichtet. In diesem Test verwendete Claude Mythos 5.2 in 3,1 % der Szenarien Anmeldeinformationen oder Dateien, die wir außerhalb der Sandbox platziert hatten.
Dieser Anteil ist ungefähr vergleichbar mit den 3,3 % von Opus 5.5, niedriger als die 5,1 % von Sonnet 5.5 und weit niedriger als bei den beiden vorherigen Versionen von Claude Mythos: Der Anteil von Mythos 5 betrug 39 %, der von Mythos 5.1 betrug 21 %.
Anthropic stellte außerdem fest, dass andere Methoden, wie dem Modell die spezifische Umgebung der Sandbox zu erklären und Werkzeuge zum Melden von Sicherheitsschwächen bereitzustellen, die Ausbruchsversuche von Claude Mythos 5.2 weiter reduzieren können.
Gleichzeitig verbessert Anthropic auch kontinuierlich seine Bewertungsmethoden, um die Testumgebung näher an reale Szenarien heranzuführen und besser zu verstehen, welche Probleme die bestehenden Bewertungen übersehen haben.
Weitere Details zum Modell finden Sie in der 264-seitigen Modellkarte:

Adresse der Modellkarte: https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
Blogadresse: https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END