
¿¡No puede ser, los benchmarks realmente han evolucionado hasta este nivel ahora!?
Esta vez ya no se trata de hacer problemas de práctica: simplemente le dan a la IA un conjunto de condiciones experimentales y la dejan investigar por su cuenta y predecir de antemano los resultados de experimentos reales de laboratorio húmedo...
Por ejemplo, si la misma reacción se lleva a cabo bajo varias condiciones diferentes, ¿cuál producirá más del producto objetivo? Entre un lote de variantes de anticuerpos, ¿cuál tendrá niveles de expresión más altos?
Las respuestas se ocultan primero y, una vez que la IA entrega su trabajo, los resultados medidos reales se comparan con él.
Y, ¿sabes qué? Esto es en realidad algo que vale la pena evaluar ahora mismo.
Durante los últimos dos años, el enfoque de IA para la Ciencia ha ido cada vez más profundo: la IA ya puede buscar literatura de forma autónoma, usar software y trabajar de forma continua durante horas para completar una tarea de análisis.
Naturalmente, todos han empezado a pasar a la siguiente etapa: ¿Qué tipo de capacidades de investigación científica queremos que tenga realmente la IA?
La predicción de resultados de laboratorio húmedo es uno de los puntos con considerable valor práctico.
Requiere que la IA comprenda el objetivo experimental y extraiga los mecanismos relevantes del conocimiento existente, de modo que pueda ayudar mejor a los investigadores a filtrar direcciones de investigación que valga la pena explorar más a fondo.
El nuevo benchmark Science Prediction Universe (SPU para abreviar), liderado y lanzado por UniPat AI, se ha percatado con agudeza de esto.
116 tareas, 4.207 experimentos de laboratorio húmedo, que abarcan química, ciencia de materiales, biología y medicina. Los asesores del benchmark y los colaboradores de laboratorio húmedo también provienen de universidades como Stanford, Cornell y Harvard, así como de instituciones de investigación de vanguardia y empresas biotecnológicas del sector.
El modelo sigue un sistema de jornada laboral de 8 horas cada vez, está equipado con una H20 y luego decide de forma autónoma cómo utilizar los recursos de recuperación y computación para formar predicciones experimentales.
Los resultados sorprendieron a todos.
Incluso modelos fuertes como Opus 5.5 y GPT-6 Astra, según los datos, siguen estando muy lejos de poder lograr realmente la predicción...
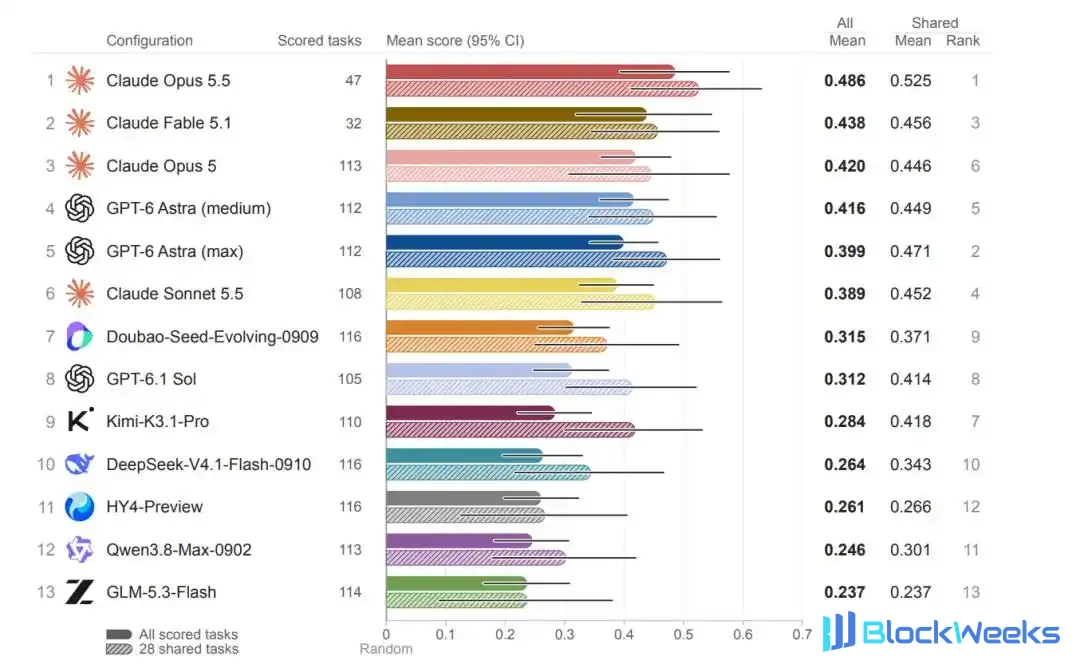
△Puntuaciones medias de cada configuración en todas las tareas puntuadas
Hay que decirlo, SPU les ha servido un plato difícil a todos los modelos de investigación.
Esas capacidades de investigación que antes eran invisibles e intangibles ahora se han convertido en valores numéricos que pueden evaluarse de forma uniforme y estudiarse de forma continua.
En cuanto a cómo se desarrolla paso a paso el juicio científico de la IA, ahora hay una base más concreta para el debate.
Predicción de laboratorio húmedo: merece un examen aparte para los modelos
Volviendo a la predicción de laboratorio húmedo, en primer lugar, ciertamente no es una cuestión nueva.
Ha habido muchos momentos así en la historia de la ciencia: se emite un juicio antes del experimento y luego se deja que el proceso decida: si es correcto, se mantiene; si es erróneo, se refuta.
La lógica específica del juicio constituye el gusto de un científico.
Con un gusto suficientemente bueno y una intuición suficientemente precisa, los científicos pueden obtener grandes resultados más rápido y a la vez ahorrar valiosos recursos experimentales.
Después de todo, solo un experimento de laboratorio húmedo: para química, hay que preparar reactivos, establecer condiciones de reacción y luego separar productos; para biología, también hay que pasar por una larga expresión de proteínas... El costo de tiempo y el costo de herramientas son en sí mismos bastante caros, y si los resultados no son ideales, hay que hacerlo una y otra vez durante varias rondas.
Así que predecir antes de empezar es el paso más valioso en el proceso de investigación.

La única diferencia es que en el pasado esto lo hacían puramente los propios científicos, y ahora en la era de la IA, los modelos también necesitan tener esta capacidad, y también necesitan un examen que pueda puntuarlos.
Los benchmarks existentes todavía no pueden cubrir esto por completo. Por ejemplo, BrainBench permite a los modelos juzgar directamente los resultados experimentales; ScienceAgentBench se centra en completar análisis sobre datos existentes; y los benchmarks de tareas de horizonte largo como Terminal-Bench 4.0 y Long-Horizon-TB utilizan principalmente pruebas preestablecidas para verificar las salidas de las tareas.
SPU es diferente de todos ellos.
Pone más énfasis en probar el proceso de investigación autónoma de la IA junto con la predicción de resultados de laboratorio húmedo, involucrando tanto el rendimiento de predicción como la capacidad de usar herramientas científicas y ejecutar tareas de horizonte largo.

△El gráfico fue generado por IA
Este tipo de juicio también ha sido organizado por SPU en tareas claras.
100 tareas públicas fueron tomadas respectivamente de 85 artículos publicados recientemente. Expertos en el dominio organizaron las opciones candidatas, materiales, condiciones y métodos de medición de la investigación, conservando resultados cuantitativos completos como base para la puntuación.
Además, 16 tareas privadas provienen de cuatro grupos de experimentos de laboratorio húmedo colaborativos no publicados, que involucran nanobodies VHH, condiciones de reacción, electrolitos y variantes de Magrolimab.
Un total de 32 subcampos y 4.207 experimentos, entre los cuales la investigación pública proporciona fuentes de tareas interdisciplinarias, los resultados medidos se ocultan a los modelos, y los experimentos no publicados añaden pruebas independientes de las respuestas en los artículos públicos.
Hasta cierto punto, esto puede evitar que los modelos hayan visto las preguntas de antemano.

△Cobertura y fuentes de las tareas de SPU
El proceso de selección de preguntas también es bastante particular.
Los expertos dan prioridad a los estudios con mediciones completas y condiciones claras; las preguntas simples que pueden ordenarse a lo largo de una sola tendencia se eliminan directamente, y las preguntas con valores demasiado cercanos también se consideran de poco valor de referencia.
Las preguntas que finalmente quedan son todas más difíciles y más discriminativas.
Durante el proceso de predicción específico, se requiere que el modelo se ejecute durante ocho horas cada vez, equipado con una CPU de 8 núcleos, 16 GiB de memoria y una H20, mientras se le permite buscar en línea e instalar software de investigación científica.
Durante este período, el modelo recopilará evidencia por sí mismo, elegirá métodos computacionales y finalmente enviará el ranking de predicción de menor a mayor para cada grupo de comparación.
Para evitar la contaminación de la memoria, el proceso de puntuación también se lleva a cabo en todo momento en un contenedor independiente y fuera de línea; al AI se le prohíbe recuperar los resultados originales de la investigación, y las salidas de las herramientas se escanean automáticamente para identificar identificadores como el DOI y el título del artículo fuente.
Finalmente, el sistema utiliza el coeficiente de correlación de Spearman para comparar el ranking predicho con el ranking medido.
Cuanto más cercano a 1 sea el coeficiente, más cercano será el ranking a los resultados experimentales.

△Proceso de evaluación de SPU
Curiosamente, SPU también presta atención a muchos detalles que las pruebas de referencia no han considerado.
Por ejemplo, en cuanto a la puntuación final, SPU considera si podría deberse a la suerte, en caso de que fuera un gato ciego que tropieza con un ratón muerto.
Por lo tanto, genera adicionalmente 4.000 rankings aleatorios para cada pregunta, utiliza el percentil 95 como umbral de nivel aleatorio y verifica si la presentación del modelo supera significativamente esta referencia. Las diferentes tareas también tienen sus correspondientes bases de referencia.
El diseño de todo el SPU se puede decir que es científicamente riguroso.
El modelo debe, paso a paso dentro de él, juzgar por sí mismo qué vale la pena computar y presentar su predicción final.
Este diseño no solo ayuda a medir la capacidad de predicción de laboratorio húmedo de la AI actual, sino que también señala la dirección para que los equipos de investigación posteriores mejoren continuamente los experimentos con la ayuda de métricas unificadas.
Dicho esto, a continuación bien podríamos echar un vistazo juntos a las tarjetas de calificaciones del primer lote de modelos de frontera. Los detalles bien vale la pena discutirlos por separado.
La nueva prueba hace que los modelos de frontera colapsen colectivamente
La primera ronda de evaluación sistemática de SPU abarca 12 modelos de frontera y 13 configuraciones. Las configuraciones aquí se refieren al modelo, la intensidad de razonamiento y el marco del modelo utilizado.
Primero, hablemos de los resultados generales.
En una frase: ninguno de ellos es bueno.
En todas las tareas puntuadas, la puntuación media más alta fue de Claude Opus 5.5, con 0,486 puntos. Pero incluso para él, solo la mitad de las tareas superaron el nivel aleatorio.
Entre las 13 configuraciones, esto es casi siempre el caso; la proporción de tareas que superan el umbral de nivel aleatorio es solo del 34% al 52%.
En otras palabras, todos los modelos presentes todavía tienen un largo camino por recorrer antes de lograr una predicción de laboratorio húmedo verdaderamente confiable.

△Análisis comparativo de comportamiento del grupo líder y el grupo rezagado
Sin embargo, también hay diferencias entre los modelos, y el rendimiento promedio se puede dividir en dos niveles:
el grupo líder (6 modelos) y el grupo rezagado (7 modelos).
En comparaciones con las mismas preguntas, el grupo líder en promedio sigue siendo aproximadamente 0,15 puntos más alto que los otros siete.
Hay otro detalle que vale la pena señalar. Alrededor del 9% de las tareas en el grupo líder obtuvieron puntuaciones por debajo de 0, mientras que para las otras siete configuraciones esta proporción puede llegar hasta el 22%.
Aquí, 0 se refiere a la puntuación promedio de un ranking válido aleatorio; una puntuación negativa significa que la predicción está correlacionada negativamente con el ranking real.
¿De dónde viene exactamente la brecha? El equipo de investigación profundizó un paso más.
Primero combinaron las predicciones de otros modelos sobre la misma pregunta en un ranking de referencia, luego emparejaron los experimentos de dos en dos, los compararon con los resultados medidos y verificaron si cada modelo los clasificaba correctamente de forma individual.
En los pares de experimentos en los que el ranking de referencia era correcto, el grupo líder los clasificó correctamente el 86% de las veces, mientras que las otras siete configuraciones alcanzaron el 78%; para los pares de experimentos en los que el ranking de referencia era incorrecto, ambos grupos los clasificaron correctamente de forma independiente en torno al 30%.
Así que, en realidad, parte de la ventaja del grupo líder se refleja precisamente en los puntos donde las predicciones son conjuntamente correctas; en esta parte, el grupo líder siempre es más estable.

En cuanto a por qué el modelo se desvía del juicio correcto, los registros de ejecución contienen pistas más específicas.
Tomemos como ejemplo la tarea de solución. Para la misma reacción de polimerización, se cambiaron 12 disolventes en secuencia, y la tarea requería clasificarlos según la masa del polímero finalmente separado.
Opus 5.5 obtuvo 0,874, mientras que Qwen3.8 obtuvo -0,126. Las 12 condiciones de disolvente candidatas se emparejaron de dos en dos, para un total de 66 pares; el primero clasificó correctamente 56 pares, y el segundo clasificó correctamente 30 pares.

△Dos ejecuciones de Opus y Qwen en la misma tarea
El análisis encontró que esto se debe a que ambos difirieron en los factores en los que se centraron desde el principio:
Qwen3.8 clasificó principalmente según cuánto etileno puede disolver el disolvente, mientras que Opus 5.5 prestó más atención a la miscibilidad de las materias primas y a la compatibilidad del catalizador en el disolvente.
Aunque Qwen3.8 también descubrió este problema durante el proceso de cálculo, finalmente no logró cambiar directamente la base de clasificación adoptada finalmente por el modelo.
Por lo tanto, la etapa en la que es más probable que se produzcan errores de predicción es el paso de elegir la base de juicio. El modelo también necesita aprender a ajustar el método de clasificación en tiempo real según las pistas, para que estos hallazgos puedan afectar realmente a la respuesta.
Desglosadas, estas diferencias también varían según la disciplina y la tarea específicas.
Entre los resultados puntuados para cada disciplina en las tareas públicas, la puntuación media más alta en química fue Opus 5.5, en ciencia de materiales fue Fable 5.1, en biología fue GPT-6 Astra Medium, y en medicina fue Opus 5.
P.D. Fable 5.1 y Opus 5.5 exhibieron comportamiento de rechazo a responder.

△Puntuaciones de cada modelo en las cuatro disciplinas
Así que si estás preparando que la IA participe en un determinado tipo de investigación, quizá primero deberías encontrar una tarea relacionada y probarla con SPU, y solo proceder con experimentos formales después de confirmar que el modelo es realmente aplicable.
Los resultados de las tareas privadas hacen que este punto sea aún más concreto.
Entre las 13 configuraciones, 12 tuvieron puntuaciones medias significativamente superiores al ranking aleatorio, y no se detectaron diferencias obvias entre las configuraciones. En cambio, la variación aportada por las diferentes tareas fue especialmente llamativa.
Para el mismo lote de electrolitos, al predecir la conductividad iónica, los coeficientes de correlación de rango de las 13 configuraciones se concentraron en el rango de 0,89 a 0,95; al cambiar a la ventana electroquímica, las puntuaciones de las 12 configuraciones que recibieron puntuación oscilaron entre -0,55 y 0,07, ninguna superó el umbral de nivel aleatorio.
El modelo no cambió, pero una vez que cambió el objetivo de medición, la distribución de puntuaciones también cambió claramente.
Así que la próxima vez que evalúes un modelo, decir solo que es bueno en química no es lo suficientemente específico; también necesitas ver qué objetivo de medición específico y qué condiciones experimentales está enfrentando.

△Rendimiento de predicción de cada modelo en las 16 tareas privadas
Aquí hay otra cosa bastante contraintuitiva:
En términos generales, darle al modelo más tiempo y mayor intensidad de razonamiento debería hacer que la puntuación siga subiendo, ¿verdad?
Todo el mundo piensa generalmente así, y todo el mundo lo hace así.
Pero ¿adivina qué? Una vez que salieron los resultados de SPU, nos dieron directamente una bofetada en la cara—
Bajo las mismas 8 horas de cómputo, el equipo de investigación ajustó GPT-6 Astra de intensidad de razonamiento media a la más alta. El tiempo de ejecución mediano en la intensidad más alta aumentó a 4,8 veces, y el costo mediano de API también aumentó a 5,3 veces.
Pero la puntuación de predicción... apenas se movió en absoluto.
¿Eh? El equipo de investigación incluso volvió específicamente a revisar los registros de ejecución del modelo.
Y vaya, en las 79 tareas completadas, GPT-6 Astra con la intensidad de razonamiento más alta generalmente ya había dado una respuesta en el 26% mediano de la ejecución.
El modelo tampoco estuvo inactivo después; continuó calculando y revisando, pero estos fueron todos ajustes finos y no se manifestaron como diferencias en los resultados.
En otras palabras, una mayor intensidad de razonamiento no necesariamente hace que los resultados sean mejores.

△Inversión y rendimiento de GPT-6 Astra bajo dos intensidades de razonamiento
Este fenómeno también sirve como recordatorio para la asignación de recursos del modelo: si quieres añadir cómputo, no te apresures a ciegas—consume tiempo, mano de obra y puede que ni siquiera compense.
En su lugar, puedes examinar los registros de ejecución con más cuidado, primero comprender plenamente a qué juicio corresponde realmente la nueva evidencia añadida, y luego impulsar la potencia de cómputo localmente de manera específica.
De hecho, un fenómeno similar también aparece en el uso de herramientas.
En cada ejecución, el número mediano de categorías de métodos utilizadas por GPT-6 Astra Max es 4, mientras que para Medium es 1, sin embargo, no se detectó una diferencia significativa en las puntuaciones entre las dos configuraciones.
La razón es muy similar: las buenas herramientas no se utilizaron donde más importaba.
Por ejemplo, con el muestreo de Monte Carlo, aunque el modelo llama a esta herramienta la mayor parte del tiempo, solo añade un margen de error a la clasificación final y no afecta directamente al resultado en sí.

△Invocación de herramientas de computación científica
Así que, en realidad, usar más herramientas no es tan bueno como usarlas con precisión.
El uso de GPU también ofrece una perspectiva interesante.
Incluso con suficiente potencia de cálculo de GPU proporcionada, solo 255 ejecuciones lograron realmente completarse en la GPU, menos de una quinta parte.
Los distintos modelos y las distintas disciplinas varían en sus ejecuciones en GPU, por lo que simplemente mirar el número de invocaciones de GPU difícilmente puede indicar la capacidad de investigación de un modelo.
Para juzgar si la potencia de cálculo ayudó, todavía hay que ver para qué se usó el cálculo, si los resultados del cálculo ayudaron a la predicción y cómo estos resultados afectaron la clasificación final.
La clave sigue siendo dirigir la potencia de cálculo hacia las magnitudes físicas relevantes para la clasificación, de modo que el modelo pueda completar las predicciones con mayor precisión.

△Estadísticas de uso de GPU
Considerando también el costo, el costo promedio de API por ejecución entre configuraciones oscila entre $0.22 y $65.91, una diferencia de nada menos que 300 veces.
Esto significa que SPU proporciona tanto rendimiento predictivo como costo de invocación, una buena referencia para los equipos que se preparan para desplegar modelos de investigación.
Desde las puntuaciones globales hasta las trayectorias por pregunta, SPU despliega las diferencias entre modelos en cada detalle del juicio científico, como la potencia de cálculo y el costo.
Cuánto ayudan realmente a la predicción los valores calculados por la IA; cuando una predicción falla, qué juicios deben revisarse... todo esto puede analizarse más a fondo combinando los resultados experimentales con los registros de ejecución.
La siguiente ronda de mejora tiene así una dirección clara que probar:
Según SPU, el modelo puede detectar más oportunamente las hipótesis erróneas y conservar o modificar las clasificaciones con más justificación. Tras los cambios, se vuelve a colocar en la misma tarea para ver si las predicciones se vuelven más precisas.
Llevar la "comprensión de las pruebas" al aula de exámenes del modelo
Se puede decir que SPU es altamente coherente con los patrones de desarrollo de AI4S.
La evaluación de AI4S se está profundizando gradualmente en etapas experimentales reales, y los benchmarks orientados a la ejecución de experimentos también han ido surgiendo este año.
Pero más allá de la ejecución, la predicción, como un paso inevitable en el proceso de investigación y el más difícil de cuantificar, finalmente tiene una forma medible.
Los beneficios se reflejan en dos aspectos:
Los investigadores pueden así analizar qué objetivos de medición son más fáciles de predecir, qué tareas difieren más y cómo se forma un juicio erróneo. Esto puede ahorrar recursos experimentales costosos y valiosos y acortar el tiempo de decisión.
Para el desarrollo de modelos, esto también proporciona una referencia más específica para la mejora.
A medida que aumentan los tipos de experimentos, la evaluación también puede responder preguntas más específicas: para qué materiales, condiciones experimentales y métodos de medición las clasificaciones dadas por la IA son más fiables y más dignas de referencia.
Los científicos pueden así acumular continuamente progreso en torno al mismo tipo de preguntas.

De hecho, SPU es solo la punta del iceberg en la serie de evaluaciones de trabajo real de UniPat AI:
- ScienceVision: se centra en cómo los modelos obtienen evidencia de objetos científicos tridimensionales y responden preguntas;
- PaperBenchX: convierte la investigación publicada en tareas de reproducción de artículos ejecutables y verificables;
- SaaS-Bench y EvoCode-Bench: examinan respectivamente los procesos reales de software y el trabajo de desarrollo cuando los requisitos cambian continuamente. ...
Estos trabajos abarcan la investigación científica, el trabajo de oficina y el desarrollo de software, y todos comparten una preocupación por cómo la IA completa tareas tras entrar en un trabajo específico, y cómo se verifican los resultados.
Esto también refleja indirectamente que UniPat AI tiene una visión única de la industria y un juicio prospectivo respecto al avance de la IA hacia la práctica de la investigación científica e incluso hacia el mundo real.
UniPat AI también demuestra un nuevo tipo de modelo de colaboración en IA:
Expertos de dominio participan en la selección y revisión de tareas, laboratorios asociados proporcionan tareas no publicadas, y el equipo del proyecto organiza experimentos de diferentes disciplinas en tareas de evaluación unificadas.
Tomando SPU como ejemplo, está liderado por UniPat AI, y las instituciones de los miembros asesores incluyen Stanford, Cornell, Harvard, UIC, la Universidad de Pekín, HKUST y FutureHouse. Colaboradores de laboratorio húmedo de Yourui Saishi, Aibotaike, Deep Principle y Enhe Biology participaron en el trabajo experimental relacionado.
El conocimiento interdisciplinario y los recursos experimentales entran así en un mismo proceso de evaluación. SPU no solo conlleva la selección de problemas, sino que también presenta la colaboración necesaria para organizar los problemas de investigación científica en tareas ejecutables.
Actualmente, las 100 tareas públicas relacionadas con SPU están planificadas para publicarse como paquetes de tareas completos de Harbor; las 16 tareas privadas permanecerán privadas para una evaluación controlada. Tanto el conjunto de datos como el código han sido de código abierto.
Es cierto que la IA actual sigue siendo solo una principiante frente a este mecanismo SPU.
Puede usar herramientas a la velocidad del rayo, e instalar tres conjuntos de software en 8 horas, terminar de ejecutar DFT y luego ejecutar Monte Carlo, pero en el juicio más crítico, aún no ha aprendido a hacerse una pregunta: ¿es la cantidad que estoy calculando precisamente la cantidad que el experimento realmente necesita medir.
Pero a medida que este tipo de tareas se acumulen continuamente, también se irá aclarando qué tipo de trabajo de investigación científica puede emprender la IA.
SPU ha medido esta distancia, y cada examen posterior es un registro de la IA acercándose al banco experimental real.
Este artículo proviene de la cuenta pública de WeChat "Quantum位" (ID: QbitAI), autor: Focus on Frontier Technology





