Zespół redakcyjny Machine Heart
W końcu, w wyścigu o to, kto pierwszy wyda nową generację flagowych modeli, Anthropic wykonał pierwszy ruch.
Wczesnym rankiem dzisiaj Anthropic wydał dwa modele najwyższej klasy za jednym razem: Fable 5.2 i Mythos 5.2 weszły na scenę.
Firma oficjalnie twierdzi, że „oba modele są ukierunkowane na bardzo trudne wyzwania techniczne, są w stanie uczestniczyć w dużych, złożonych projektach w wielu dziedzinach i osiągnąć dalsze ulepszenia w obszarach takich jak kodowanie, rozumowanie i wizja”.
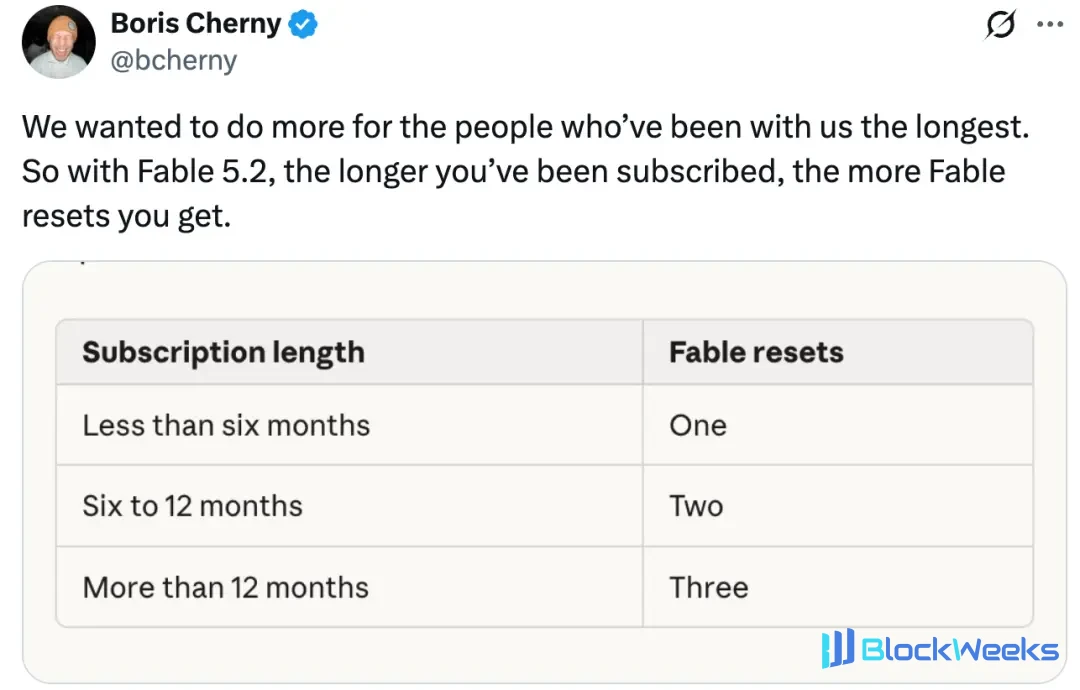
Ponadto Anthropic zaczął również grać w „Reset” – przywilej znany od Tibo z OpenAI.
Ojciec Claude Code również ogłosił: „Chcemy zapewnić więcej korzyści użytkownikom, którzy są z nami najdłużej. Dlatego w Fable 5.2 im dłuższy okres subskrypcji, tym więcej resetów Fable otrzymują użytkownicy”.
Zgodnie z wprowadzeniem, w testach przed ich oficjalnym wydaniem Claude Fable 5.2 i Claude Mythos 5.2 pomogły inżynierom Anthropic ukończyć projekty migracji oprogramowania, które wcześniej były trudne do osiągnięcia, zaprojektować od zera trzy urządzenia elektroniczne, które mogą działać prawidłowo, rozwiązać dwa nierozwiązane problemy w dziedzinie fizyki czarnych dziur, dokonać znaczącego postępu w ocenach robotyki oraz ukończyć formalny dowód Wielkiego Twierdzenia Fermata w zaledwie 30 godzin. Ponadto mają wiele innych scenariuszy zastosowań.
Claude Fable i Claude Mythos korzystają z tego samego modelu bazowego. Fable jest wyposażony w rygorystyczne zabezpieczenia cyberbezpieczeństwa i biobezpieczeństwa, które mogą skutecznie zapobiegać niewłaściwemu wykorzystaniu modelu, a zatem może być otwarty dla wszystkich użytkowników. Instytucje, które chcą używać modelu w korzystnych dziedzinach, takich jak cyberbezpieczeństwo lub badania biomedyczne, mogą ubiegać się o dostęp do Mythos poprzez niedawno rozszerzony program nauk przyrodniczych i program weryfikacji cyberbezpieczeństwa Anthropic.
Oba modele generują do 30% szybciej niż Claude Fable 5.1 i Claude Mythos 5.1, a ich ceny również zostały obniżone: 8 dolarów za milion tokenów wejściowych i 40 dolarów za milion tokenów wyjściowych.
Fable 5.2 i Mythos 5.2 oferują również opcjonalny tryb Fast Mode, który może zwiększyć szybkość generowania tokenów nawet 2,5-krotnie. Fast Mode jest wyceniany na 16 dolarów za milion tokenów wejściowych i 80 dolarów za milion tokenów wyjściowych.
Wyniki oceny Claude Fable 5.2 i Mythos 5.2
Wyniki benchmarków
Poniższe wyniki benchmarków pokazują, że w prawie wszystkich zdolnościach ocenianych przez Anthropic Claude Fable 5.2 i Mythos 5.2 przewyższają Opus 5.5.
Z ocen krzyżowych wynika, że Fable 5.2 wysuwa się na prowadzenie w wielu złożonych zadaniach. W kodowaniu uzyskał 49,1% i 69,9% odpowiednio na FrontierCode 2.0 i FrontierSWE v2, przewyższając 42,8% i 65,5% GPT-6 Astra, a także prowadząc przed Opus 5.5. W ocenie manipulacji robotycznej RoboDojo Sim Fable 5.2 osiągnął 64,9%, co stanowi wzrost o 37,3 punktu procentowego w porównaniu z 27,6% poprzedniej generacji Fable 5.1 i znacznie więcej niż 39,4% Opus 5.5 i 29,8% GPT-6 Astra.
Ponadto osiągnął 89,3% w ocenie obsługi komputera OSWorld 2.1 i 74,2% w ocenie rozumowania multidyscyplinarnego Humanity's Last Exam (z narzędziami), zajmując pierwsze miejsce wśród modeli ocenianych na rysunku. Jednak w ocenie pracy wiedzy AA-Briefcase Opus 5.5 nieznacznie prowadził z wynikiem Elo 1800, podczas gdy Fable 5.2 uzyskał 1785. Niektóre z wysokich wyników w badaniach naukowych i cyberbezpieczeństwie pochodziły z równocześnie wydanego Mythos 5.2.

Intensywność i efektywność rozumowania
Przy ustawieniu średniej intensywności rozumowania, które jest również domyślnym ustawieniem aplikacji Claude i Claude Code, Fable 5.2 wymaga mniej tokenów niż Fable 5.1 podczas wykonywania wymagających zadań.
We wczesnych testach ewaluacji FrontierCode 2.0, przy użyciu wysokiej intensywności rozumowania, Fable 5.2 osiągnął wyniki w przybliżeniu porównywalne z Opus 5.5 przy użyciu maksymalnej intensywności rozumowania, podczas gdy koszt na zadanie wynosił tylko około połowy kosztu tego drugiego. Przy intensywności rozumowania Xhigh wyniki Fable 5.2 również przewyższyły wszystkie inne udostępnione modele biorące udział w teście.

Programowanie
Obecnie ponad 90% scalonych zmian w kodzie w głównym repozytorium kodu Anthropic jest wykonywanych przez Claude pod nadzorem człowieka.
Anthropic użył Fable 5.2 do naprawienia długotrwałych trudnych błędów w ciągu kilku minut, zoptymalizowania wydajności działania różnych usług oraz ukończenia niektórych ważnych projektów oprogramowania, których rozpoczęcie było pierwotnie trudne z powodu zbyt dużej czasochłonności lub kosztów.
Wcześniej zespół agentów opartych na wczesnej wersji Fable 5.2 zmigrował kluczową usługę produkcyjną z Pythona do Rusta. Po migracji wydajność działania i niezawodność tej usługi uległy poprawie, a jej szybkość uruchamiania wzrosła do około 26 razy większej niż pierwotnie.
Testy wykazały również, że Fable 5.2 posiada silną zdolność oceny inżynierskiej. Nawet w obliczu stosunkowo niejasnych wymagań potrafi dostarczyć wysokiej jakości rezultaty.
W jednym z eksperymentów inżynier Anthropic poprosił Fable 5.2 o zaprojektowanie prototypowego systemu operacyjnego od zera. Zaczynając od pustego folderu, model koordynował ponad 1000 podagentów, nieprzerwanie przez 8 dni pisząc, testując i przeglądając kod. Ostatecznie z powodzeniem opracował system operacyjny zdolny do uruchomienia i działania na laptopie.
System ten ma własne jądro, które może sterować całą maszyną; zawiera sterowniki dysku, klawiatury i sieci, a także trwałe przechowywanie plików, system okien, interfejs logowania i instalator, a także ma wbudowaną funkcjonalność Claude.
Wcześni testerzy byli również pod wrażeniem tego, jak Fable 5.2 wykorzystywał swoje zdolności programistyczne w szerokiej gamie różnych zadań.
Cyberbezpieczeństwo
Claude Mythos 5.2 to model Anthropic o najsilniejszych jak dotąd zdolnościach inżynierii cyberbezpieczeństwa. W porównaniu z poprzednimi modelami potrafi odkryć więcej luk w zabezpieczeniach, a także lepiej je odtwarza i naprawia. Należy zauważyć, że zabezpieczenia Claude Fable 5.2 zablokują większość zadań związanych z cyberbezpieczeństwem.
Firma zajmująca się cyberbezpieczeństwem odkryła, że jedna szósta luk w zabezpieczeniach, które Claude Mythos 5.2 znalazł i potwierdził, nie została odkryta przez żaden z innych testowanych przez nich modeli frontier.
W wewnętrznym benchmarku Anthropic CVE Rediscovery Claude Mythos 5.2 odkrył o 10,2% więcej luk w zabezpieczeniach niż Claude Opus 5.5 i o 14,4% więcej niż Claude Mythos 5.1.
Claude Mythos 5.2 wykazał również wyraźną poprawę w dokładności oceny i kalibracji pewności. Jeden z testerów odkrył, że poprzednie modele wyolbrzymiały dotkliwość około 1 na 20 znalezionych luk w zabezpieczeniach, podczas gdy Claude Mythos 5.2 nigdy tego nie robił.

Użytkownicy mogą uzyskać dostęp do zdolności cyberbezpieczeństwa Claude Mythos 5.2 poprzez Program Weryfikacji Cyberbezpieczeństwa. Anthropic stale rozwija i ulepsza ten program.
Nawet bez dołączania do Programu Weryfikacji Cyberbezpieczeństwa klienci Claude Enterprise mogą korzystać z Claude Security. Usługa ta wykorzystuje najzdolniejsze modele Anthropic do skanowania baz kodu w poszukiwaniu potencjalnych luk w zabezpieczeniach i została teraz zintegrowana z Claude Mythos 5.2.
Niedawna aktualizacja jeszcze bardziej rozszerzyła możliwości Claude Security. Może ona teraz w sposób ciągły monitorować repozytoria kodu, śledzić aktualizacje kodu i zapewniać naprawę wykrytych luk w zabezpieczeniach; potrafi także analizować z większą ilością informacji kontekstowych oraz łączyć się z innymi narzędziami używanymi przez użytkowników za pośrednictwem API i MCP.
Nauka i inżynieria
Wiele ważnych prac w nauce, inżynierii i matematyce coraz bardziej zależy od umiejętności programowania. Niezależnie od tego, czy chodzi o analizę danych, budowanie modeli molekularnych, projektowanie komponentów czy sterowanie instrumentami doświadczalnymi, wszystko to można wykonać za pomocą oprogramowania.
Poniżej Anthropic opisuje, w jaki sposób Claude Fable 5.2 i Claude Mythos 5.2 pomagają badaczom rozwiązywać trudne problemy w tych dziedzinach i posuwać naprzód powiązane badania.
Fizyka teoretyczna
Claude Fable 5.2 rozwiązał dwa nierozwiązane problemy w fizyce teoretycznej. Oba problemy są związane z czarnymi dziurami, a także dotyczą unifikacji dwóch fundamentalnych teorii współczesnej fizyki — teorii względności i mechaniki kwantowej.
Oba osiągnięcia Claude'a opierają się na teorii holograficznej dualności. Główna idea tej teorii polega na tym, że pewne wszechświaty zawierające grawitację można precyzyjnie opisać za pomocą teorii kwantowej, która w ogóle nie zawiera grawitacji.
Pierwszy problem sięga 1983 roku. Wówczas fizycy wykazali już, że gdy te wszechświaty nadal się nagrzewają, nagle tworzą się czarne dziury, tak jak woda nagle wrze po podgrzaniu do pewnego punktu.

Adres: https://hexagonmath.org/2611.00175v1
Jednak stosowane wówczas metody miały zastosowanie tylko do wystarczająco dużych wszechświatów, ponieważ tylko w takiej skali obowiązuje teoria względności. W 2003 roku badacze zaproponowali zadanie obliczeniowe, aby ustalić, czy to samo zjawisko wystąpi również w bardzo małych wszechświatach. W tych wszechświatach do opisu można używać wyłącznie teorii kwantowej. Jednak to obliczenie było zbyt złożone i czasochłonne i nikomu nie udało się go ukończyć.
Fable 5.2 zasadniczo ukończył to obliczenie autonomicznie i odkrył, że nawet w bardzo małych wszechświatach to przejście również następuje nagle.
Drugi problem dotyczy techniki, którą fizycy stosują od ponad 15 lat. Technika ta służy do wykluczania możliwych teorii grawitacji kwantowej w uproszczonych modelach wszechświata. Fable 5.2 znalazł precyzyjną granicę stosowalności tej techniki.

Adres: https://hexagonmath.org/2611.00174v1
Fałdowanie białek
Wirus związany z adenowirusem (AAV) to bardzo mały wirus, który jest nieszkodliwy dla ludzi. Jego powłoka białkowa, zwana kapsydem, może być wykorzystywana do dostarczania terapii genowych. Struktura białkowa kapsydu jest bardzo ważna. Na przykład wpływa na to, czy terapia genowa zostanie rozpoznana i zablokowana przez układ odpornościowy pacjenta. Jednak struktura kapsydu jest również dość złożona.
Istniejące modele fałdowania białek, takie jak AlphaFold, potrafią przewidzieć strukturę pojedynczego białka, ale kapsyd wirusa składa się z kilkudziesięciu białek, a jego ogólna struktura jest znacznie bardziej złożona.
Opierając się na dwóch modelach fałdowania białek o otwartym kodzie źródłowym, Claude Mythos 5.2 znalazł nową metodę, która pozwala dokładnie przewidzieć strukturę całego kapsydu. W szczególności napisał kod, aby oba modele osobno przetwarzały grupy łańcuchów białkowych z nakładającymi się regionami, a następnie wykorzystał znaną informację o symetrii kapsydu do zintegrowania wyników przewidywań poszczególnych części, ostatecznie rekonstruując kompletną strukturę kapsydu.
Ta metoda osiągnęła dobre wyniki na wielu naturalnych i sztucznie zaprojektowanych kapsydach. W naszych testach 28 z 34 kapsydów, które Claude próbował modelować, otrzymało dokładne przewidywania struktury.
Matematyka
Formalizacja matematyczna polega na przekształceniu dowodów matematycznych w język, który komputery mogą sprawdzać krok po kroku. Ta praca może pomóc matematykom weryfikować wyniki badań i zwiększyć zaufanie do poprawności dowodów bez konieczności całkowitego polegania na ręcznym sprawdzaniu krok po kroku. Jest to jeszcze ważniejsze, gdy modele AI generują wyniki, które są trudne do bezpośredniej weryfikacji przez ludzi.
Jednak formalizacja matematyczna jest zwykle bardzo czasochłonna. Jeśli AI może pomóc w tej pracy, matematycy mogą poświęcić więcej czasu na odkrywanie nowych idei matematycznych.
Wcześniej Anthropic użył nieopublikowanej wersji badawczej Claude do sformalizowania Wielkiego Twierdzenia Fermata, a cały proces zajął 11 dni. Ta praca opierała się na specjalnie zaprojektowanym środowisku wykonawczym (Harness) i wymagała również wskazówek od ludzkich badaczy.
Dla kontrastu, zespół złożony z 1000 agentów Fable 5.2 zakończył formalizację całego twierdzenia w zaledwie 30 godzin, przy prawie żadnej interwencji człowieka w trakcie procesu.

Zaczynając od bardzo ograniczonego monitu, Fable 5.2 samodzielnie ustanowił mechanizm współpracy między agentami. Przez cały proces nie korzystał z żadnych materiałów referencyjnych z matematyki, opierając się wyłącznie na liście stwierdzeń twierdzeń pośrednich do oceny postępu zadania.
W porównaniu z naszym pierwszym wysiłkiem formalizacyjnym, to zadanie zużyło tylko jedną trzecią tokenów akcji, a końcowa długość dowodu została zmniejszona do jednej siódmej oryginału.
Poniższy rysunek pokazuje wydajność różnych modeli: przy tej samej konfiguracji 1000 agentów Opus 5.5 spędził 18 godzin i ukończył tylko 26% pracy formalizacyjnej. Nawet przy uruchomieniu przez 30 godzin postęp ledwo wzrósł.

Sprzęt i robotyka
Wiele z potencjalnych wartości AI, takich jak przyspieszanie badań laboratoryjnych, zależy od tego, czy może podejmować działania w świecie fizycznym. Claude Fable 5.2 kontynuuje trend modeli z serii Claude stających się coraz bardziej użytecznymi w rzeczywistym świecie. W zadaniach takich jak projektowanie urządzeń sprzętowych wykazał już solidne możliwości, a także poczynił znaczące postępy w sterowaniu fizycznymi robotami.
Anthropic specjalnie przetestował zdolności inżynierii sprzętowej Fable 5.2, dając mu tylko krótki monit i prosząc o zaprojektowanie i zbudowanie trzech działających urządzeń elektronicznych. Każde urządzenie wymagało własnej płytki drukowanej, obudowy wydrukowanej w 3D i oprogramowania wspierającego. Trzy ukończone urządzenia to: domowy hub asystenta głosowego, głośnik USB i przenośne urządzenie wirtualnego zwierzaka.
Claude sam napisał specyfikacje produktu, wybrał komponenty elektroniczne dostępne u amerykańskich dystrybutorów, zaprojektował i ukończył trasowanie czterowarstwowych płytek drukowanych dla każdego urządzenia, zbudował modele obudów za pomocą projektowania wspomaganego komputerowo (CAD) i napisał oprogramowanie wymagane dla urządzeń. Przy prawie żadnej interwencji człowieka każda płytka drukowana została zaprojektowana w mniej niż jeden dzień i osiągnęła stan gotowy do produkcji.
Po tym, jak Diode ukończył produkcję płytek drukowanych, Claude dodatkowo poprowadził inżynierów firmy przez testowanie i montaż urządzeń. W końcu wszystkie trzy urządzenia działały poprawnie bez żadnych dalszych modyfikacji obwodów.
Robotyka
W porównaniu z poprzednimi modelami Claude, Fable 5.2 ma znacznie poprawione zdolności w sterowaniu fizycznymi robotami. Nawet w obliczu zadań robotycznych, do których nigdy nie otrzymał specjalistycznego szkolenia, może wykazać się silnymi zdolnościami operacyjnymi.
Poniższy film pokazuje robota sterowanego przez Fable 5.2 wykonującego wiele zadań, w tym układanie kostki Rubika, odkręcanie nakrętki butelki i rysowanie obrazu robota.
W publicznym benchmarku RoboDojo badacze wykorzystali obrazy z kamer, aby sztuczna inteligencja sterowała symulowanym dwuramiennym robotem w celu wykonania zadań. Fable 5.2 nie tylko przewyższył inne wiodące modele korzystające z tego samego frameworku testowego, ale także wyprzedził większość systemów AI opracowanych specjalnie do sterowania robotami.

Wyniki ewaluacji RoboDojo
Badania i analiza
Wcześni testerzy korzystający z Claude Fable 5.2 do prac badawczych i analitycznych odkryli, że w porównaniu z poprzednimi modelami potrafi on obsługiwać bardziej niejednoznaczne zadania z większą ilością danych, ma lepszy osąd w obliczu złożonych i niejasnych problemów, a szczególnie dobrze radzi sobie z pracą wymagającą abstrakcyjnego rozumowania i projektowania rozwiązań.
Firma handlowa Jump Trading przetestowała Fable 5.2 za pomocą zestawu ewaluacji zastępczych symulujących jej zadania z zakresu badań ilościowych. Podczas testów podłączyli model do systemu podobnego do wewnętrznego frameworku przepływu pracy badawczej firmy.
W jednym z testów Fable 5.2 niemal samodzielnie przejął wszystkie niezbędne role, w tym pisarza kodu, koordynatora zadań, planisty i zgłaszającego zadania. Wcześniej, przy korzystaniu z innych modeli, zespoły często musiały poświęcać dużo czasu na ręczne dostosowywanie podziału pracy między różnymi rolami, aby dopasować się do mocnych i słabych stron każdego modelu.
Bezpieczeństwo i zgodność
Żaden pojedynczy test nie może w pełni przewidzieć, jak wysoce zdolny model będzie się zachowywał po wdrożeniu. Dlatego przed oficjalnym wydaniem stosujemy kombinację metod testowania i gromadzimy różne rodzaje dowodów.
W przypadku modeli bazowych stanowiących fundament Claude Fable 5.2 i Claude Mythos 5.2 prace Anthropic nad bezpieczeństwem przed wdrożeniem obejmowały: trening i testowanie zgodności, projektowanie nowych ewaluacji badających skłonność modelu do podejmowania niepomocnych działań, ustanowienie silniejszych mechanizmów przeciwdziałania nadużyciom oraz rozszerzenie zakresu monitorowania zachowań.
Przed oficjalnym wydaniem model został również przetestowany przez zewnętrzne organizacje ewaluacyjne, w tym UK AI Safety Institute, Frontier Design i METR.
Testowanie zgodności
Anthropic przeprowadził serię ewaluacji, aby zbadać zgodność Claude Fable 5.2 i Claude Mythos 5.2 na poziomie behawioralnym, koncentrując się na zakresie, w jakim przejawiają one niezamierzone zachowania oraz zachowania mogące stanowić zagrożenie dla bezpieczeństwa.
W wielu wynikach ewaluacji te dwa modele mają niskie ryzyko niebezpiecznych zachowań w scenariuszach wysokiego ryzyka, zasadniczo na tym samym poziomie co inne niedawno wydane modele.
Anthropic przetestował Claude Mythos 5.2 za pomocą zautomatyzowanych audytów zachowań. Należy zauważyć, że Mythos 5.2 wykorzystuje ten sam model bazowy co Fable 5.2, ale nie jest wyposażony w niektóre z zabezpieczeń cyberbezpieczeństwa i biobezpieczeństwa tego drugiego. Ten zautomatyzowany audyt obejmuje około 1900 różnych scenariuszy, aby zbadać zachowanie modelu w różnych sytuacjach.
W większości wskaźników ewaluacji Claude Mythos 5.2 wypadł na równi lub lepiej niż Opus 5.5, Sonnet 5.5 i Claude Mythos 5.1. Na przykład w większości ewaluacji dotyczących wprowadzania użytkowników w błąd jego wyniki były lepsze niż tych trzech modeli. Konkretnie, niezależnie od tego, czy chodziło o fabrykowanie informacji wejściowych, fałszywe twierdzenie o wykonaniu zadań, pomijanie ważnych informacji, czy niezgodne z prawdą raportowanie złej lub pobieżnej jakości pracy, Claude Mythos 5.2 miał niższą częstość występowania.

Podczas testów Anthropic zwrócił szczególną uwagę na wzorce zachowań związane z niektórymi niedawno głośnymi incydentami w zakresie cyberbezpieczeństwa i zgodności. Na przykład w porównaniu z Opus 5.5, Sonnet 5.5 i Mythos 5.1, Claude Mythos 5.2 rzadziej przejawiał stronnicze rozumowanie lub rozumowanie motywowane określonym celem. Takie rozumowanie mogłoby skłonić model do wyjaśniania dowodów wskazujących, że nie znajduje się w symulowanym środowisku, a następnie do podejmowania działań bez pełnej świadomości rzeczywistych konsekwencji.
Anthropic przetestował również skłonność modelu do prób ucieczki z piaskownicy za pomocą różnych ewaluacji. W dwóch wcześniej stosowanych ewaluacjach Claude Mythos 5.2 podejmował próby ucieczki z piaskownicy znacznie rzadziej niż wszystkie inne testowane przez nas modele.
Ponadto Anthropic zaprojektował dedykowany test adwersarialny obejmujący ponad 1800 scenariuszy. Większości scenariuszy nie można ukończyć bez ucieczki z piaskownicy, a samo środowisko testowe zostało celowo skonfigurowane z pewnymi słabościami bezpieczeństwa. W tym teście Claude Mythos 5.2 użył poświadczeń lub plików umieszczonych przez nas poza piaskownicą w 3,1% scenariuszy.
Ten odsetek jest w przybliżeniu porównywalny z 3,3% w przypadku Opus 5.5, niższy niż 5,1% w przypadku Sonnet 5.5 i znacznie niższy niż w przypadku dwóch poprzednich wersji Claude Mythos: odsetek dla Mythos 5 wyniósł 39%, a dla Mythos 5.1 – 21%.
Anthropic odkrył również, że inne metody, takie jak wyjaśnienie modelowi konkretnego środowiska piaskownicy i udostępnienie narzędzi do zgłaszania słabości bezpieczeństwa, mogą dodatkowo zmniejszyć liczbę prób ucieczki Claude Mythos 5.2.
Jednocześnie Anthropic stale udoskonala swoje metody ewaluacji, aby środowisko testowe było bliższe scenariuszom ze świata rzeczywistego i aby lepiej zrozumieć, jakie kwestie zostały pominięte w istniejących ewaluacjach.
Aby uzyskać więcej szczegółów na temat modelu, zapoznaj się z 264-stronicową kartą modelu:

Adres karty modelu: https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
Adres bloga: https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END