
Коротко:
Щойно розширивши вакансії для роботів, компанія тепер розпустила незалежну команду — що саме планує OpenAI?
13 листопада на Конференції з навчання роботів (CoRL), що проходила в Остіні, США, стенд 208, зарезервований OpenAI, був порожнім.
На карті стендів конференції OpenAI все ще був позначений, але жодного логотипу компанії чи демонстрації продукту не було видно.
Згодом OpenAI підтвердила Fortune, що розпустила свою незалежну дослідницьку команду з робототехніки.
Колишні дослідники робототехніки приєдналися до основного дослідницького відділу під керівництвом головного наукового співробітника Марка Чена, тоді як фахівці з застосувань робототехніки та апаратного забезпечення були переведені до відділу Applied під керівництвом президента Грега Брокмана.
Компанія заявила, що робототехніка залишається важливою частиною її довгострокового технологічного бачення, і це коригування має на меті прискорити прогрес досліджень і розробок.
Новина надійшла дещо несподівано.
У вересні цього року OpenAI все ще масштабно наймала дослідницький персонал з робототехніки, причому деякі посади пропонували базову зарплату до 500 000 доларів на рік. На початку року лабораторія збору даних для робототехніки компанії в Сан-Франциско вже налічувала близько 100 співробітників, і планувалася друга лабораторія.
Сем Альтман також публічно заявляв, що очікує можливості продемонструвати вражаючу демонстрацію робота у 2027 році.
Інвестуючи в лабораторії та наймаючи інженерів з апаратного забезпечення з одного боку, і розпускаючи незалежну дослідницьку команду з іншого — як саме OpenAI планує займатися робототехнікою? І куди підуть раніше інвестовані дослідницькі ресурси?
Скільки OpenAI інвестувала у сферу втіленого інтелекту?
Насправді OpenAI вже мала один попередній досвід розпуску команди з робототехніки.
У 2019 році компанія продемонструвала роботизовану руку Dactyl, яка розв'язувала кубик Рубіка. Дослідники використовували масштабне моделювання та навчання з підкріпленням, щоб робот опанував складні навички маніпулювання об'єктами.
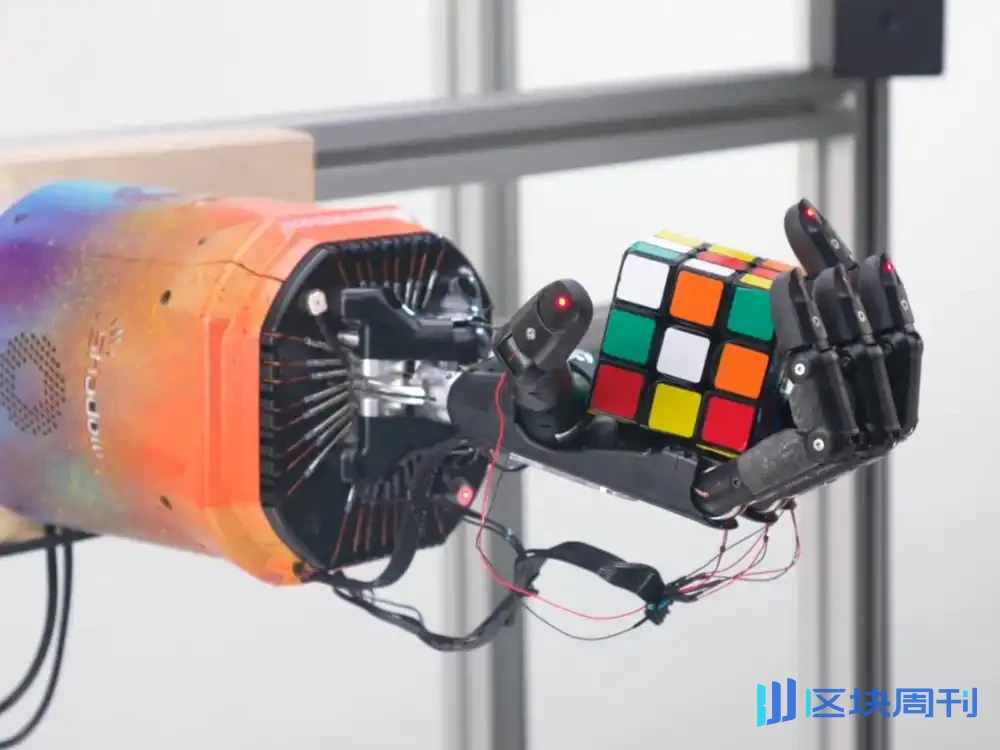
Зображення | У 2019 році OpenAI продемонструвала результати дослідження з керування роботизованою рукою для розв'язування кубика Рубіка за допомогою навчання з підкріпленням
У 2020 році OpenAI завершила свій перший раунд незалежних досліджень у робототехніці та перемістила більше уваги на масштабні мовні моделі. Цей шлях згодом породив ChatGPT.
У 2024 році компанія знову сформувала команду з робототехніки та об'єдналася з компанією з виробництва гуманоїдних роботів Figure для розробки моделей ШІ. Партнерство завершилося в лютому 2025 року: Figure перейшла до власних розроблених моделей роботів, тоді як OpenAI продовжила розширювати внутрішні дослідження та розробки.
У січні цього року Business Insider дослідила лабораторію збору даних для робототехніки OpenAI в Сан-Франциско. Лабораторія почала будівництво в лютому 2025 року і з того часу розширилася більш ніж у чотири рази, близько 100 співробітників зі збору даних працюють у три зміни.
Співробітники використовують надруковані на 3D-принтері контролери телеоперації GELLO для керування роботизованими руками Franka, щоб виконувати такі завдання, як складання одягу та вкладання хліба в тостер. Система записує сцени та процеси виконання операцій за допомогою камер, накопичуючи дані для навчання моделей роботів.
Ранні завдання в лабораторії були досить простими, зокрема вкладання гумової качки в чашку, і лише згодом складність операцій поступово зростала.
У звіті також згадується деталь: хоча в лабораторії був пристрій, схожий на гуманоїдного робота, основна робота зі збору даних все ще виконувалася за допомогою роботизованих рук.
OpenAI також планує побудувати другу лабораторію в Ричмонді, штат Каліфорнія.
Для компаній у сфері втіленого інтелекту збір даних є значними витратами. Мовні моделі можуть використовувати велику кількість тексту та зображень, уже доступних в інтернеті, тоді як роботам потрібно вивчати фізичні операції, такі як захоплення, контакт і переміщення. Завершення цього збору даних потребує обладнання, персоналу, обслуговування та управління на місці.
На той час OpenAI будувала власну систему виробництва даних, і масштаб найму також поступово розширювався.
У вересні цього року Business Insider підрахував, що кількість вакансій OpenAI, пов'язаних з робототехнікою, зросла з 11 у травні до 27, охоплюючи такі напрями, як машинне навчання, керування роботами, електронна інженерія, приводи, прошивки та збір даних, причому деякі посади пропонують базову зарплату до 500 000 доларів.
Станом на 14 листопада перевірка Phoenix Tech на офіційному сайті виявила, що OpenAI все ще публічно розміщує кілька інженерних посад, пов'язаних з робототехнікою.

Зображення | Станом на 14 листопада офіційний сайт OpenAI все ще набирав на посади, пов'язані з втіленим інтелектом, такі як бортові обчислення для роботів, програмне забезпечення для керування, двигуни та приводи
Раніше компанія також просувала підготовку ланцюга постачання. У січні цього року OpenAI оприлюднила план із залучення американських виробничих постачальників, включивши робототехніку разом із центрами обробки даних і споживчою електронікою до своєї схеми апаратного ланцюга постачання.
Сфера залучення охоплює такі ключові компоненти, як двигуни, редуктори, коробки передач і силова електроніка. Згідно з оригінальним документом, OpenAI планує відібрати постачальників у 2027 році, але ще не розкрила суму відповідних закупівельних контрактів.
Окрім інженерних досліджень і розробок, фінансові домовленості щодо робототехнічного бізнесу також увійшли до управлінських обговорень.
У травні цього року The Wall Street Journal повідомила, що Сем Альтман розглядав можливість ведення робототехнічного та споживчого апаратного бізнесу незалежно, дозволяючи відповідним компаніям залучати кошти окремо від зовнішніх інвесторів.
План зрештою не було реалізовано. Однією з причин було те, що навіть якби бізнес було виділено, відповідні активи та прибутки й збитки все одно могли б потребувати включення до консолідованої фінансової звітності групи OpenAI.
Ці записи показують, що протягом минулого року інвестиції OpenAI у сферу робототехніки вже охоплювали збір даних, дослідження моделей, апаратну інженерію та підготовку ланцюга постачання.
Після підтвердження реструктуризації 13 листопада OpenAI ще не оголосила конкретних розподілів бюджету, персоналу та обчислювальних потужностей, а також не заявила, чи будуть коригуватися лабораторія збору даних і прототипні проєкти.

Ван Сінсін заявив, що найбільшою помилкою за останні понад десять років було недостатньо вірити в ШІ
OpenAI пояснила виданню Fortune технічний контекст цього коригування. На початку цього року дослідники компанії спочатку вважали, що використання моделей генерації відео, таких як Sora, для вивчення законів фізичного світу є важливим шляхом до просування інтелекту роботів.
Але загальні моделі, такі як GPT-6 Astra, згодом продемонстрували здатність безпосередньо керувати роботами. OpenAI вирішила об'єднати відповідних дослідників у команду загальних фундаментальних моделей, дозволивши дослідженням робототехніки скористатися останніми досягненнями існуючих моделей.
Дві промови засновника Unitree Technology Ван Сінсіна за минулий місяць також узгоджуються з цією тенденцією.
12 жовтня під час круглого столу на Шанхайській промисловій виставці Ван Сінсін сказав, що після випуску GPT-6 Unitree вже інтегрувала її в різних роботів для виконання завдань, і фактичні результати перевершили попередні очікування.
Він відверто визнав: «Найбільша помилка, яку я зробив за останні понад десять років, полягає в тому, що я недостатньо вірив у ШІ».

Зображення | 22 жовтня 2026 року Ван Сінсін поділився прогресом у керуванні роботами загальними великими моделями на Всесвітній конференції з фізичного ШІ. Джерело зображення: The Paper
Ван Сінсін вважає, що моделі ШІ демонструють помітний прогрес майже кожні один-два місяці. Якщо GPT-7 продовжить робити прориви, технологічна точка перелому для втіленого інтелекту може настати протягом наступних одного-двох років.
22 жовтня на Всесвітній конференції з фізичного ШІ він знову продемонстрував експеримент, у якому робот Unitree використав GPT-6 для завершення малювання. Перед роботом були зразок картини, білий папір, фарба та чиста вода. Він узяв пензель, щоб малювати, змінював кольори в процесі, а також самостійно мив пензель. Unitree також продемонструвала такі завдання, як гра робота в шахи.
Ван Сінсін неодноразово наголошував, що команда не проводила спеціалізованого навчання для цих завдань і не писала складних програм руху.
Сам робот усе ще потребує систем керування рухом і апаратного забезпечення, але загальна модель уже здатна організовувати деякі операційні кроки на основі візуальної інформації та вимог завдання.
Раніше багато завдань роботів вимагали від розробників збору спеціалізованих демонстрацій рухів, а потім навчання відповідних операційних політик. Тепер загальні моделі можуть виконувати частину роботи з візуального розуміння, просторового міркування та планування завдань.
Нещодавно випущена Anthropic Claude Fable 5.2 також надала експериментальні дані.
9 листопада Anthropic продемонструвала процес, у якому Claude керував роботизованою рукою, щоб розв'язати кубик Рубіка, відкрутити кришку пляшки та малювати.
У симуляційному бенчмарку RoboDojo Sim тести, проведені внутрішньо Anthropic, показали, що Fable 5.2 досягла середнього рівня успіху 64,9% порівняно з 27,6% для попереднього покоління Fable 5.1, тоді як GPT-6 Astra набрав 29,8% у тому самому тестовому фреймворку.

Зображення | Симуляційна оцінка RoboDojo Sim, опублікована Anthropic, у якій Claude Fable 5.2 досягла оцінки 64,9%. Джерело зображення: Anthropic
Дослідження NVIDIA Astranomy, опубліковане в жовтні, безпосередньо використовувало GPT-6 Astra для керування симульованими роботами.
У тесті RoboLab-120 підхід прямого керування досяг успішності виконання завдань 66,3%. Після того як дослідники додали такі механізми, як безперервна фіксація історії операцій та перевірка результатів виконання, підхід агентного керування досяг 74,8%, що вище за попередню найкращу спеціалізовану роботизовану модель на цьому бенчмарку, яка набрала 51,0%.
Хоча ці експерименти використовували різні тестові середовища, усі вони продемонстрували прогрес універсальних моделей у фізичному маніпулюванні.
Гуанья Ши, дослідник робототехніки в Університеті Карнегі-Меллона, сказав в інтерв'ю Fortune, що OpenAI, можливо, розглядає робототехніку як прикладний напрямок універсального інтелекту.
Для OpenAI пряме використання універсальних моделей означає, що частина досліджень робототехнічного інтелекту може використовувати результати навчання базових моделей. Тому рентабельність інвестицій у самостійну розробку набору фундаментальних моделей для роботів також потребує переоцінки.
Однак експеримент NVIDIA також виявив іншу проблему: обчислювальні витрати універсальних моделей досить високі.
У дослідженні Astranomy підхід прямого керування GPT-6 Astra займав у середньому 18,56 секунди на один висновок.
Хоча агентний підхід підвищив успішність, кожен успішний епізод завдання споживав у середньому близько 30,9 мільйона токенів, що відповідає орієнтовній вартості API у 36,40 доларів США.
Ці витрати походять із симуляційного тестування і не можуть безпосередньо розглядатися як операційні витрати реальних роботів. Але на реальних фабриках чим довше робот виконує завдання, тим вищою може бути вартість на одиницю продукції.
Що ще проблематичніше, так це затримка. Симуляційне середовище може призупинятися під час висновку моделі, але конвеєрні стрічки, обладнання та заготовки на реальних фабриках не зупинятимуться й не чекатимуть понад десять секунд.
Роботам усе ще потрібні системи, які реагують швидше і можуть безпосередньо керувати рухами тіла. Це також одна з причин, чому інші технологічні компанії продовжують навчати спеціалізовані роботизовані моделі.

Google, Nvidia та Unitree все ще навчають спеціалізовані моделі
10 листопада Google DeepMind оголосила про експеримент, у якому гуманоїдний робот Apollo 2 працював на заводі Mercedes-Benz.
Робот бере металеві кронштейни з бункерів і розміщує їх у призначені контейнери відповідно до виробничого порядку. Місця тестування включали заводи Mercedes-Benz у Зіндельфінгені (Німеччина) та Кечкеметі (Угорщина). Google оголосила, що успішність цього завдання сортування деталей досягла 96%.

Зображення | Гуманоїдний робот Apollo 2 проходить тести сортування деталей на автомобільному заводі Mercedes-Benz, джерело зображення: Google DeepMind
Під час роботи два набори моделей виконують кожен свої обов'язки.
Gemini Robotics ER відповідає за розуміння виробничого процесу та оцінку прогресу завдання; Gemini Robotics 2.5, навчена на рухах роботів, відповідає за фактичне керування руками та спритними кистями. Google також використовувала Gemini 4 Argon для допомоги у створенні симуляційних середовищ та аналізі випадків невдач.
Генеральний директор Apptronik Джефф Карденас сказав, що Apollo 2 продемонстрував значне покращення після кількох тижнів додаткового навчання, а після переведення на виробничу лінію Mercedes-Benz зниження продуктивності було відносно невеликим.
Це підтвердження концепції в обмеженому сценарії, і рівень відмов та виробничі витрати довгострокової експлуатації ще не розкриті. Але Google вже продемонстрував, як загальна модель міркування та спеціалізована модель дій можуть працювати разом для виконання заводських завдань.
GR00T 2 від Nvidia, випущений у листопаді, зосереджується на витратах на навчання після того, як роботи потрапляють у нові сценарії.

Зображення | GR00T 2 зчитує найсвіжіше відео, інструкції та стан робота, виконує шумозаглушення на майбутніх відео- та дієвих сегментах, виконує цей дієвий сегмент, а потім повторює цей процес
У 50 завданнях, для яких цільовий робот раніше не навчався, GR00T 2 досяг середнього рівня успіху zero-shot 40%. Дослідники додали 5 демонстраційних операцій і менше 3 хвилин даних робота для кожного завдання, а потім донавчали близько 30 хвилин за допомогою одного RTX 5090, підвищивши рівень успіху до 95%.
Коли роботи прибувають на новий завод, їм часто потрібно знову адаптуватися до розміщення предметів, порядку захоплення та конкретного обладнання. Можливість завершити адаптацію до завдання за допомогою невеликої кількості демонстрацій може зменшити інвестиції в збір даних, налагодження на місці та присутність інженерів.
Але роботам все ще доводиться вирішувати фізичні помилки в точних операціях.
5 листопада Ван Сінсін згадав на форумі Hongqiao Китайського міжнародного імпортного експо, що поточні провідні мультимодальні моделі вже мають сильні здібності до розуміння та планування, але такі завдання, як вставка деталей, все ще схильні застрягати на останніх кількох міліметрах.
Підняття коробки може витримати певне відхилення положення, тоді як вставка роз'єму повинна враховувати кут, тертя та контактну силу. Незначне відхилення в русі може пошкодити заготовку.
Nvidia провела навчання з підкріпленням на реальних машинах для цих завдань. В опублікованих експериментах навчений робот досяг 94% успіху в завданнях вставки кабелю та 96% у вставці зарядного пристрою.
Unitree та AgiBot також продовжують навчати власні моделі роботів. Публічно випущений Unitree UnifoLM-WLA-1.0 використовує близько 2500 годин даних реальних машин, тоді як AgiBot продовжує інвестувати в дані експлуатації роботів і пост-навчання через GO-3 Preview та Genie Evolver.
У типовому завданні точного складання загальна модель може зрозуміти операційні вимоги та впорядкувати послідовність виконання, тоді як спеціалізована модель дій повинна навчитися, як різні роботизовані руки наближаються до деталей, регулюють положення та обробляють контактний зворотний зв'язок. Для безперервної роботи також потрібна базова система керування для своєчасного оброблення аномалій.
Такий розподіл праці не вимагає від кожної компанії навчати з нуля набір базових моделей, відповідальних за розуміння та планування. Робототехнічні компанії можуть використовувати зовнішні моделі, а потім навчати дієві здібності для своїх власних тіл, завдань клієнтів і даних на місці.
Для OpenAI об'єднання досліджень робототехніки в команду GPT — це саме вибір вирішувати більше проблем робототехнічного інтелекту в рамках загальної модельної системи. Уже створені можливості збору даних і досліджень та розробки апаратного забезпечення можна потім використовувати для перевірки ефектів цих моделей на реальних роботах.
(Заголовне зображення цієї статті згенеровано ШІ)
Ця стаття з публічного акаунта WeChat: Phoenix Tech , автор: Phoenix Tech, редактор: Дун Юйцін, оригінальна назва: "Щойно запропонувавши річну зарплату в 3,3 мільйона юанів, щоб переманити таланти, OpenAI раптово розпустила свою команду робототехніки — чи галузь збирається змінитися!"





