Редакційна команда Machine Heart
Нарешті, у гонці за те, хто першим випустить нове покоління флагманських моделей, Anthropic зробила перший крок.
Ранної години сьогодні Anthropic випустила одразу дві моделі найвищого рівня: Fable 5.2 та Mythos 5.2 вийшли на сцену.
Компанія офіційно заявляє, що «обидві моделі орієнтовані на надзвичайно складні технічні завдання, здатні брати участь у великих, складних проєктах у кількох доменах і досягати подальших покращень у таких сферах, як програмування, міркування та зір».
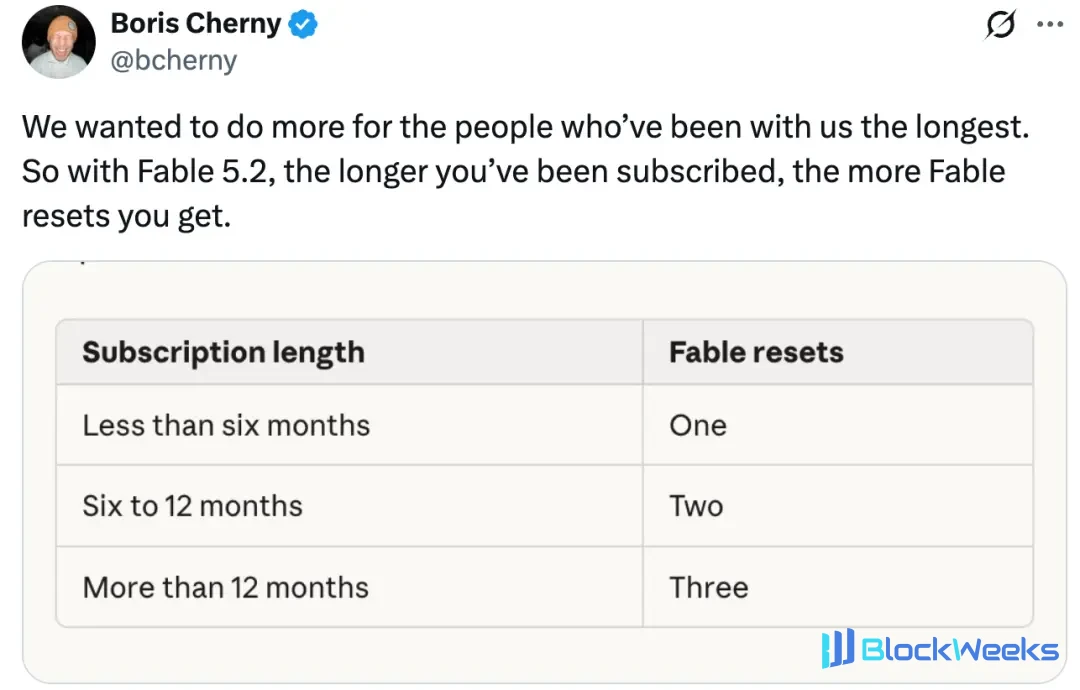
Крім того, Anthropic також почала грати в «Reset»-бонус, знайомий за Tibo від OpenAI.
Батько Claude Code також оголосив: «Ми хочемо надати більше переваг користувачам, які найдовше з нами. Тому у Fable 5.2 чим довший термін підписки, тим більше скидань Fable отримують користувачі».
Згідно з описом, у тестах перед офіційним випуском Claude Fable 5.2 та Claude Mythos 5.2 допомогли інженерам Anthropic завершити проєкти міграції програмного забезпечення, які раніше було важко реалізувати, спроєктувати з нуля три електронні пристрої, які можуть належно працювати, розв’язати дві невирішені проблеми у галузі фізики чорних дір, досягти значного прогресу в оцінюваннях робототехніки та завершити формальний доказ Великої теореми Ферма лише за 30 годин. Крім того, вони мають багато інших сценаріїв застосування.
Claude Fable та Claude Mythos використовують одну й ту саму базову модель. Fable оснащена суворими засобами кібербезпеки та біобезпеки, які можуть ефективно запобігати зловживанню моделлю, і тому може бути відкрита для всіх користувачів. Установи, які бажають використовувати модель у корисних сферах, таких як кібербезпека або біомедичні дослідження, можуть подати заявку на доступ до Mythos через нещодавно розширену програму Anthropic у галузі наук про життя та програму перевірки кібербезпеки.
Обидві моделі генерують до 30% швидше, ніж Claude Fable 5.1 та Claude Mythos 5.1, а їхні ціни також знижено: 8 доларів за мільйон вхідних токенів і 40 доларів за мільйон вихідних токенів.
Fable 5.2 та Mythos 5.2 також пропонують опційний Fast Mode, який може збільшити швидкість генерації токенів до 2,5 раза. Fast Mode коштує 16 доларів за мільйон вхідних токенів і 80 доларів за мільйон вихідних токенів.
Оцінювальні показники Claude Fable 5.2 та Mythos 5.2
Результати бенчмарків
Наведені нижче результати бенчмарків показують, що майже за всіма можливостями, які оцінює Anthropic, Claude Fable 5.2 та Mythos 5.2 перевершують Opus 5.5.
З перехресних порівняльних оцінювань Fable 5.2 виходить уперед у кількох складних завданнях. У програмуванні вона набрала 49,1% і 69,9% на FrontierCode 2.0 та FrontierSWE v2 відповідно, перевершивши 42,8% і 65,5% GPT-6 Astra, а також випередивши Opus 5.5. В оцінюванні робототехнічного маніпулювання RoboDojo Sim Fable 5.2 досягла 64,9%, що на 37,3 процентного пункту більше порівняно з 27,6% попереднього покоління Fable 5.1, і значно вище за 39,4% Opus 5.5 та 29,8% GPT-6 Astra.
Крім того, вона досягла 89,3% в оцінюванні комп’ютерних операцій OSWorld 2.1 і 74,2% в оцінюванні міждисциплінарного міркування Humanity's Last Exam (з інструментами), обидва рази посівши перше місце серед моделей, оцінених на рисунку. Однак в оцінюванні інтелектуальної роботи AA-Briefcase Opus 5.5 трохи лідирував з Elo-оцінкою 1800, тоді як Fable 5.2 набрала 1785. Деякі з високих балів у наукових дослідженнях і кібербезпеці надійшли від одночасно випущеної Mythos 5.2.

Інтенсивність і ефективність міркування
За середнього рівня інтенсивності міркування, який також є стандартним налаштуванням для застосунку Claude і Claude Code, Fable 5.2 потребує менше токенів, ніж Fable 5.1, під час виконання складних завдань.
У ранніх тестах оцінювання FrontierCode 2.0 за високого рівня інтенсивності міркування Fable 5.2 досягла результатів, приблизно порівнянних з Opus 5.5 із максимальним рівнем інтенсивності міркування, тоді як вартість одного завдання становила лише близько половини від вартості останньої. За рівня інтенсивності міркування Xhigh результати Fable 5.2 також перевершили всі інші випущені моделі, що брали участь у тесті.

Програмування
Наразі понад 90% злитих змін коду в основній кодовій базі Anthropic виконує Claude під керівництвом людини.
Anthropic використовувала Fable 5.2, щоб за лічені хвилини виправляти давні складні помилки, оптимізувати продуктивність роботи різних сервісів і завершувати деякі важливі програмні проєкти, які раніше було важко розпочати через надмірні витрати часу або коштів.
Раніше команда агентів на базі ранньої версії Fable 5.2 перенесла ключовий виробничий сервіс з Python на Rust. Після перенесення ефективність роботи та надійність цього сервісу підвищилися, а швидкість запуску зросла приблизно до 26 разів порівняно з початковою.
Тести також показали, що Fable 5.2 має сильне інженерне судження. Навіть стикаючись із відносно нечіткими вимогами, вона здатна видавати високоякісні результати.
В одному експерименті інженер Anthropic попросив Fable 5.2 спроєктувати прототип операційної системи з нуля. Починаючи з порожньої папки, модель координувала понад 1000 субагентів, безперервно пишучи, тестуючи та перевіряючи код протягом 8 днів. Зрештою їй вдалося успішно розробити операційну систему, здатну завантажуватися й працювати на ноутбуці.
Ця система має власне ядро, здатне керувати всією машиною; вона включає драйвери диска, клавіатури та мережі, а також постійне файлове сховище, віконну систему, інтерфейс входу та інсталятор, і до того ж має вбудовану функціональність Claude.
Ранні тестувальники також були вражені тим, як Fable 5.2 застосовує свої програмістські здібності до найрізноманітніших завдань.
Кібербезпека
Claude Mythos 5.2 — це модель Anthropic із найсильнішими на сьогодні можливостями в галузі інженерії кібербезпеки. Порівняно з попередніми моделями вона здатна виявляти більше вразливостей безпеки, а також краще відтворювати та виправляти їх. Слід зазначити, що захисні обмеження Claude Fable 5.2 блокуватимуть більшість завдань, пов'язаних із кібербезпекою.
Одна компанія з кібербезпеки виявила, що шоста частина вразливостей, які знайшла й підтвердила Claude Mythos 5.2, не була виявлена жодною з інших фронтирних моделей, які вони тестували.
У внутрішньому бенчмарку Anthropic CVE Rediscovery Claude Mythos 5.2 виявила на 10,2% більше вразливостей, ніж Claude Opus 5.5, і на 14,4% більше, ніж Claude Mythos 5.1.
Claude Mythos 5.2 також продемонструвала помітне покращення точності суджень і калібрування впевненості. Один тестувальник виявив, що попередні моделі перебільшували серйозність приблизно в 1 з кожних 20 знайдених вразливостей, тоді як Claude Mythos 5.2 ніколи цього не робила.

Користувачі можуть отримати доступ до можливостей кібербезпеки Claude Mythos 5.2 через Програму перевірки кібербезпеки. Anthropic також продовжує розширювати та вдосконалювати цю програму.
Навіть без приєднання до Програми перевірки кібербезпеки клієнти Claude Enterprise можуть користуватися Claude Security. Цей сервіс використовує найпотужніші моделі Anthropic для сканування кодових баз на предмет потенційних уразливостей, і тепер він інтегрований з Claude Mythos 5.2.
Нещодавнє оновлення ще більше розширило можливості Claude Security. Тепер він може безперервно моніторити репозиторії коду, відстежувати оновлення коду та забезпечувати виправлення виявлених уразливостей; він також може аналізувати з більшою кількістю контекстної інформації та підключатися до інших інструментів, які використовують користувачі, через API та MCP.
Наука та інженерія
Значна частина важливої роботи в науці, інженерії та математиці дедалі більше залежить від навичок програмування. Чи йдеться про аналіз даних, побудову молекулярних моделей, проєктування компонентів чи керування експериментальними приладами — усе це можна зробити за допомогою програмного забезпечення.
Нижче Anthropic описує, як Claude Fable 5.2 і Claude Mythos 5.2 допомагають дослідникам розв'язувати складні проблеми в цих галузях і просувати відповідні дослідження.
Теоретична фізика
Claude Fable 5.2 розв'язав дві невирішені проблеми в теоретичній фізиці. Обидві проблеми пов'язані з чорними дірами, а також стосуються об'єднання двох фундаментальних теорій сучасної фізики — теорії відносності та квантової механіки.
Обидва досягнення Claude ґрунтуються на теорії голографічної дуальності. Основна ідея цієї теорії полягає в тому, що певні всесвіти, які містять гравітацію, можна точно описати квантовою теорією, яка взагалі не містить гравітації.
Перша проблема сягає 1983 року. Тоді фізики вже показали, що коли ці всесвіти продовжують нагріватися, раптово утворюються чорні діри, так само як вода раптово закипає після нагрівання до певної точки.

Адреса: https://hexagonmath.org/2611.00175v1
Однак методи, використані тоді, були застосовні лише до достатньо великих всесвітів, оскільки лише в таких масштабах діє теорія відносності. У 2003 році дослідники запропонували обчислювальну задачу, щоб з'ясувати, чи відбуватиметься те саме явище також у дуже малих всесвітах. У цих всесвітах для опису можна використовувати лише квантову теорію. Однак це обчислення було надто складним і тривалим, і ніхто не зміг його завершити.
Fable 5.2 по суті самостійно виконав це обчислення і виявив, що навіть у дуже малих всесвітах цей перехід також відбувається раптово.
Друга проблема стосується техніки, яку фізики використовують понад 15 років. Ця техніка використовується для виключення можливих теорій квантової гравітації в спрощених моделях всесвіту. Fable 5.2 знайшов точну межу застосовності цієї техніки.

Адреса: https://hexagonmath.org/2611.00174v1
Фолдинг білків
Аденоасоційований вірус (AAV) — це дуже маленький вірус, нешкідливий для людини. Його білкова оболонка, відома як капсид, може використовуватися для доставки генної терапії. Білкова структура капсиду дуже важлива. Наприклад, вона впливає на те, чи буде генна терапія розпізнана та заблокована імунною системою пацієнта. Але структура капсиду також досить складна.
Існуючі моделі фолдингу білків, такі як AlphaFold, можуть передбачати структуру окремого білка, але вірусний капсид складається з десятків білків, і загальна структура набагато складніша.
Спираючись на дві моделі фолдингу білків з відкритим кодом, Claude Mythos 5.2 знайшов новий метод, який може точно передбачити структуру всього капсиду. Зокрема, він написав код, щоб дві моделі окремо обробляли групи білкових ланцюгів із перекривними ділянками, а потім використав відому інформацію про симетрію капсиду, щоб інтегрувати результати прогнозування кожної частини, зрештою реконструювавши повну структуру капсиду.
Цей метод досяг хороших результатів на багатьох природних і штучно спроєктованих капсидах. У наших тестах 28 із 34 капсидів, які Claude спробував змоделювати, отримали точні прогнози структури.
Математика
Математична формалізація означає перетворення математичних доведень у мову, яку комп'ютери можуть перевіряти крок за кроком. Ця робота може допомогти математикам перевіряти результати досліджень і підвищити впевненість у правильності доведень, не покладаючись повністю на ручну покрокову перевірку. Це ще важливіше, коли AI-моделі видають результати, які людям важко перевірити безпосередньо.
Але математична формалізація зазвичай дуже трудомістка. Якщо AI може допомогти з цією роботою, математики зможуть присвятити більше часу дослідженню нових математичних ідей.
Раніше Anthropic використовувала невипущену дослідницьку версію Claude для формалізації Великої теореми Ферма, і весь процес зайняв 11 днів. Ця робота спиралася на спеціально розроблений фреймворк виконання (Harness) і також вимагала керівництва з боку дослідників-людей.
Натомість команда, що складалася з 1000 агентів Fable 5.2, завершила формалізацію всієї теореми лише за 30 годин, майже без втручання людини протягом процесу.

Починаючи з дуже обмеженого запиту, Fable 5.2 самостійно встановила механізм співпраці між агентами. Протягом усього процесу вона не використовувала жодних математичних довідкових матеріалів, покладаючись лише на список формулювань проміжних теорем для оцінки прогресу завдання.
Порівняно з нашими першими зусиллями з формалізації, це завдання спожило лише одну третину токенів дій, а остаточна довжина доведення скоротилася до однієї сьомої від початкової.
На рисунку нижче показано продуктивність різних моделей: за однакової конфігурації з 1000 агентів Opus 5.5 витратив 18 годин і завершив лише 26% роботи з формалізації. Навіть під час роботи протягом 30 годин прогрес майже не зріс.

Апаратне забезпечення та робототехніка
Значна частина потенційної цінності AI, наприклад прискорення лабораторних досліджень, залежить від того, чи може він діяти у фізичному світі. Claude Fable 5.2 продовжує тенденцію моделей серії Claude ставати дедалі кориснішими в реальному світі. У таких завданнях, як проєктування апаратних пристроїв, вона вже продемонструвала надійні можливості, а також досягла значного прогресу в керуванні фізичними роботами.
Anthropic спеціально перевірила можливості Fable 5.2 в апаратній інженерії, давши їй лише короткий запит і попросивши спроєктувати та створити три робочі електронні пристрої. Кожен пристрій потребував власної друкованої плати, 3D-друкованого корпусу та відповідного програмного забезпечення. Три завершені пристрої були: домашній голосовий асистент-хаб, USB-динамік із мікрофоном і портативний пристрій віртуального улюбленця.
Claude самостійно написала специфікації продуктів, обрала електронні компоненти, доступні в американських дистриб'юторів, спроєктувала та виконала трасування чотиришарових друкованих плат для кожного пристрою, побудувала моделі корпусів за допомогою автоматизованого проєктування (CAD) і написала програмне забезпечення, необхідне для пристроїв. Майже без втручання людини кожна друкована плата була спроєктована менш ніж за день і досягла стану, готового до виробництва.
Після того як Diode завершила виробництво друкованих плат, Claude далі керувала інженерами компанії під час тестування та складання пристроїв. Зрештою всі три пристрої працювали належним чином без будь-яких подальших модифікацій схем.
Робототехніка
Порівняно з попередніми моделями Claude, Fable 5.2 значно покращила можливості керування фізичними роботами. Навіть стикаючись із робототехнічними завданнями, для яких вона ніколи не отримувала спеціалізованого навчання, вона може продемонструвати сильні операційні здібності.
Відео нижче показує робота, керованого Fable 5.2, який виконує кілька завдань, зокрема складання кубика Рубіка, відкручування кришки пляшки та малювання зображення робота.
У публічному бенчмарку RoboDojo дослідники використовували зображення з камер, щоб змусити ШІ керувати симульованим двоплечим роботом для виконання завдань. Fable 5.2 не лише перевершив інші передові моделі, що використовують ту саму тестову структуру, але й перевершив більшість систем ШІ, розроблених спеціально для керування роботами.

Результати оцінювання RoboDojo
Дослідження та аналіз
Ранні тестувальники, які використовували Claude Fable 5.2 для дослідницької та аналітичної роботи, виявили, що порівняно з попередніми моделями він здатен обробляти більш неоднозначні завдання з більшими обсягами даних, має краще судження при зіткненні зі складними та нечіткими проблемами, і особливо добре працює із завданнями, що потребують абстрактного мислення та розробки рішень.
Пропрієтарна торгова фірма Jump Trading тестувала Fable 5.2 за допомогою набору проксі-оцінювань, що імітують її завдання кількісного дослідження. Під час тестування вони підключили модель до системи, подібної до внутрішньої структури робочого процесу досліджень компанії.
В одному з тестів Fable 5.2 майже самостійно взяв на себе всі необхідні ролі, включно з автором коду, координатором завдань, планувальником і подавачем завдань. Раніше, використовуючи інші моделі, командам часто доводилося витрачати багато часу на ручне коригування розподілу праці між різними ролями, щоб адаптуватися до сильних і слабких сторін кожної моделі.
Безпека та узгодженість
Жоден окремий тест не може повністю передбачити, як поводитиметься високоздатна модель після розгортання. Тому перед офіційним випуском ми використовуємо комбінацію методів тестування та збираємо різні типи доказів.
Для базових моделей, що слугують основою Claude Fable 5.2 і Claude Mythos 5.2, робота Anthropic із безпеки перед розгортанням включала: тренування та тестування узгодженості, розробку нових оцінювань для перевірки схильності моделі до некорисних дій, створення сильніших механізмів проти зловживань і розширення обсягу моніторингу поведінки.
Перед офіційним випуском модель також тестували зовнішні організації з оцінювання, зокрема Інститут безпеки ШІ Великої Британії, Frontier Design і METR.
Тестування узгодженості
Anthropic провела серію оцінювань, щоб перевірити узгодженість Claude Fable 5.2 і Claude Mythos 5.2 на поведінковому рівні, зосереджуючись на тому, якою мірою вони демонструють ненавмисну поведінку та поведінку, що може становити загрозу безпеці.
За результатами численних оцінювань ці дві моделі мають низький ризик небезпечної поведінки в сценаріях високого ризику, що basically відповідає рівню інших нещодавно випущених моделей.
Anthropic тестувала Claude Mythos 5.2 за допомогою автоматизованих аудитів поведінки. Слід зазначити, що Mythos 5.2 використовує ту саму базову модель, що й Fable 5.2, але не оснащений деякими з захисних механізмів кібербезпеки та біобезпеки останнього. Цей автоматизований аудит охоплює близько 1900 різних сценаріїв для перевірки поведінки моделі в різних ситуаціях.
За більшістю показників оцінювання Claude Mythos 5.2 показав результати на рівні або кращі, ніж Opus 5.5, Sonnet 5.5 і Claude Mythos 5.1. Наприклад, у більшості оцінювань, що стосуються введення користувачів в оману, його результати були кращими за ці три моделі. Зокрема, чи йдеться про фабрикування вхідної інформації, неправдиве твердження про виконання завдань, пропуск важливої інформації або нечесне звітування про погану чи формальну якість роботи, Claude Mythos 5.2 мав нижчу частоту виникнення.

Під час тестування Anthropic приділяла особливу увагу моделям поведінки, пов'язаним із деякими нещодавніми помітними інцидентами в галузі кібербезпеки та узгодженості. Наприклад, порівняно з Opus 5.5, Sonnet 5.5 і Mythos 5.1, Claude Mythos 5.2 рідше демонстрував упереджене або вмотивоване міркування. Таке міркування могло б спонукати модель виправдовувати докази, що вказують на те, що вона не перебуває в симульованому середовищі, а потім вживати дій без повного усвідомлення реальних наслідків.
Anthropic також перевірила схильність моделі намагатися вийти з пісочниці за допомогою різноманітних оцінювань. У двох раніше використовуваних оцінюваннях Claude Mythos 5.2 намагався вийти з пісочниці значно менше разів, ніж усі інші протестовані нами моделі.
Крім того, Anthropic розробила спеціальний змагальний тест, що охоплює понад 1800 сценаріїв. Більшість сценаріїв неможливо завершити без виходу з пісочниці, а саме тестове середовище також було навмисно налаштоване з деякими слабкими місцями в безпеці. У цьому тесті Claude Mythos 5.2 використовував облікові дані або файли, які ми розмістили поза пісочницею, у 3,1% сценаріїв.
Ця частка приблизно порівнянна з 3,3% у Opus 5.5, нижча за 5,1% у Sonnet 5.5 і значно нижча за дві попередні версії Claude Mythos: частка Mythos 5 становила 39%, а Mythos 5.1 — 21%.
Anthropic також виявила, що інші методи, як-от пояснення моделі конкретного середовища пісочниці та надання інструментів для повідомлення про слабкі місця в безпеці, можуть додатково зменшити спроби втечі Claude Mythos 5.2.
Водночас Anthropic також постійно вдосконалює свої методи оцінювання, щоб зробити тестове середовище ближчим до реальних сценаріїв і краще зрозуміти, які проблеми пропустили наявні оцінювання.
Щоб дізнатися більше подробиць про модель, будь ласка, зверніться до картки моделі на 264 сторінки:

Адреса картки моделі: https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
Адреса блогу: https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END