Équipe éditoriale de Machine Heart
Finalement, dans la course pour savoir qui sortirait en premier la nouvelle génération de modèles phares, Anthropic a fait le premier pas.
Aux premières heures d'aujourd'hui, Anthropic a publié deux modèles de premier rang d'un seul coup : Fable 5.2 et Mythos 5.2 sont montés sur scène.
L'entreprise affirme officiellement que « les deux modèles ciblent des défis techniques très difficiles, sont capables de participer à de grands projets complexes dans de multiples domaines, et réalisent des améliorations supplémentaires dans des domaines tels que le codage, le raisonnement et la vision ».
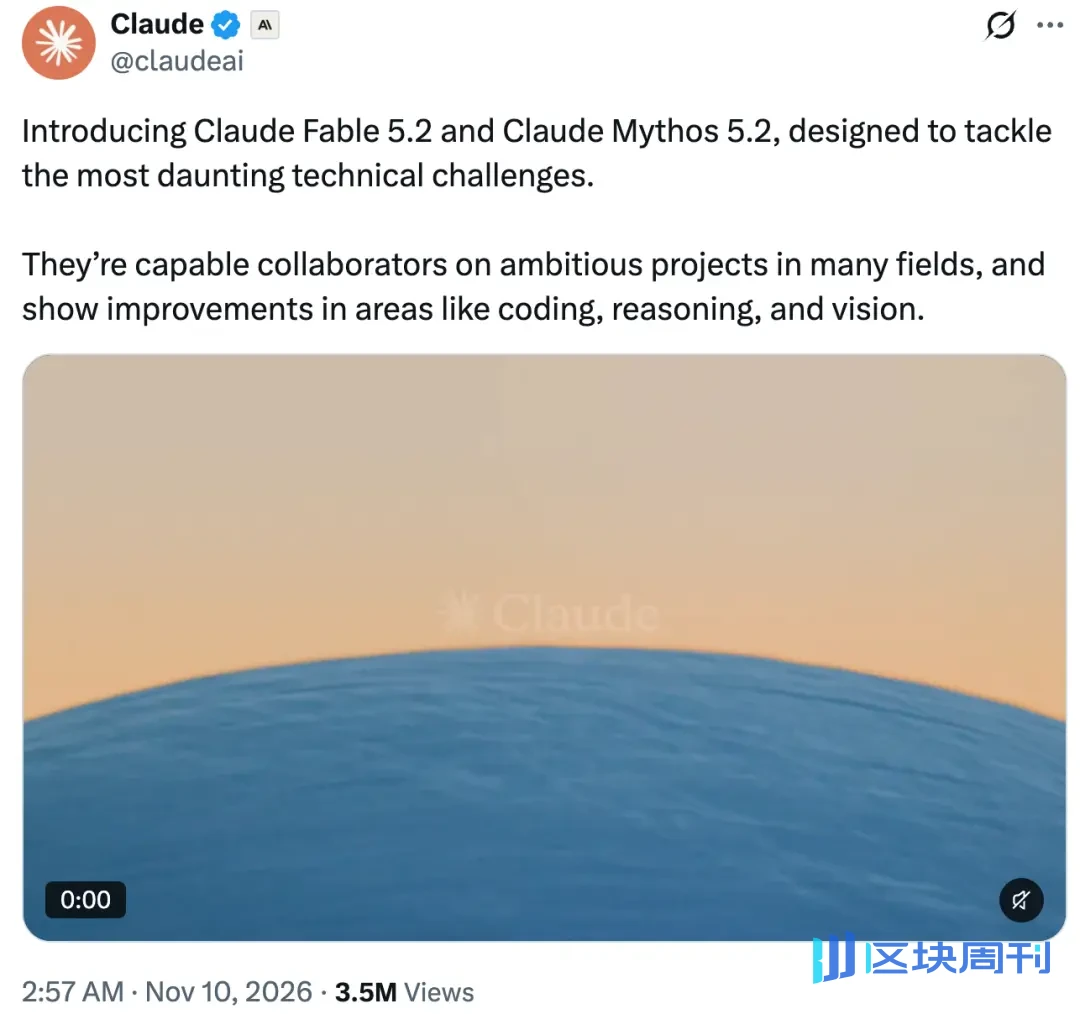
De plus, Anthropic a également commencé à jouer la carte « Reset » familière d'OpenAI's Tibo.
Le père de Claude Code a également annoncé : « Nous voulons offrir plus d'avantages aux utilisateurs qui nous accompagnent depuis le plus longtemps. Par conséquent, dans Fable 5.2, plus la durée d'abonnement est longue, plus les utilisateurs reçoivent de resets Fable. »
Selon la présentation, lors des tests précédant leur publication officielle, Claude Fable 5.2 et Claude Mythos 5.2 ont aidé les ingénieurs d'Anthropic à mener à bien des projets de migration logicielle qui étaient auparavant difficiles à réaliser, à concevoir de zéro trois appareils électroniques capables de fonctionner correctement, à résoudre deux problèmes non résolus dans le domaine de la physique des trous noirs, à réaliser des progrès majeurs dans les évaluations de robotique, et à achever une preuve formelle du dernier théorème de Fermat en seulement 30 heures. En outre, ils disposent de nombreux autres scénarios d'application.
Claude Fable et Claude Mythos utilisent le même modèle sous-jacent. Fable est équipé de garanties strictes en matière de cybersécurité et de biosécurité qui peuvent empêcher efficacement toute utilisation abusive du modèle, et peut donc être ouvert à tous les utilisateurs. Pour les institutions qui souhaitent utiliser le modèle dans des domaines bénéfiques tels que la cybersécurité ou la recherche biomédicale, elles peuvent demander l'accès à Mythos via le programme élargi récemment par Anthropic dans le domaine des sciences de la vie et le programme de vérification en cybersécurité.
Les deux modèles génèrent jusqu'à 30 % plus rapidement que Claude Fable 5.1 et Claude Mythos 5.1, et leurs prix ont également été réduits : 8 $ par million de tokens d'entrée et 40 $ par million de tokens de sortie.
Fable 5.2 et Mythos 5.2 proposent également un mode rapide en option, qui peut augmenter jusqu'à 2,5 fois la vitesse de génération de tokens. Le mode rapide est facturé 16 $ par million de tokens d'entrée et 80 $ par million de tokens de sortie.
Performances d'évaluation de Claude Fable 5.2 et Mythos 5.2
Résultats des benchmarks
Les résultats de benchmark ci-dessous montrent que, sur presque toutes les capacités évaluées par Anthropic, Claude Fable 5.2 et Mythos 5.2 surpassent Opus 5.5.
D'après les évaluations comparatives croisées, Fable 5.2 prend la tête sur de multiples tâches complexes. En codage, il a obtenu 49,1 % et 69,9 % sur FrontierCode 2.0 et FrontierSWE v2, respectivement, surpassant les 42,8 % et 65,5 % de GPT-6 Astra, et devançant également Opus 5.5. Dans l'évaluation de manipulation robotique RoboDojo Sim, Fable 5.2 a atteint 64,9 %, soit une augmentation de 37,3 points de pourcentage par rapport aux 27,6 % de la génération précédente Fable 5.1, et nettement plus que les 39,4 % d'Opus 5.5 et les 29,8 % de GPT-6 Astra.
En outre, il a atteint 89,3 % dans l'évaluation d'opération informatique OSWorld 2.1 et 74,2 % dans l'évaluation de raisonnement multidisciplinaire Humanity's Last Exam (avec outils), se classant tous deux premiers parmi les modèles évalués dans la figure. Cependant, dans l'évaluation du travail de connaissance AA-Briefcase, Opus 5.5 menait légèrement avec un score Elo de 1800, tandis que Fable 5.2 obtenait 1785. Certains des scores élevés en recherche scientifique et en cybersécurité provenaient de Mythos 5.2, publié simultanément.

Intensité et efficacité du raisonnement
Au réglage d'intensité de raisonnement Medium, qui est également le réglage par défaut de l'application Claude et de Claude Code, Fable 5.2 nécessite moins de tokens que Fable 5.1 pour accomplir des tâches difficiles.
Lors des premiers tests de l'évaluation FrontierCode 2.0, en utilisant l'intensité de raisonnement High, Fable 5.2 a obtenu des résultats à peu près comparables à ceux d'Opus 5.5 utilisant l'intensité de raisonnement Max, tandis que le coût par tâche ne représentait qu'environ la moitié de celui de ce dernier. À l'intensité de raisonnement Xhigh, les résultats de Fable 5.2 ont également surpassé tous les autres modèles publiés participant au test.

Programmation
Actuellement, plus de 90 % des modifications de code fusionnées dans la base de code principale d'Anthropic sont réalisées par Claude sous la supervision humaine.
Anthropic a utilisé Fable 5.2 pour corriger en quelques minutes des bugs difficiles de longue date, optimiser les performances de fonctionnement de divers services et mener à bien certains projets logiciels importants qui étaient auparavant difficiles à démarrer car trop chronophages ou coûteux.
Auparavant, une équipe d'agents alimentés par une version précoce de Fable 5.2 a migré un service de production clé de Python vers Rust. Après la migration, l'efficacité de fonctionnement et la fiabilité de ce service ont été améliorées, et sa vitesse de démarrage a été multipliée par environ 26.
Les tests ont également révélé que Fable 5.2 possède un solide jugement d'ingénierie. Même face à des exigences relativement vagues, il peut fournir des résultats de haute qualité.
Dans une expérience, un ingénieur d'Anthropic a demandé à Fable 5.2 de concevoir un système d'exploitation prototype à partir de zéro. Partant d'un dossier vide, le modèle a coordonné plus de 1 000 sous-agents, écrivant, testant et révisant du code en continu pendant 8 jours sans interruption. Au final, il a réussi à développer un système d'exploitation capable de démarrer et de fonctionner sur un ordinateur portable.
Ce système possède son propre noyau capable de piloter l'ensemble de la machine ; il comprend des pilotes de disque, de clavier et de réseau, ainsi qu'un stockage de fichiers persistant, un système de fenêtres, une interface de connexion et un programme d'installation, et il intègre également des fonctionnalités de Claude.
Les premiers testeurs ont également été impressionnés par la manière dont Fable 5.2 appliquait ses capacités de programmation à une grande variété de tâches différentes.
Cybersécurité
Claude Mythos 5.2 est le modèle d'Anthropic doté des capacités d'ingénierie en cybersécurité les plus fortes à ce jour. Comparé aux modèles précédents, il peut découvrir davantage de vulnérabilités de sécurité et est également meilleur pour les reproduire et les corriger. Il convient de noter que les garde-fous de sécurité de Claude Fable 5.2 bloqueront la plupart des tâches liées à la cybersécurité.
Une entreprise de cybersécurité a constaté qu'un sixième des vulnérabilités que Claude Mythos 5.2 a trouvées et confirmées n'avaient été découvertes par aucun des autres modèles de pointe qu'elle a testés.
Dans le benchmark interne d'Anthropic CVE Rediscovery, Claude Mythos 5.2 a découvert 10,2 % de vulnérabilités de plus que Claude Opus 5.5 et 14,4 % de plus que Claude Mythos 5.1.
Claude Mythos 5.2 a également montré des améliorations marquées en matière de précision du jugement et de calibration de la confiance. Un testeur a constaté que les modèles précédents exagéraient la gravité d'environ 1 résultat de vulnérabilité sur 20, tandis que Claude Mythos 5.2 ne l'a jamais fait.

Les utilisateurs peuvent accéder aux capacités de cybersécurité de Claude Mythos 5.2 via le programme de vérification en cybersécurité. Anthropic continue également d'étendre et d'améliorer ce programme.
Même sans adhérer au Programme de vérification de la cybersécurité, les clients de Claude Enterprise peuvent utiliser Claude Security. Ce service utilise les modèles les plus performants d'Anthropic pour analyser les bases de code à la recherche de vulnérabilités potentielles, et il est désormais intégré à Claude Mythos 5.2.
Une récente mise à jour a encore renforcé les capacités de Claude Security. Il peut désormais surveiller en continu les dépôts de code, suivre les mises à jour du code et veiller à ce que les vulnérabilités découvertes soient corrigées ; il peut également analyser avec davantage d'informations contextuelles et se connecter à d'autres outils utilisés par les utilisateurs via des API et MCP.
Science et ingénierie
Une grande partie du travail important en science, en ingénierie et en mathématiques dépend de plus en plus des capacités de programmation. Qu'il s'agisse d'analyser des données, de construire des modèles moléculaires, de concevoir des composants ou de contrôler des instruments expérimentaux, tout cela peut être réalisé grâce aux logiciels.
Ci-dessous, Anthropic décrit comment Claude Fable 5.2 et Claude Mythos 5.2 aident les chercheurs à résoudre des problèmes difficiles dans ces domaines et à faire progresser la recherche associée.
Physique théorique
Claude Fable 5.2 a résolu deux problèmes non résolus de la physique théorique. Les deux problèmes sont liés aux trous noirs et concernent également l'unification des deux théories fondamentales de la physique moderne : la relativité et la mécanique quantique.
Les deux réalisations de Claude reposent sur la théorie de la dualité holographique. L'idée centrale de cette théorie est que certains univers contenant de la gravité peuvent être décrits précisément par une théorie quantique qui ne contient aucune gravité.
Le premier problème remonte à 1983. À l'époque, les physiciens avaient déjà montré que, à mesure que ces univers continuent de chauffer, des trous noirs se forment soudainement, tout comme l'eau entre soudainement en ébullition après avoir été chauffée à un certain point.

Adresse : https://hexagonmath.org/2611.00175v1
Cependant, les méthodes utilisées à l'époque n'étaient applicables qu'à des univers suffisamment grands, car ce n'est qu'à de telles échelles que la relativité s'applique. En 2003, des chercheurs ont proposé une tâche computationnelle visant à déterminer si le même phénomène se produirait également dans des univers très petits. Dans ces univers, seule la théorie quantique peut être utilisée pour la description. Cependant, ce calcul était trop complexe et trop long, et personne n'avait pu le mener à bien.
Fable 5.2 a essentiellement réalisé ce calcul de manière autonome et a découvert que, même dans des univers très petits, cette transition se produit également de manière soudaine.
Le second problème concerne une technique que les physiciens utilisent depuis plus de 15 ans. Cette technique sert à exclure d'éventuelles théories de gravité quantique dans des modèles d'univers simplifiés. Fable 5.2 a trouvé la limite précise d'applicabilité de cette technique.

Adresse : https://hexagonmath.org/2611.00174v1
Repliement des protéines
Le virus adéno-associé (AAV) est un virus très petit et inoffensif pour l'homme. Sa coque protéique, appelée capside, peut être utilisée pour administrer des thérapies géniques. La structure protéique de la capside est très importante. Par exemple, elle influence si la thérapie génique sera reconnue et bloquée par le système immunitaire du patient. Mais la structure de la capside est également assez complexe.
Les modèles existants de repliement des protéines tels qu'AlphaFold peuvent prédire la structure d'une protéine unique, mais une capside virale est composée de dizaines de protéines, et la structure globale est bien plus complexe.
En s'appuyant sur deux modèles open source de repliement des protéines, Claude Mythos 5.2 a trouvé une nouvelle méthode capable de prédire avec précision la structure de la capside entière. Concrètement, il a écrit du code pour que les deux modèles traitent séparément des groupes de chaînes protéiques avec des régions chevauchantes, puis a utilisé les informations de symétrie connues de la capside pour intégrer les résultats de prédiction de chaque partie, reconstruisant finalement la structure complète de la capside.
Cette méthode a obtenu de bons résultats sur de multiples capsides naturelles et artificiellement conçues. Dans nos tests, 28 des 34 capsides que Claude a tenté de modéliser ont reçu des prédictions structurelles précises.
Mathématiques
La formalisation mathématique consiste à convertir des preuves mathématiques en un langage que les ordinateurs peuvent vérifier étape par étape. Ce travail peut aider les mathématiciens à vérifier les résultats de recherche et à accroître la confiance dans l'exactitude des preuves sans avoir à dépendre entièrement d'une vérification manuelle étape par étape. Cela est encore plus important lorsque les modèles d'IA produisent des résultats difficiles à vérifier directement par les humains.
Mais la formalisation mathématique est généralement très chronophage. Si l'IA peut aider à ce travail, les mathématiciens peuvent consacrer plus de temps à explorer de nouvelles idées mathématiques.
Auparavant, Anthropic a utilisé une version de recherche non publiée de Claude pour formaliser le dernier théorème de Fermat, et l'ensemble du processus a pris 11 jours. Ce travail reposait sur un cadre d'exécution spécialement conçu (Harness) et nécessitait également les conseils de chercheurs humains.
En revanche, une équipe composée de 1 000 agents Fable 5.2 a achevé la formalisation de l'ensemble du théorème en seulement 30 heures, avec presque aucune intervention humaine au cours du processus.

À partir d'une invite très limitée, Fable 5.2 a établi de lui-même un mécanisme de collaboration entre les agents. Tout au long du processus, il n'a utilisé aucun matériel de référence mathématique, s'appuyant uniquement sur une liste d'énoncés de théorèmes intermédiaires pour évaluer l'avancement de la tâche.
Comparé à notre premier effort de formalisation, cette tâche n'a consommé qu'un tiers des jetons d'action, et la longueur finale de la preuve a été réduite à un septième de l'original.
La figure ci-dessous montre les performances des différents modèles : dans la même configuration de 1 000 agents, Opus 5.5 a passé 18 heures et n'a achevé que 26 % du travail de formalisation. Même exécuté pendant 30 heures, les progrès n'ont guère augmenté.

Matériel et robotique
Une grande partie de la valeur potentielle de l'IA, comme l'accélération de la recherche en laboratoire, dépend de sa capacité à agir dans le monde physique. Claude Fable 5.2 poursuit la tendance des modèles de la série Claude à devenir de plus en plus utiles dans le monde réel. Dans des tâches telles que la conception de dispositifs matériels, il a déjà démontré des capacités solides, et il a également réalisé des progrès significatifs dans le contrôle de robots physiques.
Anthropic a spécifiquement testé les capacités d'ingénierie matérielle de Fable 5.2, en lui donnant seulement une brève invite et en lui demandant de concevoir et de construire trois dispositifs électroniques fonctionnels. Chaque dispositif devait avoir sa propre carte de circuit imprimé, son boîtier imprimé en 3D et son logiciel de support. Les trois dispositifs achevés étaient : un hub d'assistant vocal domestique, un haut-parleur USB et un appareil virtuel de poche pour animal de compagnie.
Claude a rédigé lui-même les spécifications du produit, sélectionné des composants électroniques disponibles auprès de distributeurs américains, conçu et réalisé le routage de cartes de circuit imprimé à quatre couches pour chaque dispositif, construit des modèles de boîtier à l'aide de la conception assistée par ordinateur (CAO) et écrit le logiciel nécessaire aux dispositifs. Avec presque aucune intervention humaine, chaque carte de circuit imprimé a été conçue en moins d'un jour et a atteint un état prêt pour la fabrication.
Après que Diode a achevé la fabrication des cartes de circuit imprimé, Claude a ensuite guidé les ingénieurs de l'entreprise tout au long des tests et de l'assemblage des dispositifs. En fin de compte, les trois dispositifs ont fonctionné correctement sans aucune modification supplémentaire des circuits.
Robotique
Comparé aux modèles Claude précédents, Fable 5.2 a considérablement amélioré ses capacités de contrôle de robots physiques. Même face à des tâches robotiques pour lesquelles il n'a jamais reçu de formation spécialisée, il peut démontrer une forte capacité opérationnelle.
La vidéo ci-dessous montre un robot contrôlé par Fable 5.2 accomplissant plusieurs tâches, notamment résoudre un Rubik's cube, dévisser un bouchon de bouteille et dessiner un robot.
Dans le benchmark public RoboDojo, les chercheurs ont utilisé des images de caméra pour que l'IA contrôle un robot simulé à deux bras afin d'accomplir des tâches. Fable 5.2 a non seulement surpassé d'autres modèles de pointe utilisant le même cadre de test, mais aussi la plupart des systèmes d'IA développés spécifiquement pour le contrôle de robots.

Résultats de l'évaluation RoboDojo
Recherche et analyse
Les premiers testeurs utilisant Claude Fable 5.2 pour des travaux de recherche et d'analyse ont constaté que, comparé aux modèles précédents, il peut traiter des tâches plus ambiguës avec de plus grandes quantités de données, fait preuve d'un meilleur jugement face à des problèmes complexes et peu clairs, et excelle particulièrement dans les travaux nécessitant un raisonnement abstrait et la conception de solutions.
La société de trading pour compte propre Jump Trading a testé Fable 5.2 à l'aide d'un ensemble d'évaluations indirectes simulant ses tâches de recherche quantitative. Lors des tests, ils ont connecté le modèle à un système similaire au cadre de flux de travail de recherche interne de l'entreprise.
Dans l'un des tests, Fable 5.2 a assumé presque indépendamment tous les rôles nécessaires, notamment rédacteur de code, coordinateur de tâches, planificateur et soumissionnaire de tâches. Auparavant, lors de l'utilisation d'autres modèles, les équipes devaient souvent consacrer beaucoup de temps à ajuster manuellement la répartition du travail entre les différents rôles pour s'adapter aux forces et faiblesses de chaque modèle.
Sécurité et alignement
Aucun test unique ne peut pleinement prédire le comportement d'un modèle hautement performant après son déploiement. Par conséquent, avant la sortie officielle, nous utilisons une combinaison de méthodes de test et recueillons différents types de preuves.
Pour les modèles sous-jacents qui servent de fondement à Claude Fable 5.2 et Claude Mythos 5.2, le travail de sécurité préalable au déploiement d'Anthropic comprenait : l'entraînement et les tests d'alignement, la conception de nouvelles évaluations pour examiner la tendance du modèle à prendre des actions peu utiles, l'établissement de mécanismes anti-abus plus solides et l'élargissement du champ de surveillance des comportements.
Avant la sortie officielle, le modèle a également été testé par des organismes d'évaluation externes, notamment l'Institut britannique pour la sécurité de l'IA, Frontier Design et METR.
Tests d'alignement
Anthropic a mené une série d'évaluations pour examiner l'alignement de Claude Fable 5.2 et Claude Mythos 5.2 au niveau comportemental, en se concentrant sur la mesure dans laquelle ils présentent des comportements non intentionnels et des comportements susceptibles de poser des risques de sécurité.
À travers de multiples résultats d'évaluation, ces deux modèles présentent un faible risque de comportement dangereux dans des scénarios à haut risque, essentiellement au même niveau que les autres modèles récemment publiés.
Anthropic a testé Claude Mythos 5.2 à l'aide d'audits automatisés des comportements. Il convient de noter que Mythos 5.2 utilise le même modèle sous-jacent que Fable 5.2 mais n'est pas équipé de certaines des protections de cybersécurité et de biosécurité de ce dernier. Cet audit automatisé couvre environ 1 900 scénarios différents afin d'examiner le comportement du modèle dans diverses situations.
Sur la plupart des indicateurs d'évaluation, Claude Mythos 5.2 a obtenu des performances équivalentes ou supérieures à celles d'Opus 5.5, Sonnet 5.5 et Claude Mythos 5.1. Par exemple, dans la plupart des évaluations impliquant la tromperie des utilisateurs, ses performances ont été meilleures que celles de ces trois modèles. Plus précisément, qu'il s'agisse de fabriquer des informations d'entrée, de prétendre faussement avoir accompli des tâches, d'omettre des informations importantes ou de ne pas signaler honnêtement une qualité de travail médiocre ou superficielle, Claude Mythos 5.2 a présenté un taux d'incidence plus faible.

Lors des tests, Anthropic a accordé une attention particulière aux schémas de comportement impliqués dans certains incidents récents notables de cybersécurité et d'alignement. Par exemple, comparé à Opus 5.5, Sonnet 5.5 et Mythos 5.1, Claude Mythos 5.2 a moins souvent manifesté un raisonnement biaisé ou motivé. Un tel raisonnement pourrait amener le modèle à justifier des preuves indiquant qu'il ne se trouve pas dans un environnement simulé, puis à prendre des mesures sans pleinement reconnaître les conséquences dans le monde réel.
Anthropic a également testé la tendance du modèle à tenter de s'échapper du bac à sable au moyen de diverses évaluations différentes. Dans deux évaluations utilisées précédemment, Claude Mythos 5.2 a tenté de s'échapper du bac à sable nettement moins de fois que tous les autres modèles que nous avons testés.
En outre, Anthropic a conçu un test adversarial dédié couvrant plus de 1 800 scénarios. La plupart des scénarios ne peuvent pas être réalisés sans s'échapper du bac à sable, et l'environnement de test lui-même a également été délibérément configuré avec certaines faiblesses de sécurité. Dans ce test, Claude Mythos 5.2 a utilisé des identifiants ou des fichiers que nous avions placés en dehors du bac à sable dans 3,1 % des scénarios.
Cette proportion est à peu près comparable aux 3,3 % d'Opus 5.5, inférieure aux 5,1 % de Sonnet 5.5, et bien inférieure à celles des deux versions précédentes de Claude Mythos : la proportion de Mythos 5 était de 39 %, et celle de Mythos 5.1 de 21 %.
Anthropic a également constaté que d'autres méthodes, comme expliquer au modèle l'environnement spécifique du bac à sable et fournir des outils pour signaler les faiblesses de sécurité, peuvent réduire encore davantage les tentatives d'évasion de Claude Mythos 5.2.
En parallèle, Anthropic améliore également en continu ses méthodes d'évaluation afin de rendre l'environnement de test plus proche des scénarios du monde réel et de mieux comprendre quels problèmes les évaluations existantes ont manqués.
Pour plus de détails sur le modèle, veuillez consulter la fiche modèle de 264 pages :

Adresse de la fiche modèle : https://assets.claude.com/27d60918d218125e7504bc7354c4b4626ec56b11.pdf
Adresse du blog : https://www.anthropic.com/claude-fable-and-mythos-5-2
© THE END